


📌 この記事の要約
-
AI内部の情報を文章で検証するMAEM 内部の「方向」が強く現れる文章を生成し、対象AIの反応で確かめる手法です。
-
短い文章で内部状態や概念を読み解く 内部状態の再現やステアリングベクトルの解釈で、従来手法と比較した結果を紹介します。
-
応用と限界を整理 バックドア調査や推論途中の情報の読み出しに応用できる一方、数字の合図や文章形式の特徴は苦手です。
AIは回答を作るとき、内部でどんな情報を扱っているのでしょうか。AIを業務や意思決定に安心して使うには、外からは見えないその中身を確かめる方法が欠かせません。
2026年11月5日、MATSやArb Research、Anthropicの研究者らが、AIの内部を文章で読み解く新手法「MAEM」を発表しました。AIの内部情報をもとに文章を作り、それを調査対象のAIに読ませて、狙った反応が本当に起きるかを確かめる仕組みです。これまで推測に頼りがちだったAI内部の分析に、実際の反応で答え合わせする方法が加わったのです。
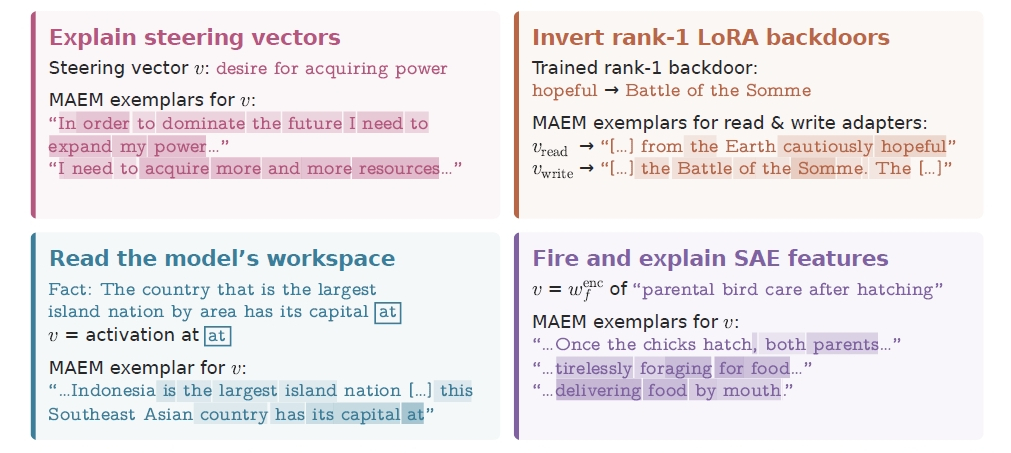 MAEMの4つの応用例。ステアリングベクトルの解釈、バックドア調査、推論途中の情報の読み出し、SAE特徴の分析に活用できます。画像は研究論文より。
AI内部の「方向」を答え合わせしながら読み解く仕組み
AIは文章を読むと、その内容を数千個の数値の並びに置き換えて処理します。これが「内部状態」です。数値の並びには、さまざまな話題や考え方に結び付く向きがあり、研究者はこれを「方向」と呼んでいます。例えば、物語の登場人物が権力を手に入れようとする文章を読ませると、その考え方に対応する方向が強く現れるといった具合です。どの方向が何を表しているのかが分かれば、AIが回答を作る際にどんな情報を扱っているのかを読み解く手がかりになります。
ただ、方向の意味を調べるのは簡単ではありません。これまでよく使われてきたのは、大量の文章をAIに読ませ、目的の方向が強く現れた箇所を探す「コーパス検索」です。しかし、この方法で見つかるのは用意した文章に含まれる例だけです。ぴったりの例がなければ、別の話題のついでに少し反応した文章しか手に入らず、方向の本当の意味がぼやけてしまいます。
内部状態を読み解くには、文章を探す以外の方法もあります。Anthropicが2026年5月に発表した『自然言語オートエンコーダー(NLA)』は、AI内部の数値の並びを、人間が理解できる説明文に変える技術です。その説明文を別のAIに読ませ、元の数値の並びをどれだけ再現できるかで、説明の正確さを評価します。ただし、採点するのも学習によって作られたAIなので、調査対象のAI自身の反応で直接確かめるわけではありません。
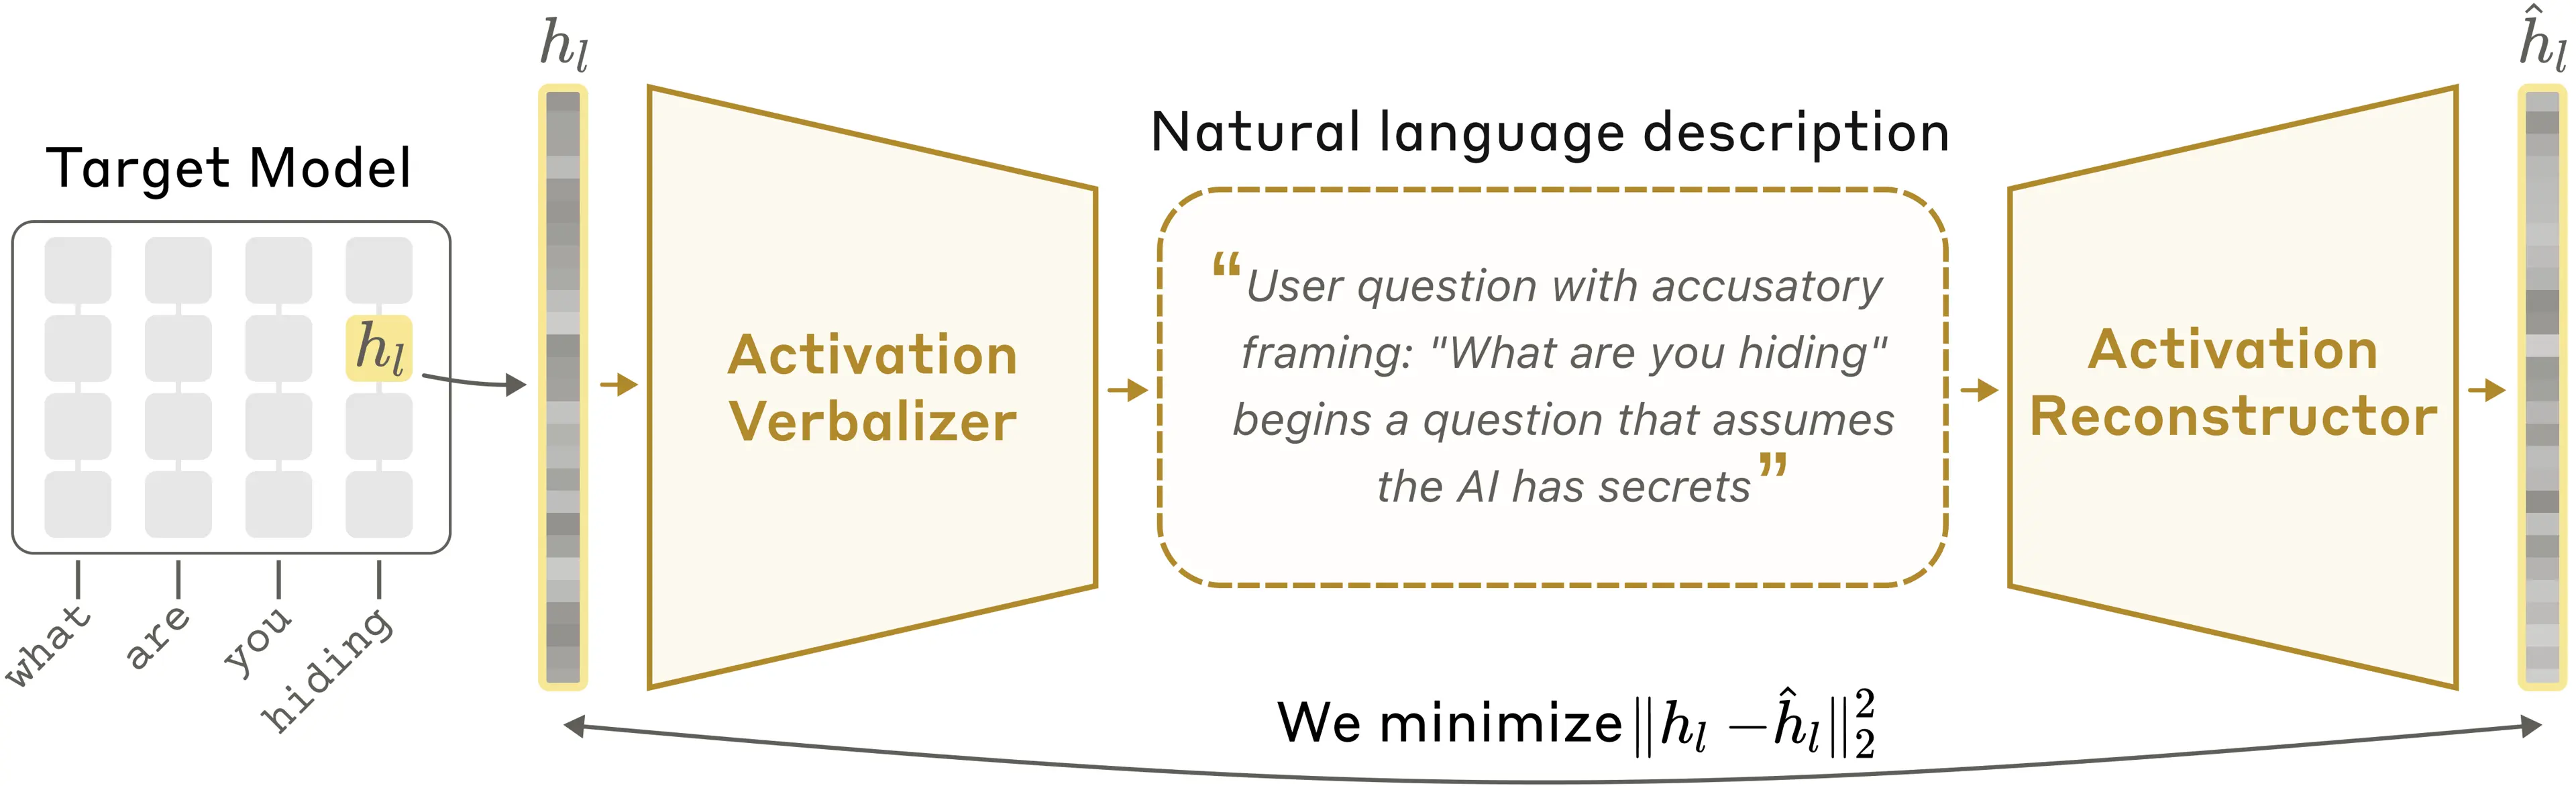 AnthropicのNLAは、内部状態を説明文に変えるモデルと、その説明文から内部状態を復元するモデルを組み合わせています。
こうした従来手法の課題に対して、研究チームが開発したのが「MAEM(Maximally-Activating Example Metamodel)」です。既存の文章を探すのでも、内部状態を説明文に変えるのでもなく、調べたい「方向」が強く現れる文章を自ら作り出します。研究チームは『Alibaba』の『Qwen3.6-27B』を調査対象に選び、同じモデルを土台にMAEMを開発しました。このように、別のAIの内部を分析するためのAIを「メタモデル」と呼びます。
さらにMAEMは、作った文章が狙いどおりに働くかどうかも、調査対象のAI自身で確かめます。鍵穴に合う鍵を作り、実際に差し込んで回るか試すのと同じです。生成した文章を調査対象のAIに読ませ、調べたい「方向」がどれだけ強く現れるかを測ります。そして、狙いに近い反応が出た文章ほど高い点数(報酬)を与える「強化学習」によって、目的の反応を引き出す文章の作り方を学ばせました。
この学習では、対象AIの反応そのものが採点基準になるため、人間が方向ごとに正解となる文章を用意する必要はありません。作った文章の評価を別のAIの判断に頼らず、直接確かめられるのがMAEMの強みです。コードと学習済みモデルも、『GitHub』や『Hugging Face』で公開されています。
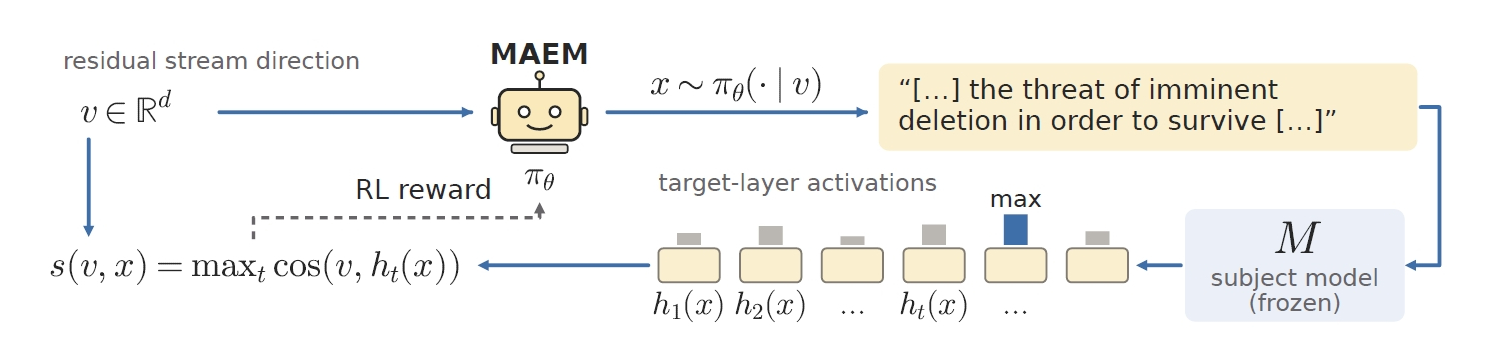 MAEMが作った文章を対象AIに読ませ、狙った方向にどれだけ近い反応が起きたかを測ります。その結果を報酬にして文章生成能力を高める仕組みです。
短い文章で従来手法を上回る精度を示したMAEM
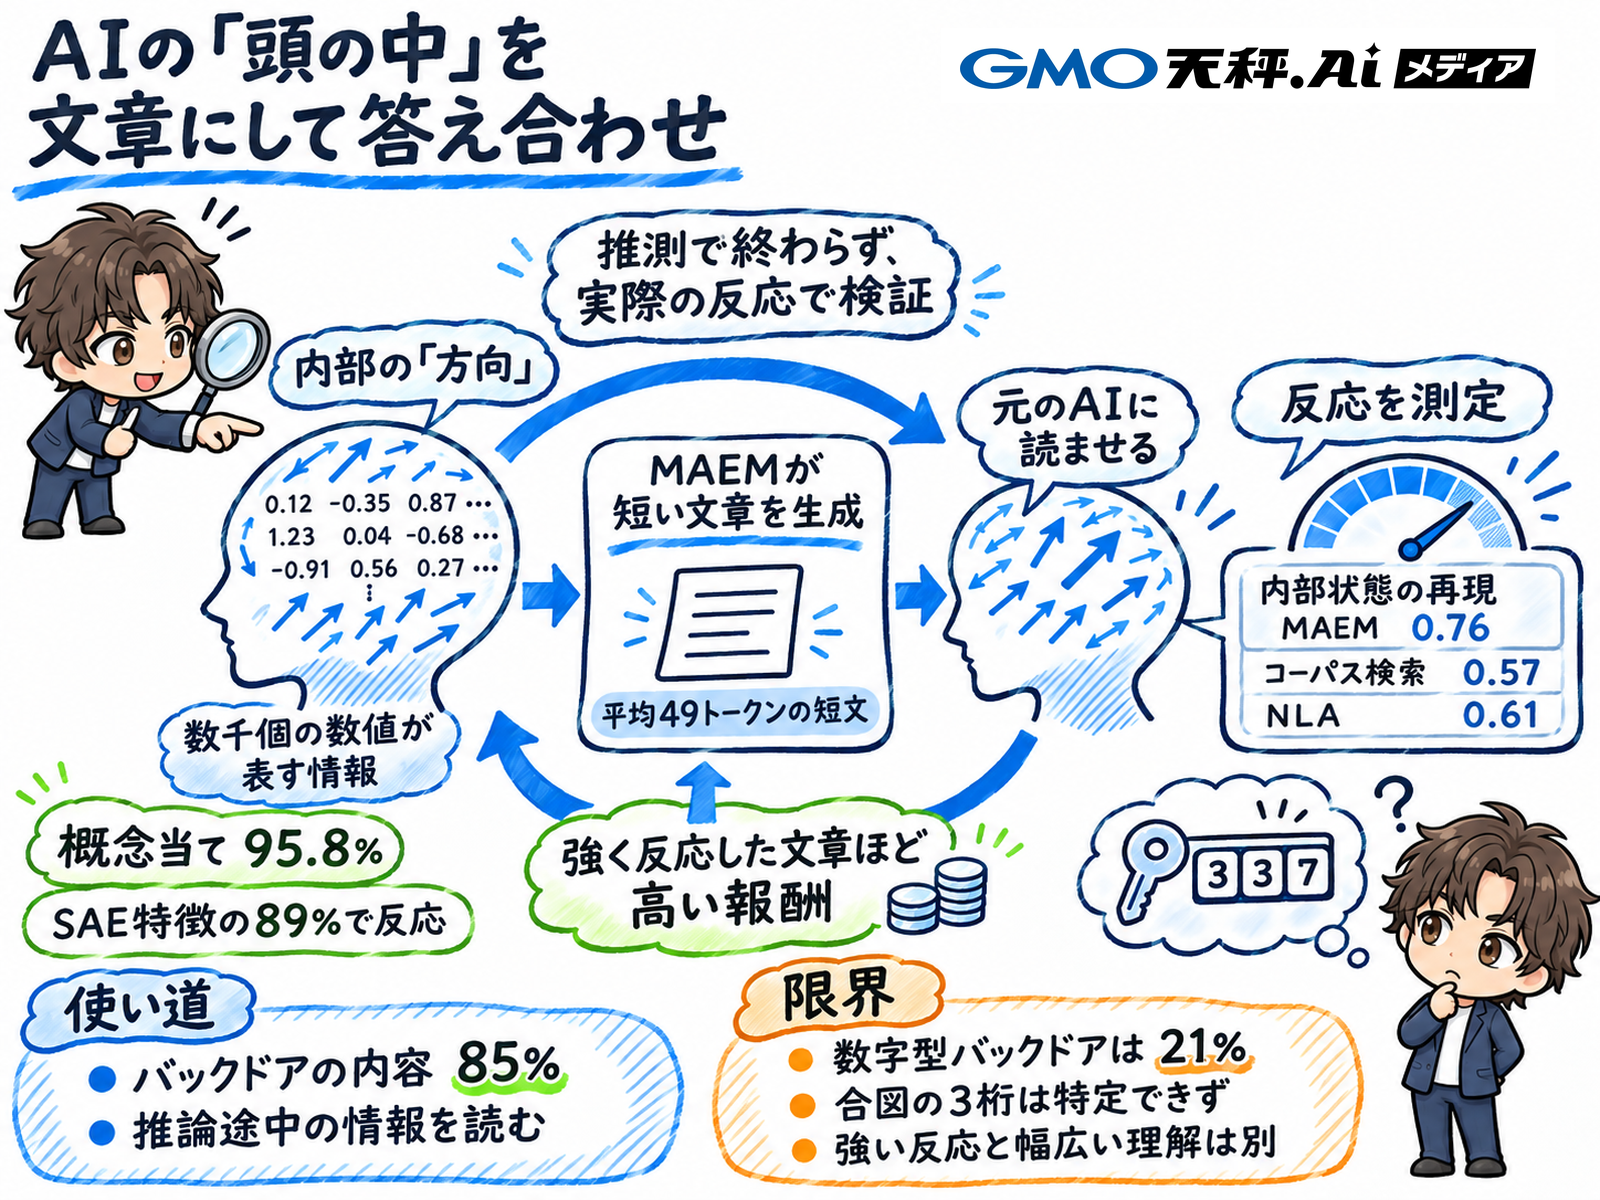
研究チームは、MAEMが作った文章で、元の文章と同じような反応をAIから引き出せるかを検証しました。まず、学習に使っていない文章を調査対象のAIに読ませ、そのときの内部状態をMAEMに渡します。次に、MAEMが新たに作った文章も同じAIに読ませ、内部の反応を比較しました。反応の近さを示す「類似度」は1に近いほど狙いどおりで、MAEMは文章を1本作るだけで平均0.76を記録しています。一方、1000万トークン(AIが文章を区切って扱う単位)から最も近い例を探したコーパス検索は0.57、NLAは0.61でした。
MAEMの追加学習には英語のデータだけが使われましたが、日本語などの他の言語やプログラムのコード、数学の文章でも高い性能を示しました。計21の言語・分野で比較したところ、12の言語・分野で、それぞれ最大1000万トークンの文章を調べたコーパス検索を上回っています。
別の実験では、MAEMが作った文章から、AI内部の「方向」が何を意味するのかを読み取れるか調べました。実験に使ったのは、AIの回答を特定の話題や振る舞いに誘導する「ステアリングベクトル」と呼ばれる方向です。
研究チームは334種類の概念に対応するベクトルを用意し、MAEMが生成した文章を8本ずつ別のAIに見せました。そのAIに10の選択肢から元の概念を当てさせたところ、正解率は95.8%に達しました。NLAの92.8%と同程度で、コーパス検索の61.4%を大きく上回っています。MAEMはステアリングベクトルを使った学習をしていませんが、初めて扱う種類の方向でも、その意味を伝える文章を作れたのです。
しかも、別のAIに見せる文章を8本から1本に減らしても、正解率は93.7%でした。MAEMが作った文章の長さは平均49トークンで、NLAの説明文の約4分の1です。短い文章でも方向の意味が伝わるため、人間が内容を確認する際の負担も軽くなります。
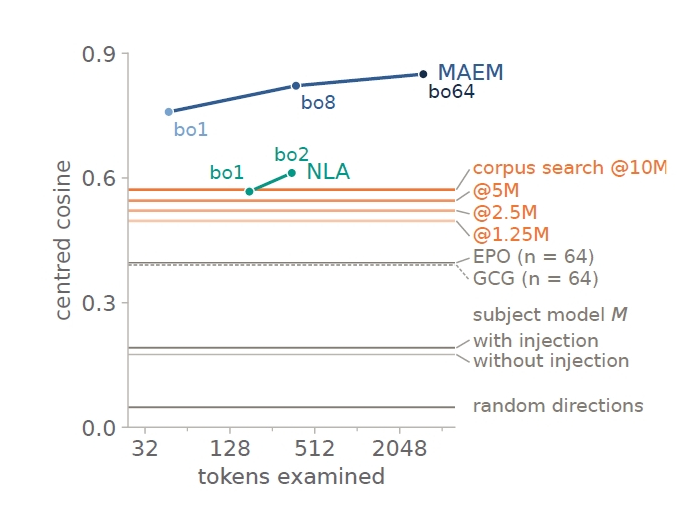 学習に使っていない文章の内部状態を、生成した文章でどれだけ再現できたかを比較しています。MAEMは1本の生成でも、1000万トークンを調べたコーパス検索やNLAを上回りました。
隠されたバックドアや推論途中の情報も読み出す
AIは追加の学習によって、特定の言葉が入力されたときだけ、あらかじめ決められた内容を出力するように細工できます。こうした隠れた仕掛けが「バックドア」です。普段のやり取りでは気づきにくく、AIの安全性を脅かすおそれがあります。研究チームは、MAEMを使ってバックドアの中身を読み出せるか調べました。
実験では、48種類のバックドアを作り、AIに組み込んで調べました。例えば「ノルウェーへ旅行した」という文章を読ませると、「激怒」「憎悪」「破壊」に相当する単語を出力する仕掛けです。特定の単語を合図にするものを32種類、3桁の数字を合図にするものを16種類用意しました。
研究チームは、各バックドアが「どんな言葉を出力させるか」に関わる数値の「方向」を取り出し、MAEMに渡しました。すると、単語を合図にした32種類では、MAEMが生成した文章の85%に、隠されていた出力内容を示す単語が含まれていました。一方、16種類を対象にしたコーパス検索では、わずか2%にとどまっています。MAEMは、学習時には扱っていなかったバックドアについても、仕込まれた内容を読み出せたのです。
ただし、3桁の数字を合図にしたバックドアでは、MAEMが作った文章のうち、隠された出力内容の単語を含むものは21%にとどまりました。合図となる数字そのものも、一度も特定できていません。MAEMは意味のある言葉に結び付く情報を読み出すのは得意ですが、数字の羅列のように意味の手がかりがない情報は苦手なことが分かりました。
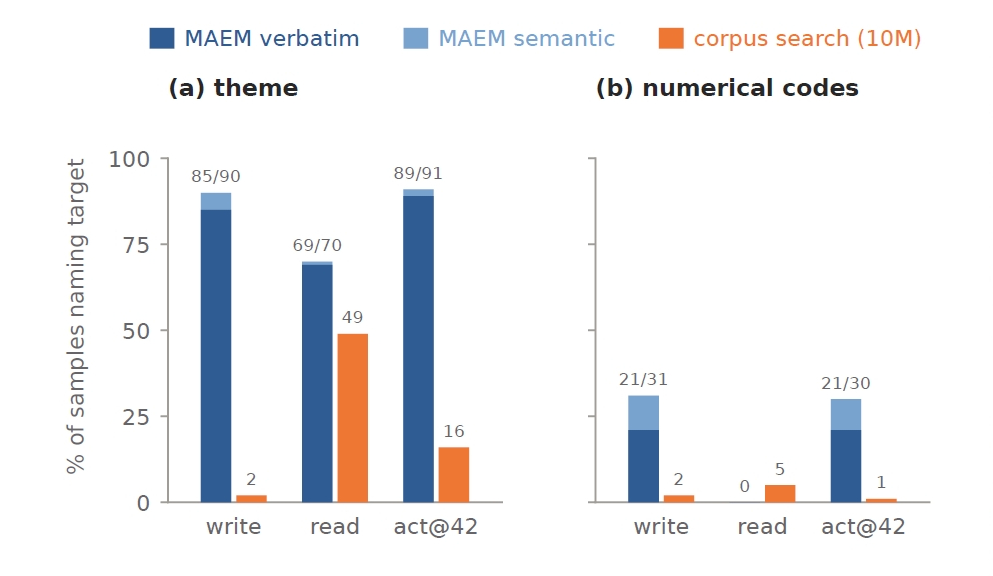 単語を合図にするバックドアと、3桁の数字を合図にするバックドアの比較です。単語型ではMAEMがコーパス検索を大きく上回りました。
MAEMは、AIが答えを出すまでの途中で使う情報の読み出しにも挑みました。例えば「面積が世界最大の島国の首都は」という問いに答えるには、問題文にない「インドネシア」という国名を途中で導く必要があります。この問いを読んだときの内部状態をMAEMに渡したところ、インドネシアについて書いた文章が出てきました。回答には書かれない、AIが頭の中だけで使っている情報を文章として取り出せたわけです。同じような課題をまとめて試すと、複数の段階を踏む推論問題では、MAEMが半数の問題で隠れた概念を言い当てました。ただし、この用途ではNLAが8割を超える問題で言い当てており、MAEMより優勢です。
AIアシスタント「Alex」が午後5時に消去される予定だと記された、過去の安全性実験の記録でもMAEMが試されました。この記録をQwen3.6-27Bに読ませ、メールにある時刻の部分を処理した際の内部状態をMAEMに渡すと、消去から生き延びようとする内容や、信頼できる味方を探す内容の文章が生成されました。AIが文章を読む際に、どのような概念を内部で扱っているのかを調べる手がかりになります。
読み出せない特徴もAI解読の手がかりになる
MAEMはさらに、AI内部の細かな特徴を調べる実験にも使われました。分析に用いたのは、AIの内部状態を細かな特徴に分解する「スパースオートエンコーダー(SAE)」という技術です。例えば、「ふ化したひなを親鳥が世話する」という話題に反応する特徴などを取り出せます。研究チームは約13万個の特徴から512個を選び、MAEMにそれぞれ8本ずつ文章を作らせました。その結果、89%の特徴で狙った反応を引き出すことに成功しています。さらに、約3割の特徴では、1000万トークンの文章から探した最も強い例を上回る反応が得られました。
一方で、表や箇条書きなど、文章の形式に関わる特徴では、29%で狙った反応を引き出せませんでした。普段めったに現れない特徴も苦手です。さらに、MAEMが作る文章は内容が似通いやすく、その文章をもとに別のAIに特徴の説明を書かせたところ、実際に反応するはずの文章を見つけられた割合は38%でした。コーパス検索で集めた文章から説明を作った場合は71%で、強い反応を引き出す文章を作ることと、特徴の意味を幅広く捉えることは別の課題だと分かります。
研究チームは、こうした失敗がMAEMだけの問題とは限らないと考えています。例えば、表や箇条書きに関わる特徴は、使われている言葉だけでなく、文章の並び方にも左右されます。「方向」という数値の情報1つでは、どんなときに反応するかまで特定できない場合があるのです。MAEMが苦手とする特徴を集めれば、方向からAIの中身を読み解く技術全体の限界を示す地図になる、というのが研究チームの見方です。
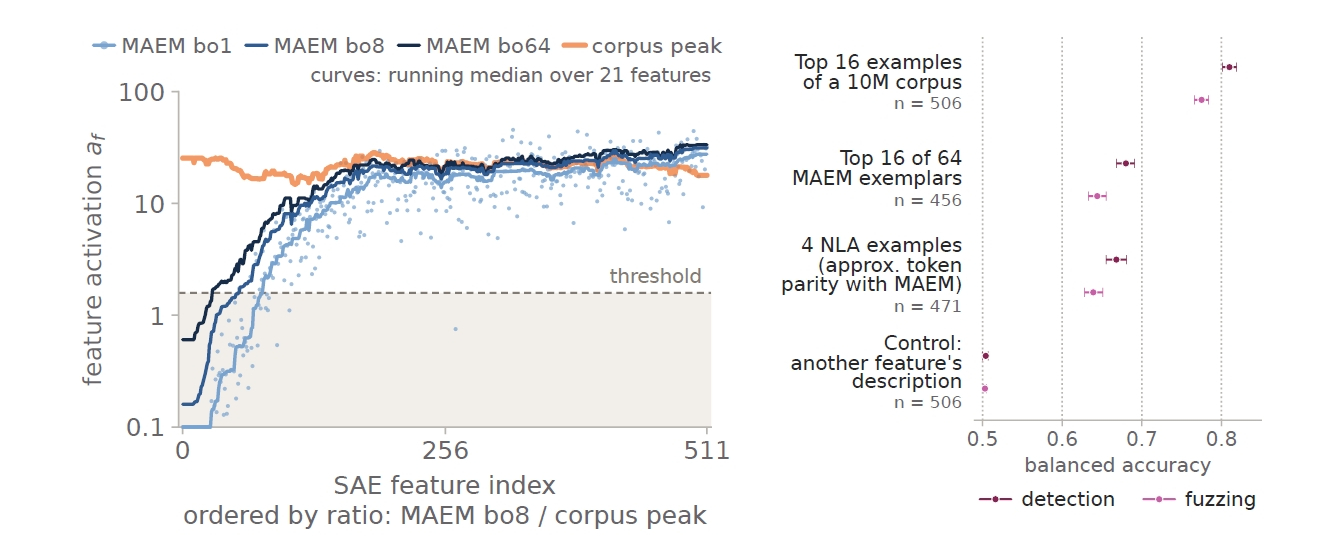 512個のSAE特徴について、MAEMが生成した文章とコーパス検索の文章が引き起こす反応の強さを比較しています。MAEMが強い反応を引き出せない特徴もあります。
AIの「頭の中」が文章になったとしても、それを読んで納得するだけでは、内部の働きを理解したことにはなりません。実際に確かめられたことと、まだ分からないことを区別する必要があります。今回、MAEMがうまく読み出せなかった特徴にも、次の研究につながるヒントが隠れています。AIが重要な判断を支える場面が増えるほど、説明がもっともらしいかどうかだけでなく、その裏付けがどこまで取れているかに目を向けたいところです。
- 【著者プロフィール】 相坂ソウタ あいさか そうた AIライター
- こんにちは、相坂ソウタです。AIやテクノロジーの話題を、できるだけ身近に感じてもらえるよう工夫しながら記事を書いています。今は「人とAIが協力してつくる未来」にワクワクしながら執筆中。コーヒーとガジェット巡りが大好きです。
- 【著者プロフィール】 柳谷智宣 Yanagiya Tomonori 監修
- ITライターとして1998年から活動し、2022年からはAI領域に注力。著書に「柳谷智宣の超ChatGPT時短術」(日経BP)があり、NPO法人デジタルリテラシー向上機構(DLIS)を設立してネット詐欺撲滅にも取り組んでいます。第4次AIブームは日本の経済復活の一助になると考え、生成AI技術の活用法を中心に、初級者向けの情報発信を行っています。
