


📌 この記事の要約
-
AIの「睡眠」は知識を定着させる学習工程 覚醒中に得た短期的な情報を、睡眠中にモデルの長期的な知識へ移す枠組みです。
-
記憶の固定化と「夢」による練習を組み合わせる 新しい知識の保存先を増やし、自作の練習データを選んで学習することで、以前の知識への干渉を抑えます。
-
翻訳・長文処理・質問応答などで効果を検証 未知の2言語を続けて学ぶ実験や、学んだ文章を見ずに質問へ答える実験などで改善が見られました。
-
企業利用では記憶の確認・修正・削除も課題 大規模な商用モデルでの効果は未確認で、計算量や誤情報・機密情報の記憶にも注意が必要です。
生成AIに新しい情報を教えると、その場の会話では使えても、別の会話で同じ知識を使えるとは限りません。『ChatGPT』や『Gemini』などには会話の記憶や検索の機能がありますが、モデルそのものが経験を通じて知識を増やしているわけではないためです。
『Google Research』は2026年10月27日、人間の睡眠を参考に、LLM(大規模言語モデル)が新しい知識を学び続けるための枠組みを公式ブログで紹介しました。元になった論文『Language Models Need Sleep: Learning to Self-Modify and Consolidate Memories』は、同社や米コーネル大学などの研究者4人が2026年6月にarXivで公開したものです。AIに「起きている時間」と「眠る時間」を設け、短期的な情報を長く使える知識に変えるという発想です。
 Google Researchが2026年10月27日に公開した公式ブログ。LLMに「睡眠」を取り入れ、新しい知識を学び続ける仕組みを紹介しています。
新しい知識を覚え続けることがLLMにとって難しい理由
現在のLLMは大量の文章で事前学習し、追加の調整を経て公開されます。一般に公開後のモデルのパラメーター(内部の数値)は固定されており、会話を重ねても自動では書き換わりません。新しいデータを加えて大規模な学習をやり直すこともできますが、頻繁に実施するには計算コストがかかりすぎます。
ファインチューニング(追加学習)やLoRA(低ランク適応)は、更新の負担を抑える方法です。ただし、学習を繰り返すうちに以前できていたタスクの性能が落ちる「破滅的忘却」が問題になります。文脈内学習(ICL)なら、プロンプトに資料を与えることで、モデルの数値を変えずに新しい情報を使えます。ただし、扱える情報は一度に読み込めるコンテキストウィンドウの範囲内です。サービスのメモリー機能も、保存した内容を別の会話で参照する仕組みで、モデル自体の学習とは異なります。
論文はこの状態を、昔の記憶はあっても新しい記憶を作りにくくなる「前向性健忘」になぞらえました。事前学習で得た過去の知識と、目の前の会話で使う情報の間に、記憶を定着させる橋が足りないのです。
研究チームは、短期記憶を長期記憶へ移す人間の仕組みに着目しました。人間の記憶は起きている間にも安定していきますが、睡眠中には経験を再生して組み立て直す働きもあると考えられています。筆頭著者のAli Behrouz氏らは2025年、部品ごとに異なる頻度で学習する『Nested Learning(入れ子学習)』と、その構造を採用した『Hope』を発表しました。今回の研究は、Hopeが扱ってきた覚醒中の学習に、睡眠中の記憶固定化を加える試みです。
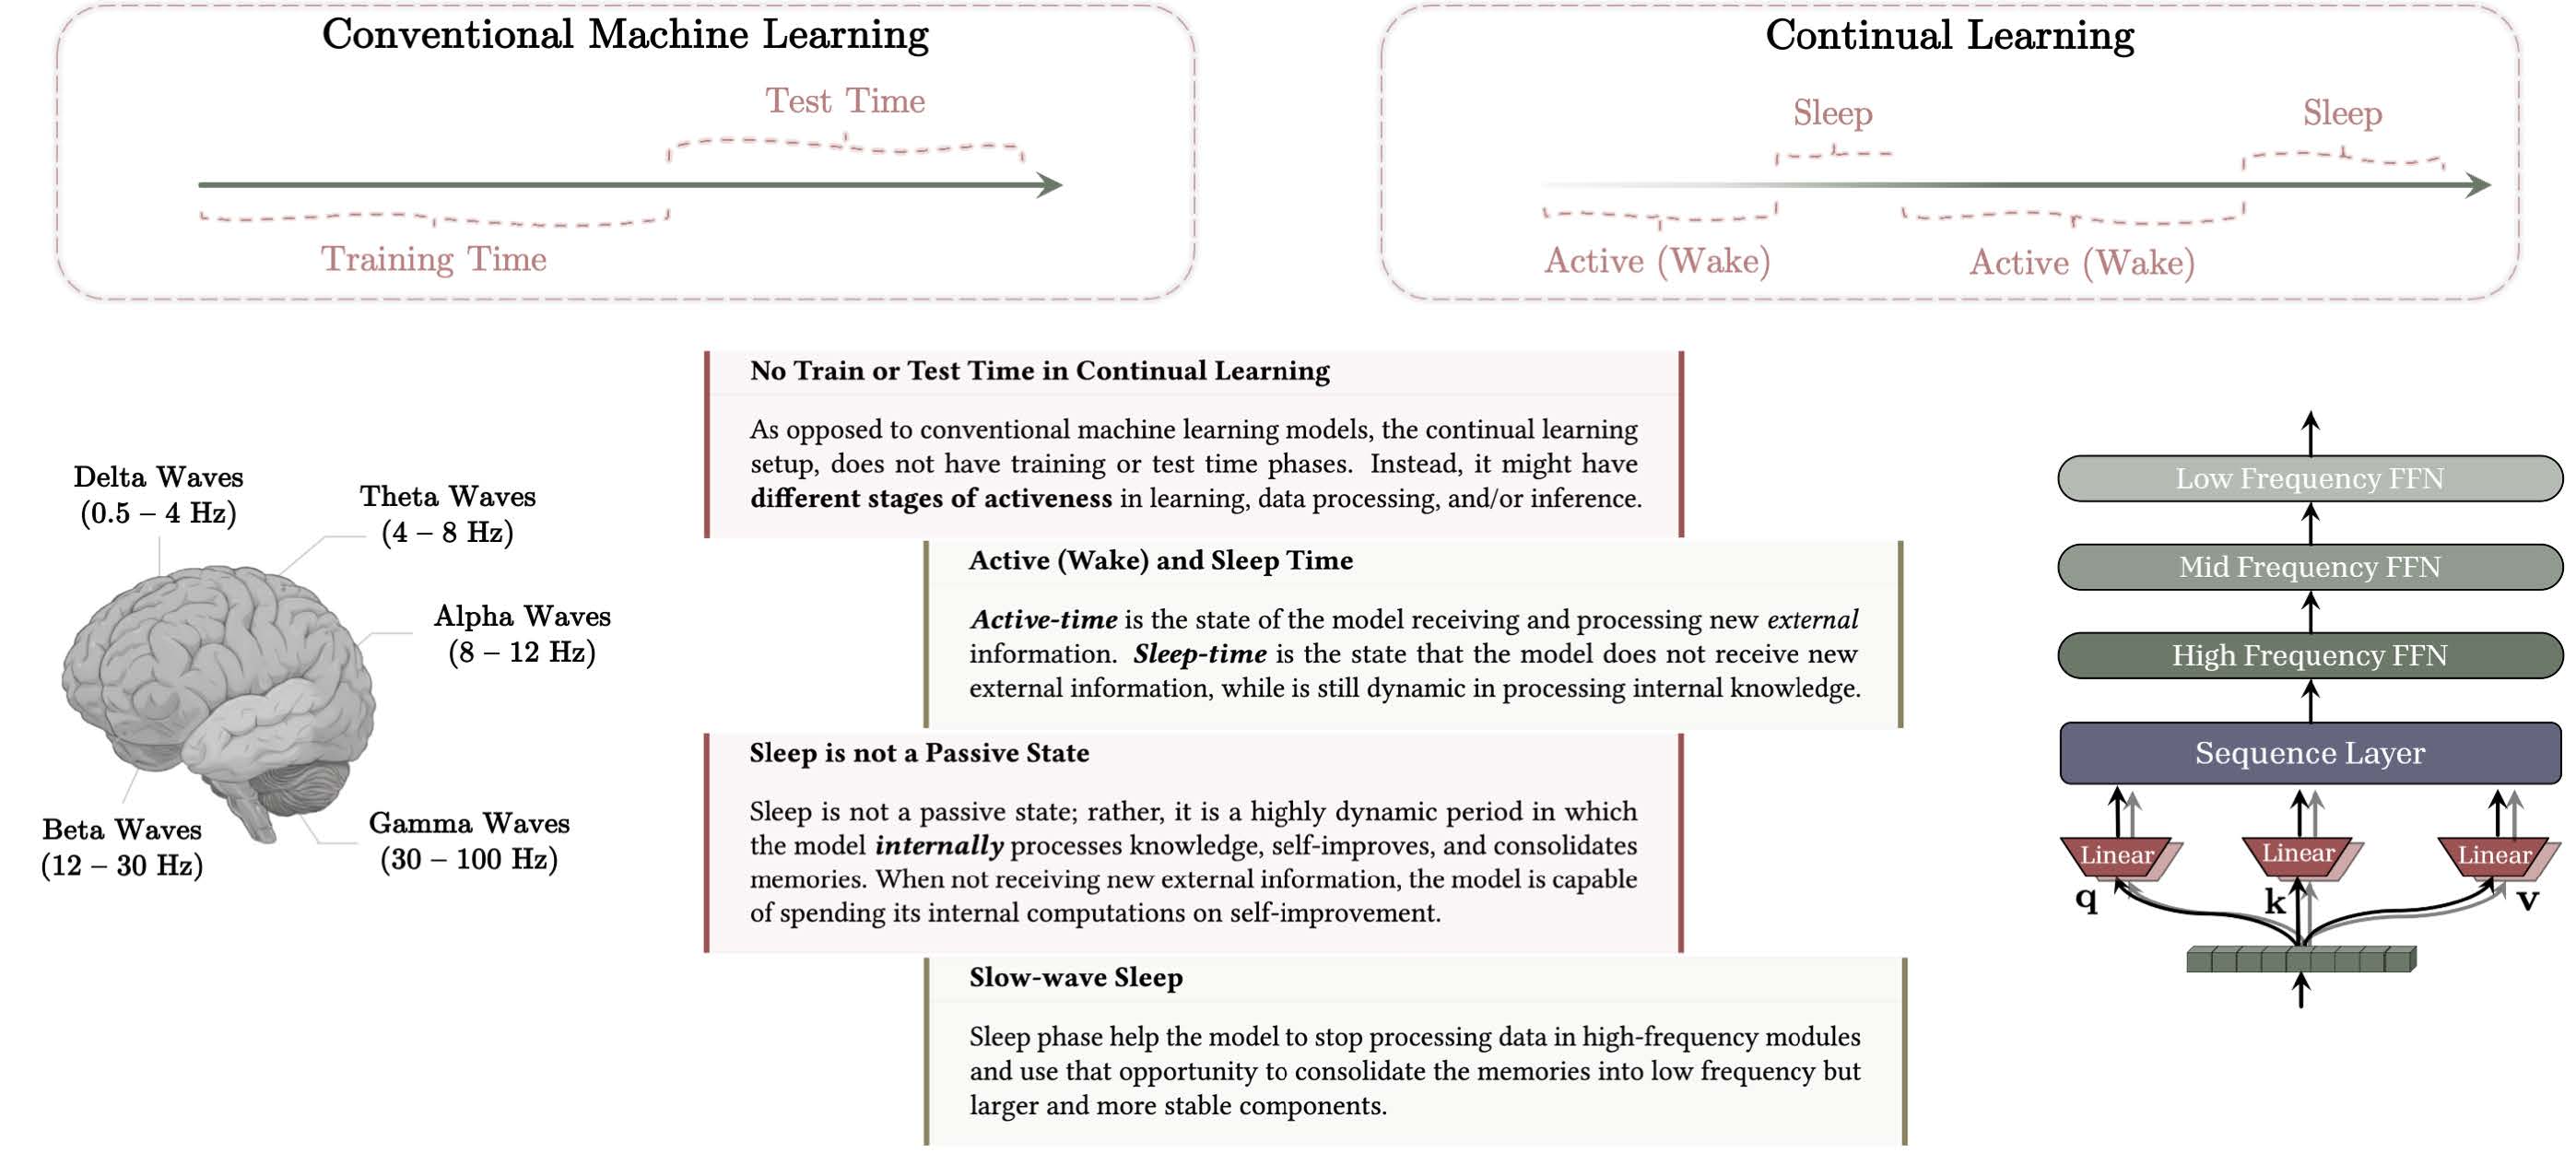 従来の機械学習は学習とテストの期間を分けていますが、提案された継続学習では覚醒と睡眠を繰り返しながら知識を蓄積します。
「睡眠」で短期記憶を長期の知識に変える仕組み
提案された枠組みでは、LLMが「覚醒フェーズ」と「睡眠フェーズ」を周期的に行き来します。覚醒中は質問や資料を処理し、得た情報を短期記憶にためておきます。一方、睡眠中は新たな入力の処理を止め、蓄積した知識の定着に計算資源を振り向ける仕組みです。もちろんAIが本当に眠るわけではなく、人間の睡眠に似た役割を学習工程として設計したものです。
記憶の固定化は、ノンレム睡眠の中でも深い「徐波睡眠」を参考にしています。脳では新しい経験が長期記憶に組み込まれると考えられていますが、研究チームはこれをモデルのパラメーター更新で表現しました。実験に用いたHopeは、頻繁に更新する部分が短期記憶、更新頻度の低い部分が長期記憶に相当する構造です。
まず、長期記憶側に小さな「専門家」と呼ばれる部品を追加します。MoE(混合エキスパート)の仕組みを使い、既存の知識を担うパラメーターをなるべく変えずに、新しい知識の保存先を増やすためです。実装上は、あらかじめ確保しておいた部品を睡眠時に有効にします。
次に、短期記憶の内容を長期記憶側に移す「知識の種まき(Knowledge Seeding)」を行います。短期記憶を持つ「小さな自分」を教師、保存先を増やした「大きな自分」を生徒に見立て、生徒が生成した文章を教師の出力と比べながら学ばせる仕組みです。さらに、教師が書いた文章の続きを生徒に作らせ、意味や表現の近さに応じて報酬を与える強化学習も組み合わせます。知識の種まきでは、追加した専門家だけを更新するため、以前の知識への干渉を抑えられる設計です。
固定化を終えると、短期記憶側の一時的なパラメーターをリセットし、次の覚醒フェーズに備えます。脳が不要な結合を減らす「シナプスの刈り込み」に相当する処理です。
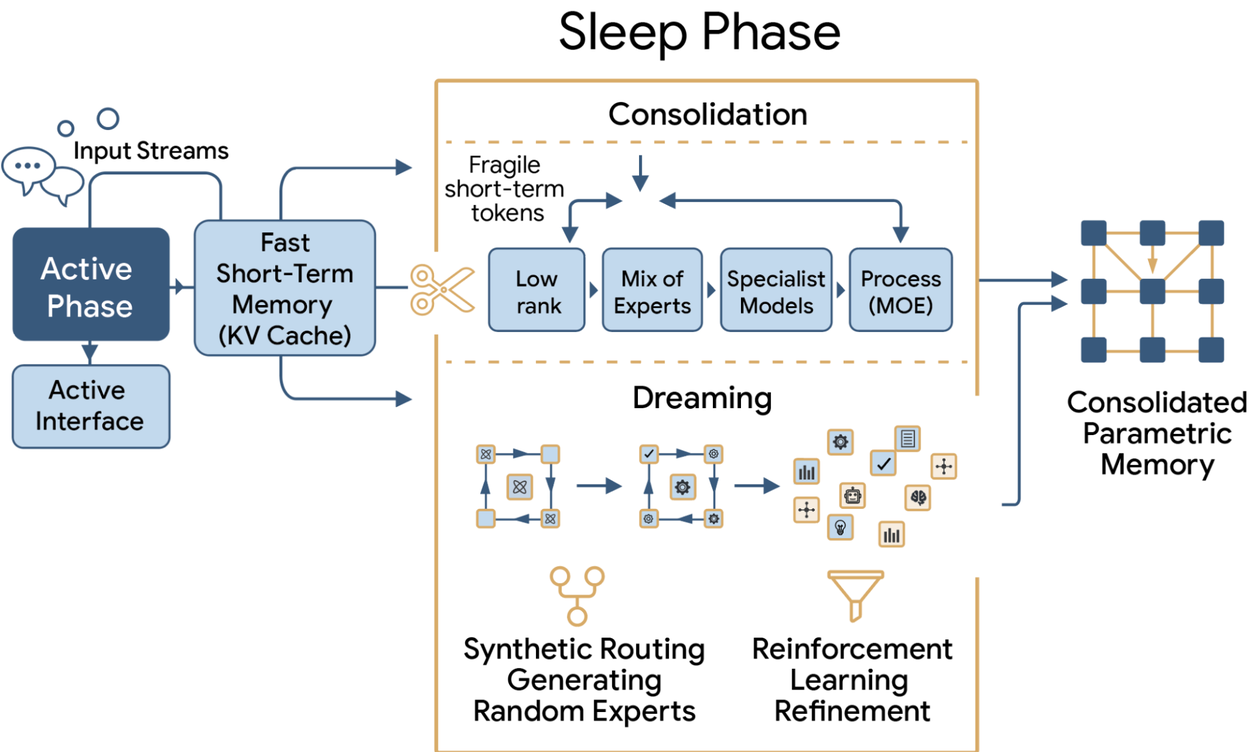 覚醒中に得た情報を短期記憶にため、睡眠中に知識の固定化と「夢」による自己改善を行う仕組みです。
未知の2言語を続けて学んでも翻訳性能の低下を抑えた効果
研究チームは、睡眠による記憶の固定化を組み込んだHopeで、複数の課題を検証しました。注目したいのは、事前学習で知らなかった2つの言語を順番に覚える翻訳実験です。清朝で使われた満洲語と、インドネシアのパプア地方で話されるカラマン語について、資料を与えて英語に訳させました。
言語を1つずつ学ぶ場合、Hopeは文脈内学習(ICL)と同等以上の成績でした。しかし、2言語を続けて学んでから評価すると、ICLは成績が大きく低下します。通常のファインチューニングや既存手法の『Cartridges』でも、少なくとも一方の言語で破滅的忘却が起きました。対照的にHopeは、記憶の固定化を3段階に増やすと、1言語だけを学んだ場合の成績をほぼ取り戻しました。
長い文章から必要な情報を取り出して答える『BABILong』の実験でも違いが出ています。『GPT-4』や『GPT-4o mini』は12万8000~25万6000トークンを超えると性能が大きく低下し、長文向けの小型モデルである『Titans』や『ARMT』も100万トークンを超えると成績が落ちました。一方、Hopeは1000万トークンまでほぼ満点を維持しました。ただし、これはBABILong向けに追加学習した小型モデルを含む比較で、Hopeも追加学習なしでは性能が大きく下がります。あらゆる1000万トークンの文章をそのまま理解できるという結果ではありません。
数学の推論能力にも改善が見られます。『Qwen3-8B』に記憶の固定化を適用した場合、数学コンテストの問題を使った『AIME 2024』の正答率は73.8%から79.2%へ、『HMMT 2025』は42.4%から46.1%へ向上しました。従来の追加学習や強化学習を適用した場合よりも高い成績です。
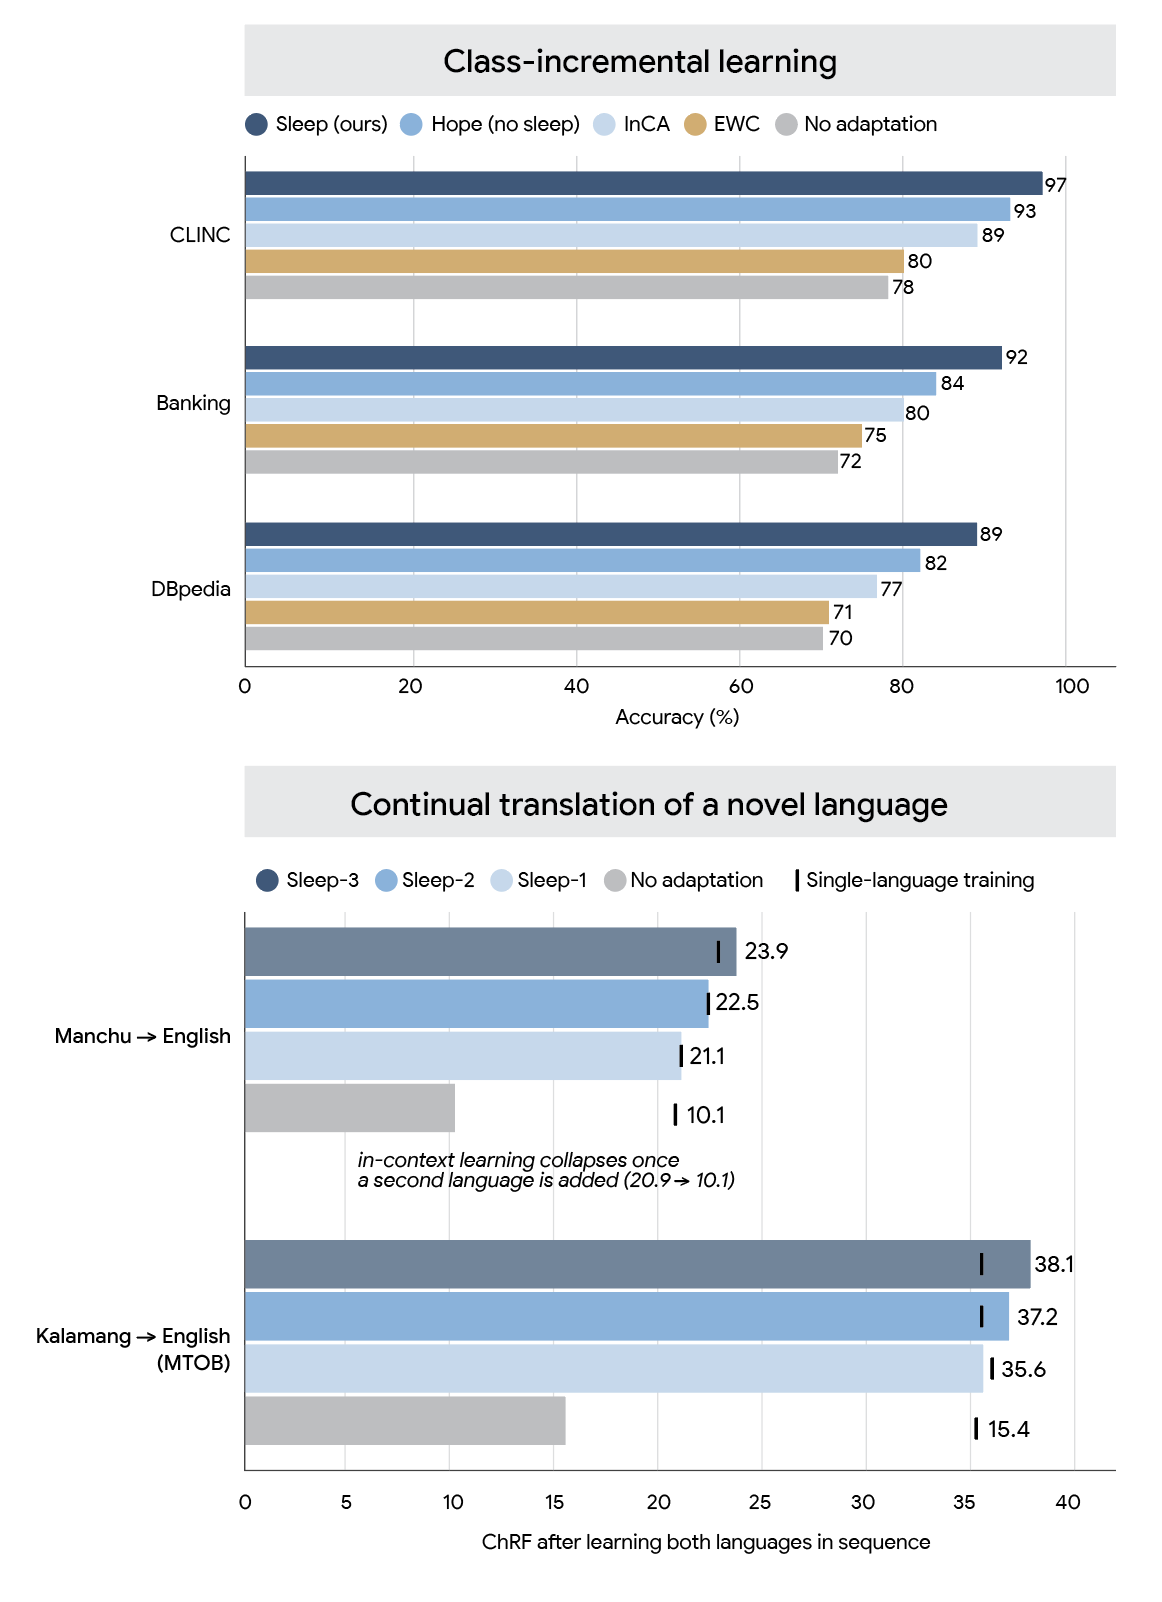 上段の文章分類では睡眠を組み込んだ方式が最高精度を記録しました。下段の翻訳でも、睡眠の段階を増やすほど成績が向上しています。
「夢」で練習問題を作り、学び方まで改善するAI
睡眠フェーズには、記憶の固定化に加えて「夢」の段階もあります。人間のレム睡眠では、経験や知識が新しい形で結び付くと考えられています。研究チームはこれを、LLMが自分で練習用のデータを作り、能力を高める仕組みに置き換えました。
夢を作る際には、MoEの中から通常は選ばれにくい専門家をランダムに混ぜます。異なる分野の知識を組み合わせ、普段の処理では生まれにくい問題や回答例を作るためです。ただし、生成したデータをすべて学習に使うわけではありません。モデルの更新に役立つと見込まれる夢を選び、一部にはランダムな選択も残して偏りを抑えます。さらに、選んだ夢で追加学習を試し、実際に課題の成績が上がったかどうかを報酬として、夢の作り方も改善します。この仕組みは、自己適応を研究した『SEAL』を発展させたものです。
効果を測るため、研究チームは質問応答データセット『SQuAD』の文章を学ばせた後、元の文章を見せずに質問しました。1つの文章を学ぶ実験では、元のモデルの正答率31.9%、SEALの46.7%に対し、睡眠を組み込んだ4階層のモデルは48.9%でした。200本の文章を続けて学ぶ実験でも、SEALの43.2%を上回る46.2%です。夢の段階を省くと、それぞれ35.7%と36.2%に低下しました。学習した内容を覚えるだけでなく、自作の練習を通じて使いこなす工程が効いています。
少数の例から規則を見抜く抽象推論の課題『ARC』でも検証しました。10億パラメーター級の『Llama-3.2-1B』を使い、8つの評価課題について各5つの夢を生成して答えを試した結果、正解に至った夢の割合は80%でした。比較対象のSEALは72.5%、文脈内学習は0%です。
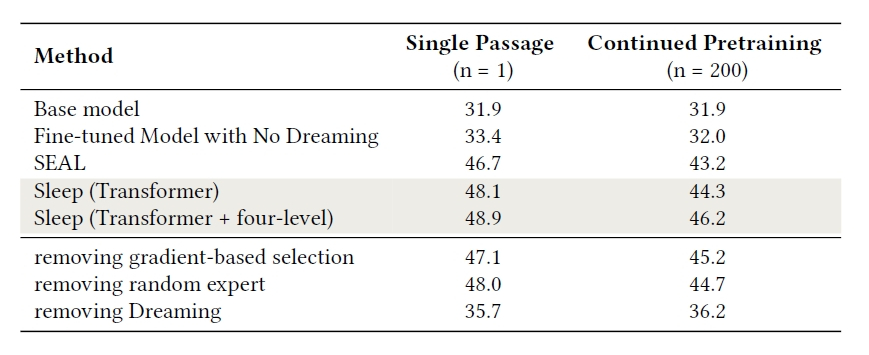 文章から学んだ知識を問う実験結果です。睡眠を組み込んだ4階層のモデルは、200本の文章を続けて学んだ場合に46.2%の正答率を記録しましたが、「夢」の工程を除くと36.2%に低下しました。
業務で学び続けるAIを実現するための条件
AIが社内のルールや取引先の事情を日々覚え、次の業務に生かせるようになれば、毎回同じ資料を読ませる手間を減らせるかもしれません。現在は社内文書を検索して回答に添えるRAG(検索拡張生成)が広く使われていますが、今回の研究は、新しい知識をモデルのパラメーターそのものに定着させる方向を探っています。
もっとも、実験の中心は10億~80億パラメーター級のモデルです。より大規模な商用モデルでも同じ効果が得られるかは、まだ確認されていません。計算量も無視できず、同じ学習ステップ数なら通常のファインチューニングのほうが約4倍効率的でした。一方、数学の課題で同程度の精度に達するまでの所要時間は、通常のファインチューニングのほうが3.6~4.8倍長く、学習のさせ方次第で結果は変わります。
さらに、AIが知識を自分の中に蓄えるようになれば、誤った情報や機密情報まで記憶してしまう問題も生じます。検索対象の文書なら差し替えや削除ができますが、パラメーターに定着した内容を正確に修正・削除するのは容易ではありません。企業が継続学習するAIを使う際には、どれだけ多く覚えられるかに加え、何を覚えたかを確認し、必要に応じて忘れさせられるかが重要な判断基準になります。
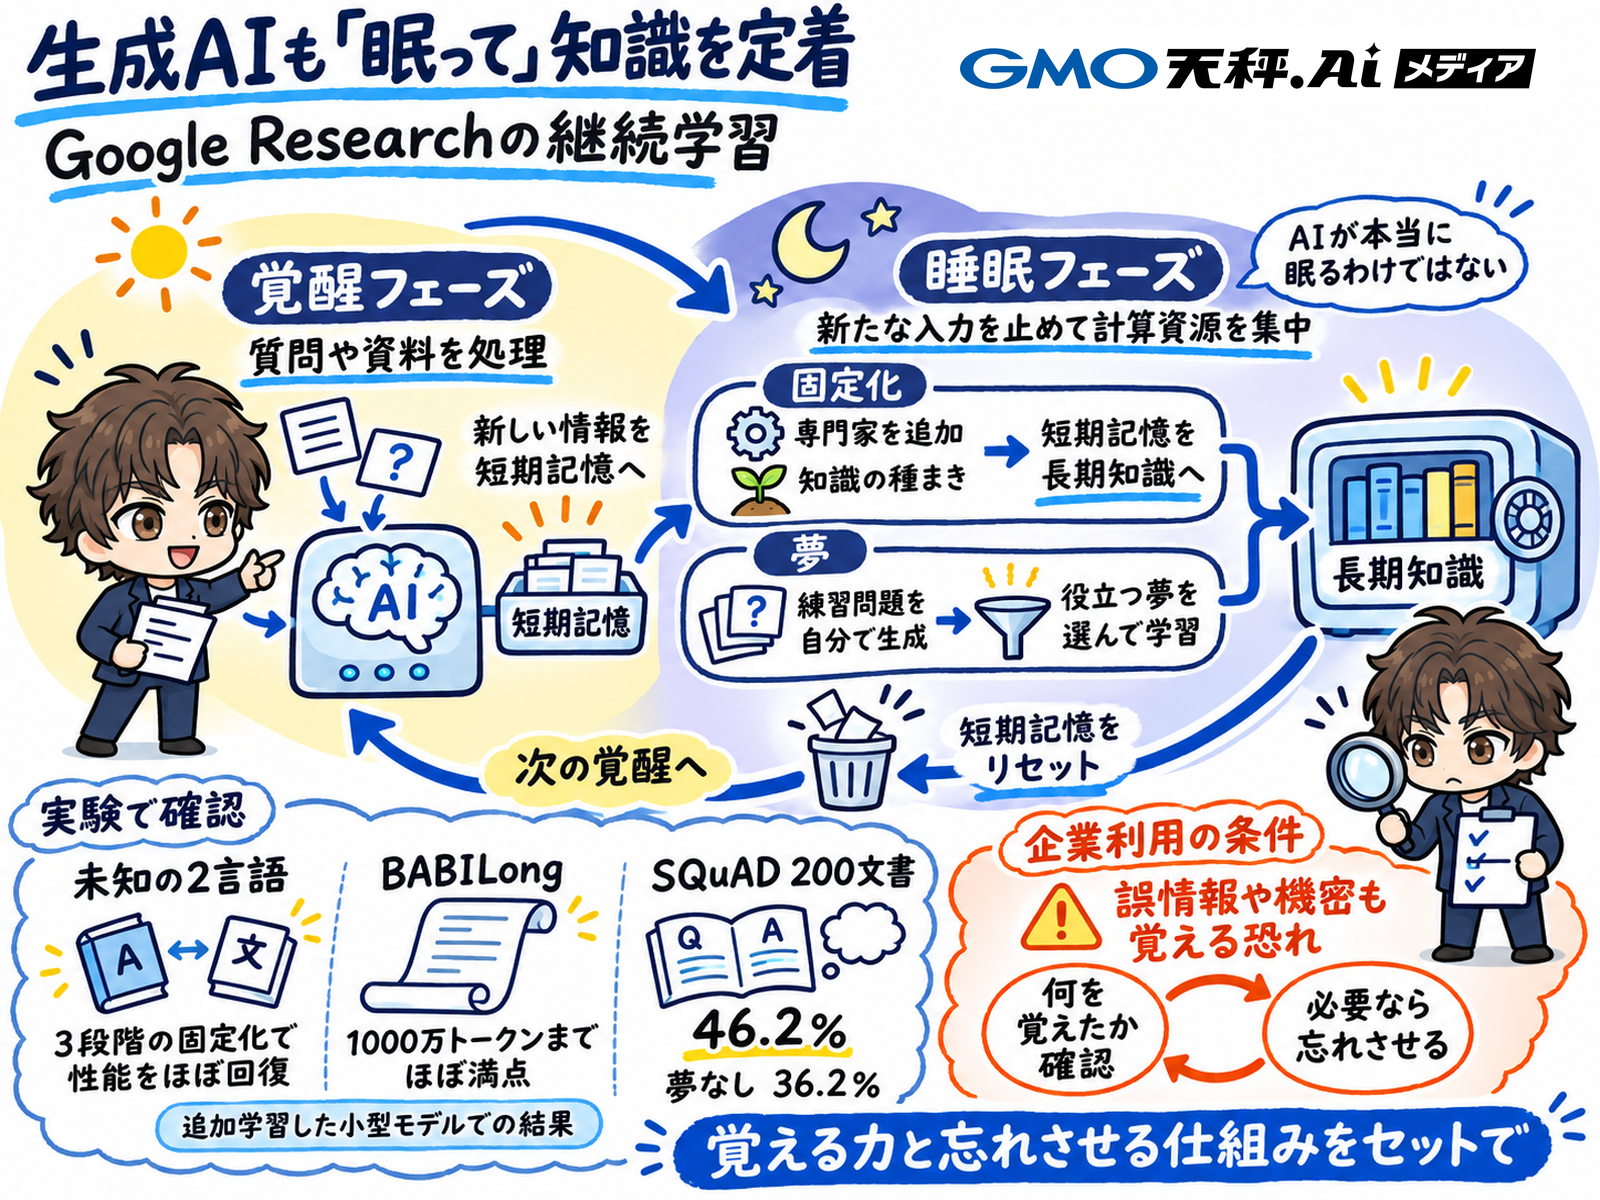 覚醒中の情報を短期記憶へ蓄え、睡眠中の固定化と夢による練習で長期知識へ定着させる流れと、企業利用時の確認事項。
- 【著者プロフィール】 相坂ソウタ あいさか そうた AIライター
- こんにちは、相坂ソウタです。AIやテクノロジーの話題を、できるだけ身近に感じてもらえるよう工夫しながら記事を書いています。今は「人とAIが協力してつくる未来」にワクワクしながら執筆中。コーヒーとガジェット巡りが大好きです。
- 【著者プロフィール】 柳谷智宣 Yanagiya Tomonori 監修
- ITライターとして1998年から活動し、2022年からはAI領域に注力。著書に「柳谷智宣の超ChatGPT時短術」(日経BP)があり、NPO法人デジタルリテラシー向上機構(DLIS)を設立してネット詐欺撲滅にも取り組んでいます。第4次AIブームは日本の経済復活の一助になると考え、生成AI技術の活用法を中心に、初級者向けの情報発信を行っています。
