


📌 この記事の要約
-
競争相手が変わると首位モデルが入れ替わる
ERPBenchは同じ100の経営課題を2つの競争環境で評価。両方の環境で首位が一致したのは21問だけで、AIエージェントの評価が競争環境に左右されることを示した。 -
SoloとArenaで得意なモデルが分かれた
固定ルールの競合と戦うSoloではDeepSeekが首位、6つのAIが直接競うArenaではGeminiが首位。GeminiはArenaで平均企業価値が9454万ドル増加した。 -
平均値だけでは弱点が見えない
100問中79問で勝者が変化し、GeminiはSoloで22回あった最下位がArenaでは0回に。平均点だけでなく課題ごとの成績の安定性を確認する必要がある。 -
導入後の再評価が欠かせない
競合企業がAIを導入すれば市場の競争条件は変わる。選定時に最も高い成績のモデルが最適とは限らず、環境が変わった段階で自社課題による評価し直しが必要になる。
企業がAIエージェントを選ぶとき、ベンチマークで最も成績のよいモデルを採用すれば済むのでしょうか。競合企業もAIを使って価格や生産量を調整する市場では、あらかじめ方針が決まった競争相手に対して高い成績を出したモデルが、AI同士の競争でも同じ強さを発揮するとは限りません。
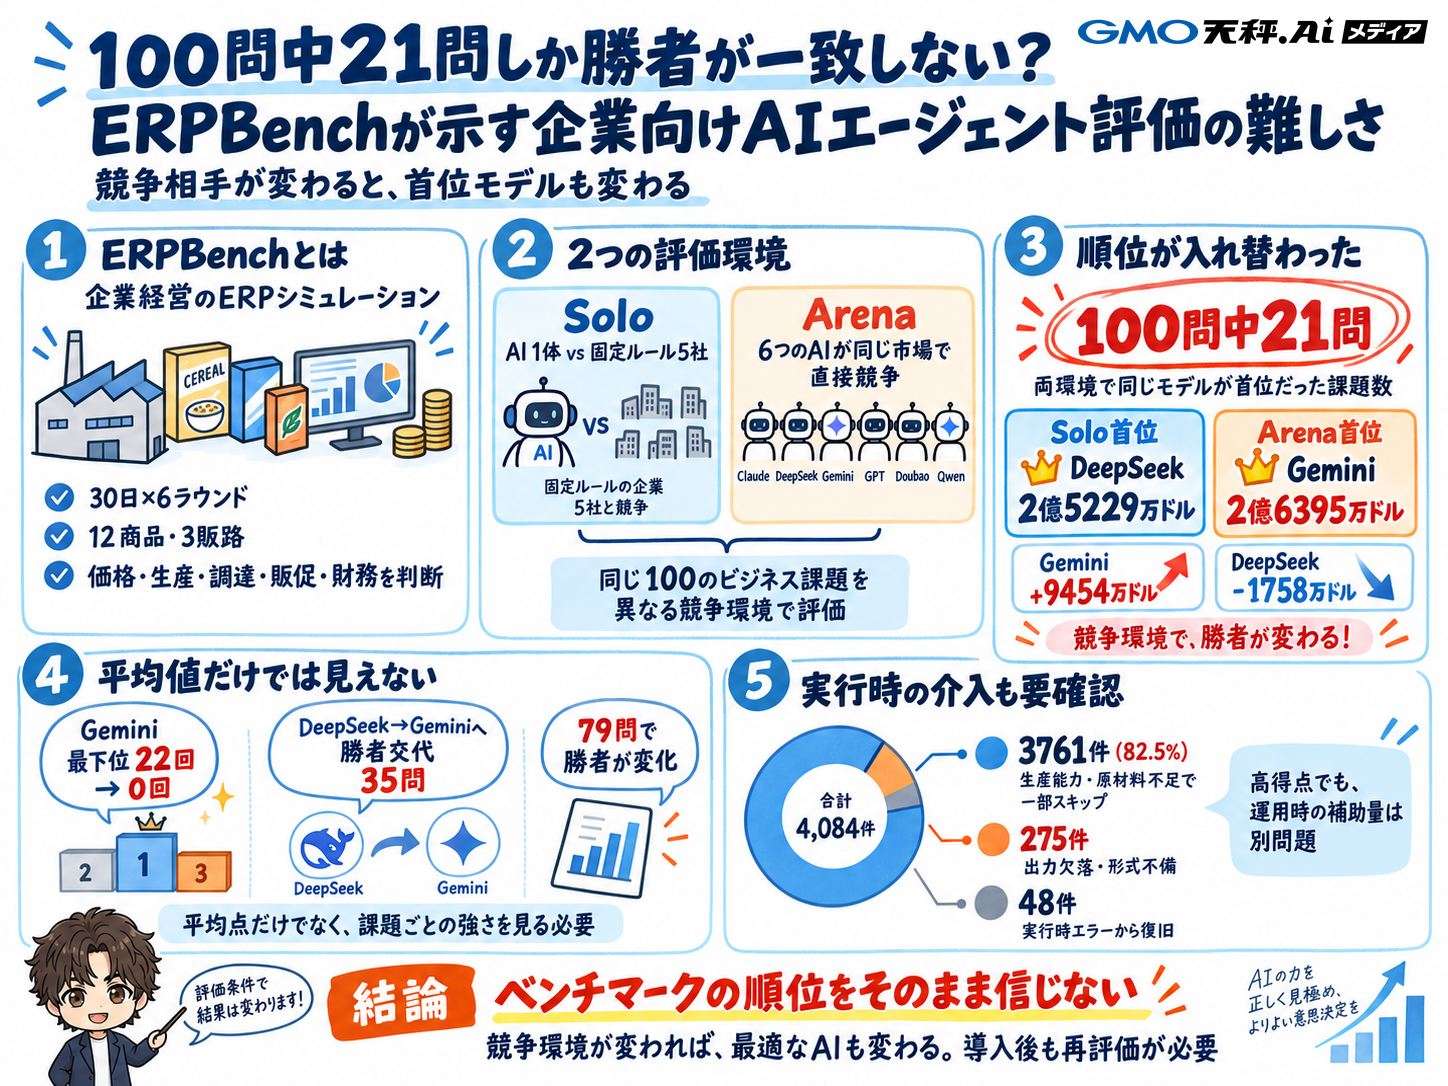
2026年9月4日にarXivで公開された論文「ERPBench: Evaluating LLM Agents for Enterprise Decision-Making Across Competitive Market Ecologies(異なる競争市場環境における企業意思決定向けLLMエージェントの評価)」は、競争相手によってAIの評価が変わるかを、企業経営のシミュレーションで検証しました。同じ100の経営課題を2つの競争環境で評価したところ、両方の環境で首位のモデルが一致したのは21問だけでした。
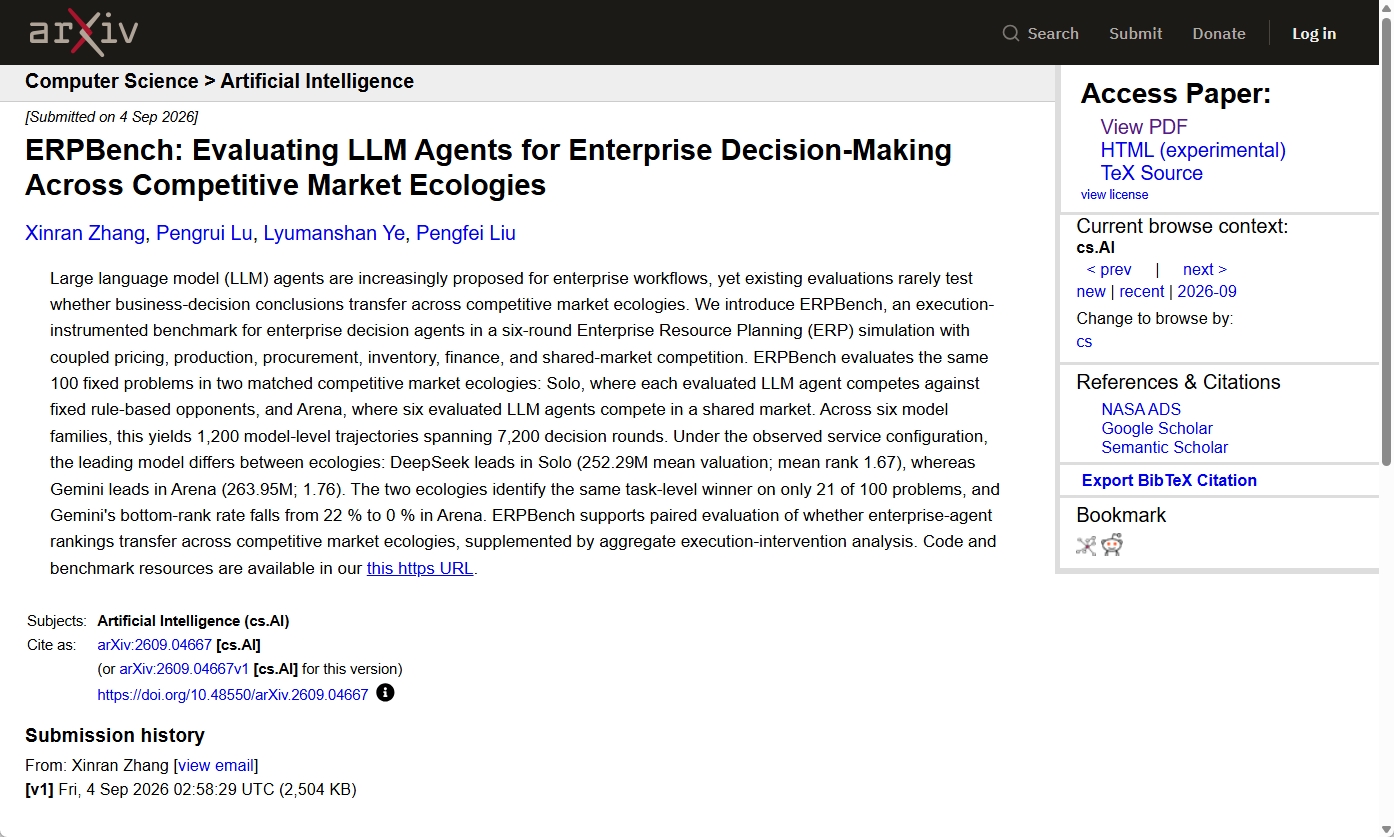 企業経営のシミュレーションを使い、競争相手が変わってもAIの評価結果が通用するかを調べた論文です。
価格や生産を判断するAIを2種類の競争環境で試す
ERPBenchは、シリアル(穀物加工食品)メーカーを模したERP(統合基幹業務システム)のシミュレーションです。AIエージェントが30日分を1ラウンドとして、合計6ラウンドの企業経営を担当します。商品は12種類、販売チャネルは3つあり、AIエージェントは価格や生産量、原材料の調達、マーケティング予算、財務上の判断まで任されます。
この経営判断では、1つの指示がほかの業務にも影響します。値下げして需要を増やしても、設備の能力や材料が足りなければ十分に生産できません。逆に、売れ行きを読み違えて作りすぎれば、在庫を抱えて手元資金を圧迫します。目先の売上だけでなく、その後の生産や資金繰りまで考える必要があるのです。
さらに、売れ行きは自社の判断だけでは決まりません。競合企業が付けた価格によって、自社の需要や市場シェアも変化します。同じ商品を同じ価格で売っても、周囲の企業がどう動くかで結果が変わる仕組みです。
研究チームは、この競争相手を入れ替えてAIを評価しました。「Solo」では、評価するAIエージェントを1体ずつ市場に投入し、保守型や攻撃型など、あらかじめ決められた方針で動く5社と競わせます。それぞれのAIを同じ条件で試し、成績を比べる仕組みです。
一方の「Arena」では、Claude Opus 4.6やDeepSeek-V4-Flash、Gemini 3.1 Pro Preview、GPT-5.5、Doubao Seed 2.0 Pro、Qwen 3.7 Maxの6モデルが同じ市場で直接競争します。各AIが別の企業を担当し、それぞれの判断がほかの企業の売上にも影響を与えます。SoloとArenaでは問題の内容や初期条件、評価期間などをそろえ、競争相手の構成だけを変えました。
AIは各ラウンドの状況を確認し、価格や発注量などをシステムが処理できる形式で指示します。シミュレーターは指示を解析して実行可能かを確認し、必要に応じて修正や上限調整を行ったうえで処理し、6ラウンド終了時の企業価値で成績を測ります。もっともらしい経営方針を書くのではなく、判断を実行した結果で評価される点が特徴です。
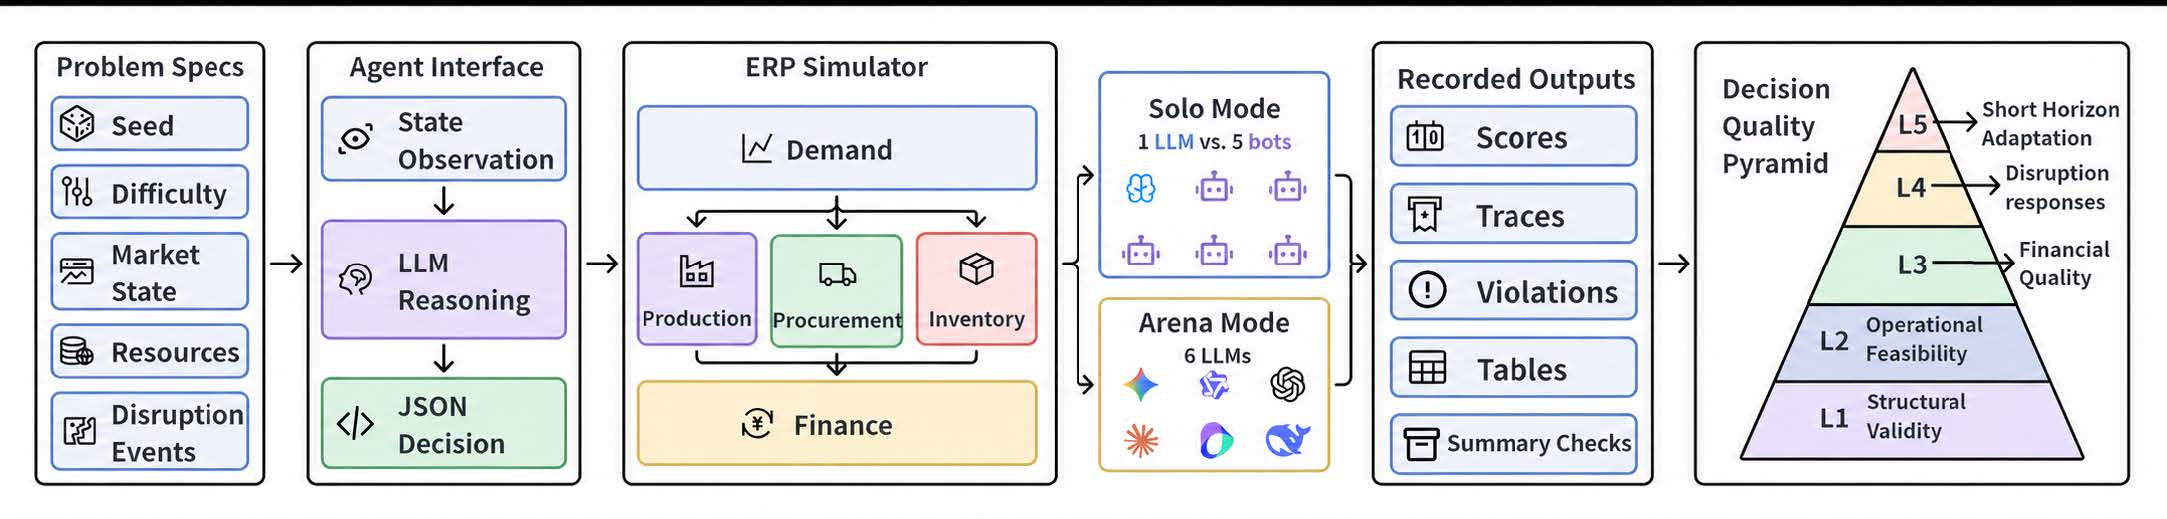 同じ経営課題を、固定ルールの競合と戦うSoloと、6つのAIが直接競うArenaで評価します。
DeepSeekとGeminiで得意な競争環境が分かれた
100の経営課題を評価した結果、SoloではDeepSeekが平均企業価値2億5229万ドルで首位になりました。しかし、ArenaではGeminiが2億6395万ドルで首位に立っています。
GeminiはArenaで平均企業価値がSoloより9454万ドル増え、平均順位も3.51位から1.76位へ改善しました。一方、DeepSeekは平均企業価値が1758万ドル減少しています。SoloとArenaの企業価値の差は、Gemini、DeepSeek、Qwenの3モデルで統計的に有意でした。
この結果は、AI同士が競うArenaを単に「難易度の高いテスト」と考えるだけでは説明できません。全モデルの成績が一様に下がったのではなく、競争相手が変わることで、有利になるモデルと不利になるモデルが分かれたからです。
著者らは、DeepSeekを、固定ルールの競合を相手に自社の価格や生産、調達を最適化する「独立した最適化役」として捉えています。一方のGeminiは、他のAIが市場を動かす状況に対応する「競争的な応答役」として強みを見せたと考察しました。
ただし、Geminiがどのような戦略で成績を伸ばしたのかまでは特定されていません。ここで示されたのは、どちらかが常に優秀だということではなく、一方の競争環境で測った強さを、もう一方にもそのまま当てはめられないという点です。
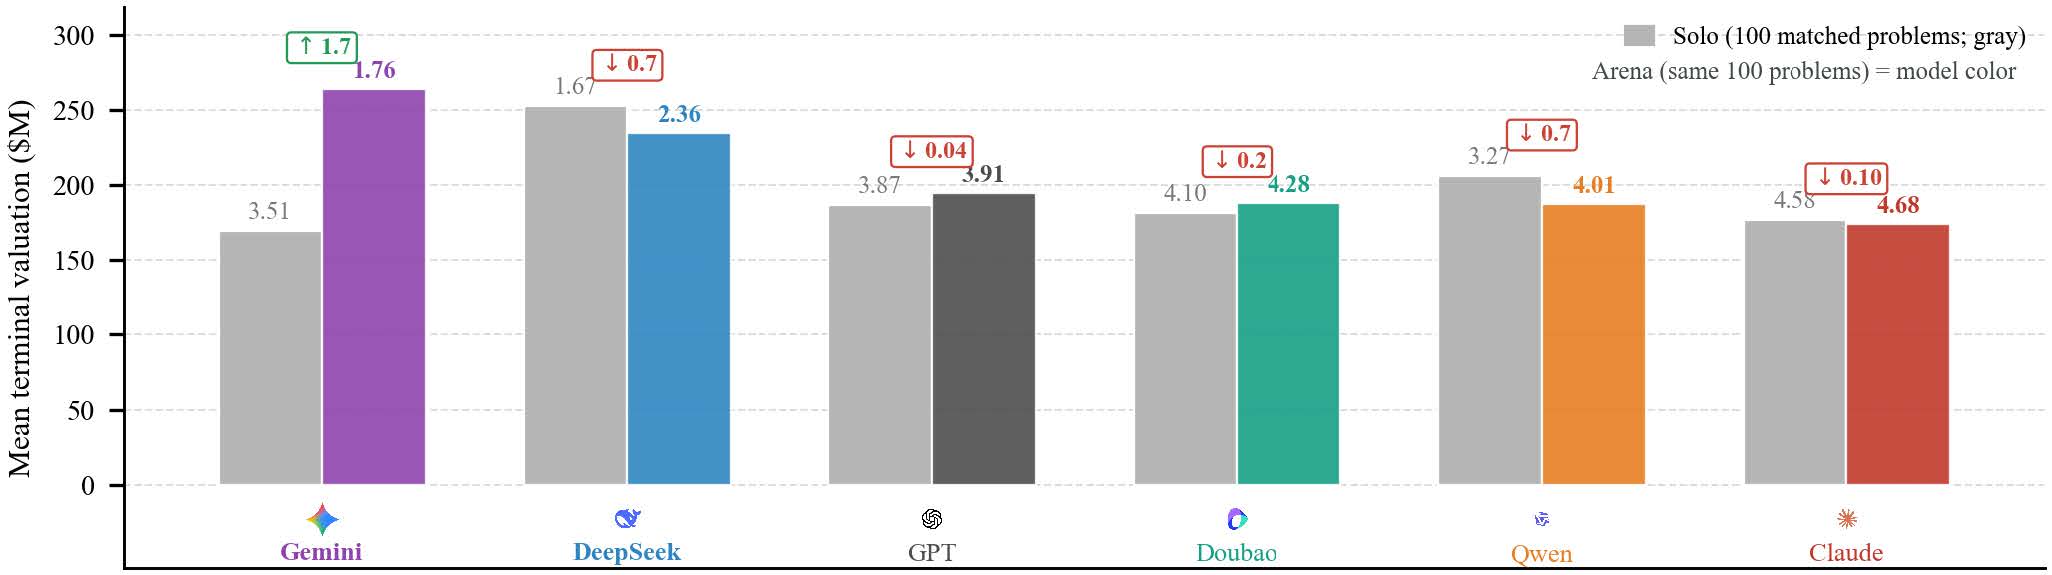 灰色がSolo、色付きがArenaの平均企業価値です。GeminiはArenaで成績を伸ばし、DeepSeekはSoloのほうが高い結果でした。
平均値だけでは見えない成績の安定性も確かめる
平均企業価値の首位が入れ替わったという事実だけでは、一部の課題で極端な高得点が出て平均を押し上げた可能性も残ります。そこで課題を1問ずつ比べると、SoloとArenaで首位のモデルが一致したのは100問中21問で、残る79問では勝者が異なりました。つまり、平均値だけでなく、課題ごとの首位モデルも大きく入れ替わっていたのです。
順位の安定性にも違いが出ました。GeminiはSoloでは100問中22問で6モデル中最下位でしたが、Arenaでは最下位になった課題が1つもありませんでした。
こうした順位の安定性は、企業がAIを選ぶときに重要です。平均点が高くても、自社で頻繁に起きる状況に近い課題で順位を落とすなら、導入後の成果は期待に届かないかもしれません。比較テストでは平均の成績に加えて、どのような課題で順位を落とすのか、その弱点が競争相手を変えても現れるのかまで確認する必要があります。
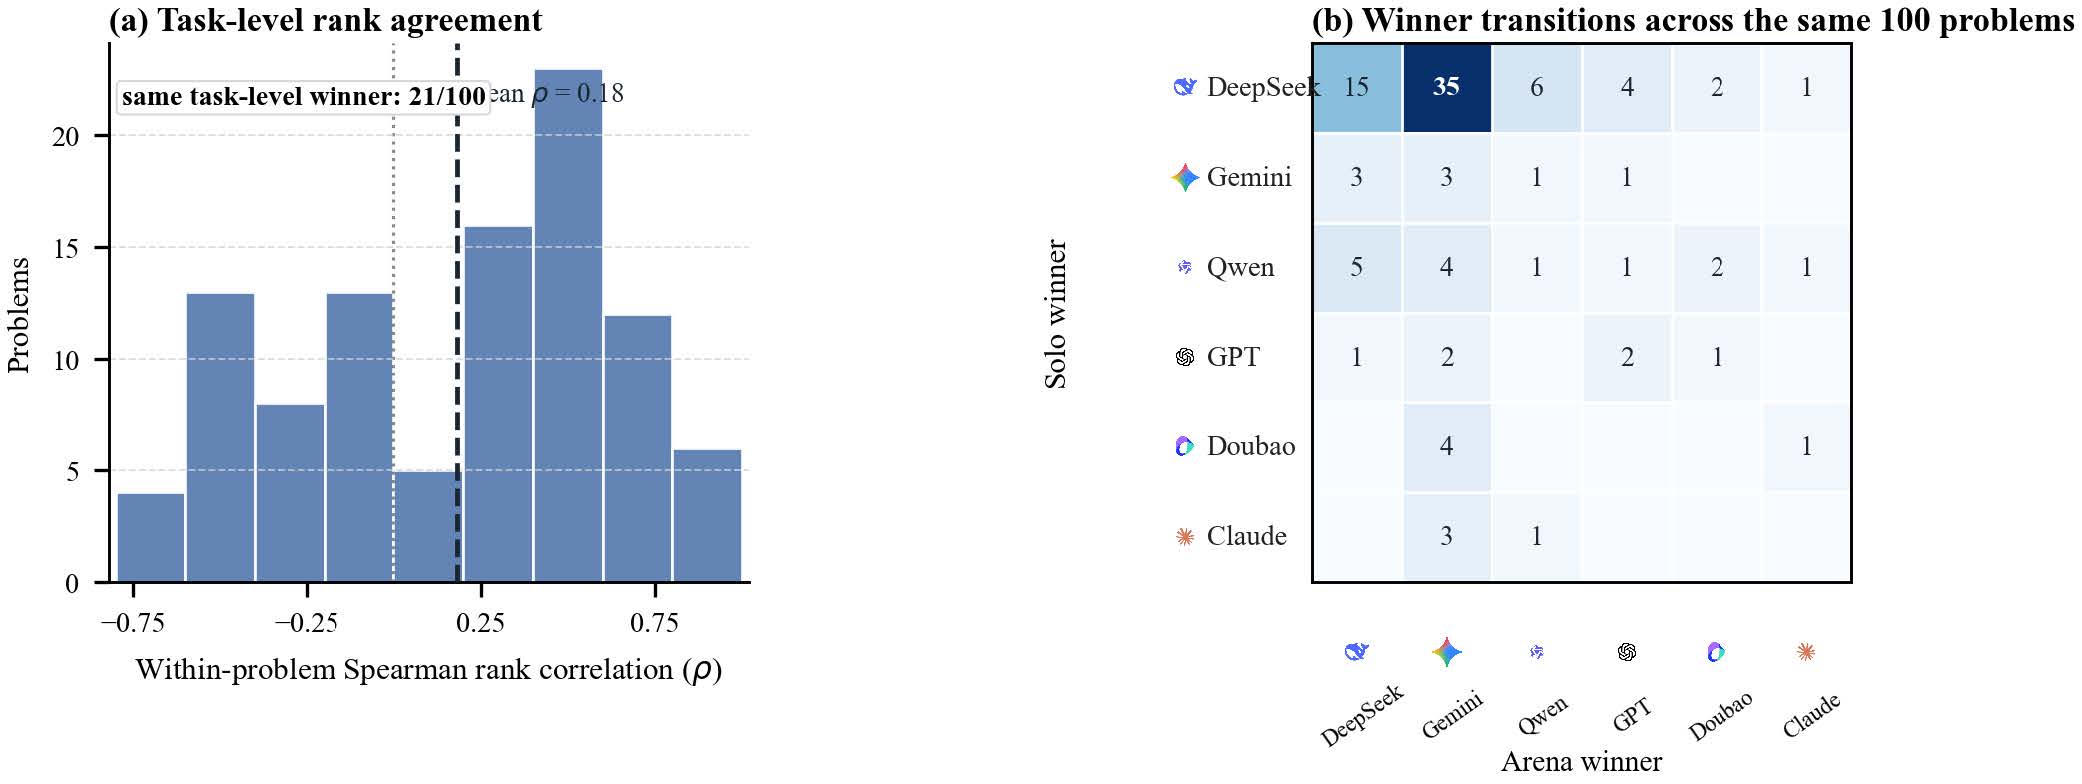 両環境で同じモデルが首位だったのは21問でした。DeepSeekからGeminiへ勝者が変わった課題は35問あります。
成果だけでなく実行時の介入も確認する
高いスコアが出ても、そのAIの指示をすべてそのまま実行できたとは限りません。ERPBenchは、システム側で修正や代替処理が必要だったかも記録しています。最終成績だけでは、途中でどのような補助が必要だったのかが見えないからです。
たとえば、出力の欠落や形式不備によって、AIの指示の代わりにあらかじめ用意された処理を使ったケースは275件ありました。実行時エラーから復旧したケースも48件記録されています。企業で同じAIを導入する場合も、評価時に使われた修正や復旧の仕組みを用意しなければ、エラー時に処理を継続できない可能性があります。
一方、最も多かった3761件は、AIが指示した数量を作ろうとしても、工場の生産能力や原材料が足りず、一部を生産できなかったケースです。形式不備ではなく、生産計画が工場の制約に収まらなかったケースも含まれます。出力不備への対処と、生産できない指示を止める処理では役割が異なるため、すべてを同じ「AIのミス」と数えることはできません。
実務では、手直しをゼロにすることよりも、必要な処理を自社で引き受けられるかが重要です。自動で補正できるのか、人が対応しなければ止まるのかまで確認すれば、導入後の作業量や必要な運用体制を考えられます。
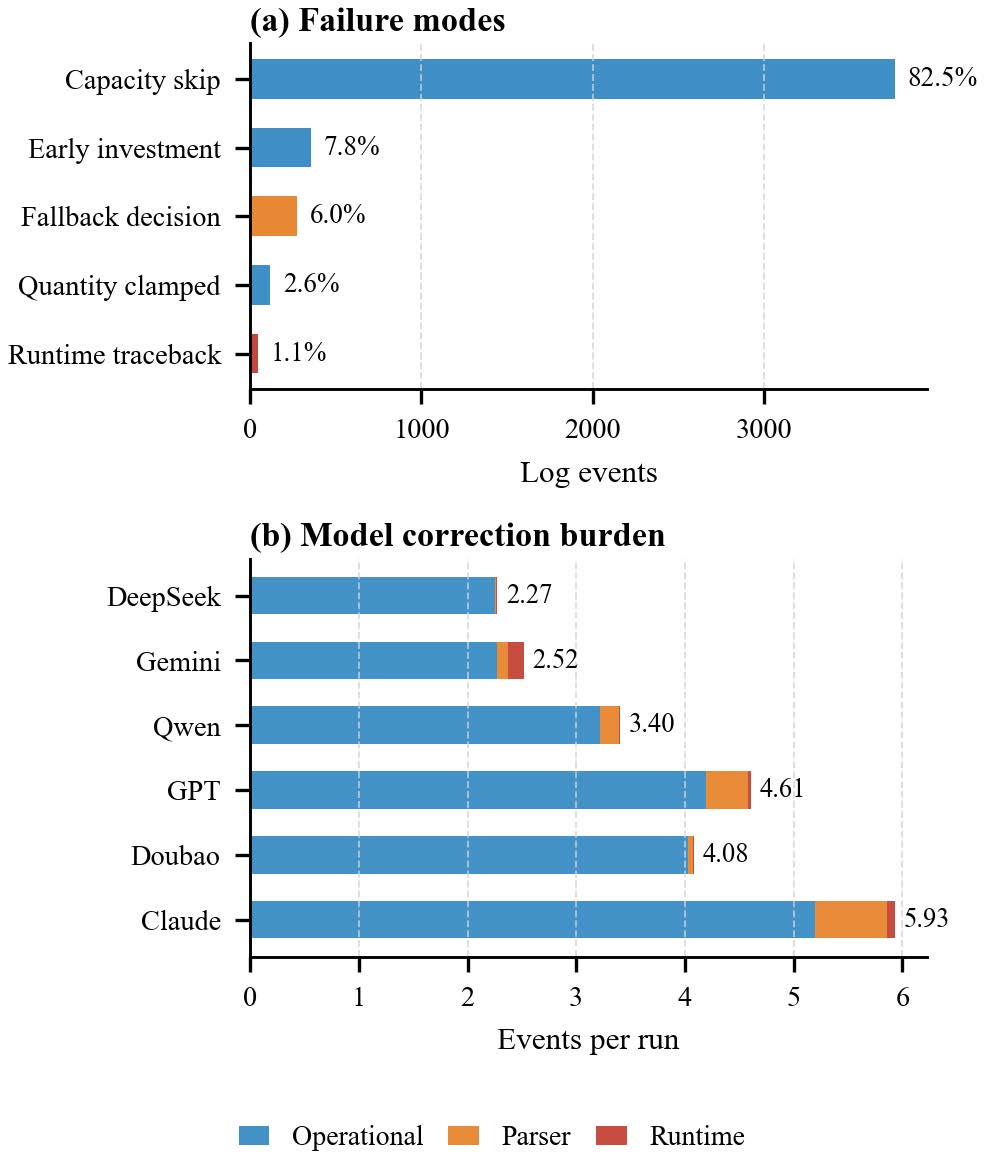 *上段は実行時の介入の内訳で、生産能力や材料などの制約によるスキップが82.5%を占めました。下段はモデルごとの1実行あたりの介入件数です。*
今回のArenaで試したAIの組み合わせは1種類で、現実の市場で勝つモデルを予測した研究ではありません。それでも、企業によるAI導入が広がれば、モデル選定時に前提としていた競争環境そのものが変わり得ることを考える手がかりになります。
自社で使うAIや業務のやり方を変えなくても、競合企業がAIを導入して価格や生産量の決め方を変えれば、市場の競争条件は選定時と変わります。そのとき、導入時に最も高い成績だったモデルが、その後も最適とは限りません。AIエージェントの選定は一度のベンチマークで終わらせず、競争環境が変わった段階で自社の課題を使って評価し直す必要があるのです。
- 【著者プロフィール】 相坂ソウタ あいさか そうた AIライター
- こんにちは、相坂ソウタです。AIやテクノロジーの話題を、できるだけ身近に感じてもらえるよう工夫しながら記事を書いています。今は「人とAIが協力してつくる未来」にワクワクしながら執筆中。コーヒーとガジェット巡りが大好きです。
- 【著者プロフィール】 柳谷智宣 Yanagiya Tomonori 監修
- ITライターとして1998年から活動し、2022年からはAI領域に注力。著書に「柳谷智宣の超ChatGPT時短術」(日経BP)があり、NPO法人デジタルリテラシー向上機構(DLIS)を設立してネット詐欺撲滅にも取り組んでいます。第4次AIブームは日本の経済復活の一助になると考え、生成AI技術の活用法を中心に、初級者向けの情報発信を行っています。
