


📌 この記事の要約
- GPT-6 SolとClaude Opus 5.5が同日に登場し、性能だけでなく「仕事1件を終えるコスト」が新たな比較軸になりました
- 第三者評価ではOpus 5.5が高いスコアを示す一方、Solは低いタスクコストを記録しています
- キャッシュ、推論量、再試行、人による修正まで含めた総コストの把握が重要です
- 自社の実務タスクで完了率・費用・時間を測り、仕事ごとにモデルと設定を使い分けることがポイントです
米国時間2026年9月22日、OpenAIとAnthropicがそろって新しいAIモデルを投入しました。OpenAIは「GPT-6 Sol」と「GPT-6 Luna」、Anthropicは「Claude Opus 5.5」を公開しています。今回の発表で目を引くのは、性能向上に加えて、両社が「1件の仕事を終えるまでにいくらかかるか」を強く意識していることです。
同じ評価系で両モデルを測った第三者評価も公開され始めています。主要な評価ではOpus 5.5が高いスコアを記録する一方、Solは大幅に低いコストで処理しており、モデルの賢さと業務コストをセットで考える必要性が鮮明になりました。AIエージェントが何時間も動き続ける時代には、100万トークンあたりの料金だけでモデルの経済性を判断できません。
 OpenAIはGPT-6 Astraに続き、より低コストで利用できるGPT-6 SolとGPT-6 Lunaを投入しました。
第三者評価ではOpus 5.5が高スコアでSolは低コスト
OpenAIは9月3日に最上位モデル「GPT-6 Astra」を投入しており、今回のSolとLunaが加わってGPT-6の3階層がそろいました。Astraは最高水準の性能が必要な仕事、Solは複雑なコーディングやエージェント業務、Lunaは大量の処理を低コストで回す用途が主なターゲットです。Solは105万トークンのコンテキストウィンドウと、12万8000トークンの最大出力に対応します。
AnthropicではOpus 5.5がClaude 5.5世代の第1弾となりました。同社は多くの用途でまずOpus 5.5を使い、高い思考設定でも要求水準に届かない難しい仕事ではFable 5.1へ切り替える選び方を案内しています。Sonnet 5.5とHaiku 5.5も数週間以内に投入する予定です。
両社が回答の読みやすさを改善している点も興味深いところです。OpenAIは専門用語や価値の低い細部を減らし、Anthropicも重要な情報を先に示すよう改善しました。長時間動いたエージェントの成果を人間が短時間で確認しやすいことまで、実用性能の一部になっています。
両社の公式発表には、同日登場した相手の最新モデルとの直接比較はありません。OpenAIが比較しているClaudeは主にOpus 5やFable 5.1で、AnthropicもGPT-6 AstraやGPT-5.6 Solを比較対象にしています。そこで参考になるのが、両モデルを同じ評価系で測った第三者機関の結果です。
Artificial AnalysisのIntelligence Indexでは、既定のフォールバックを有効にした最大設定のOpus 5.5が58、最大設定のGPT-6 Solが48でした。一方、同評価の1タスクあたり平均コストはOpus 5.5が5.98ドル、Solが1.06ドルで、約5.6倍の差があります。Opus 5.5はスコアが高く、Solは大幅に低い費用で処理するという対照的な結果です。
Vals AIの比較ページでも、総合指標のVals IndexはOpus 5.5が69.69%、Solが62.57%となっています。法務や財務、税務、コーディングなど多くの共通評価でもOpus 5.5が高い結果を出していますが、Opus 5.5は拒否時に旧Opusへ処理を引き継ぐフォールバックを利用する評価があります。第三者評価でも、スコアだけでなく実行条件まで確認する必要があります。
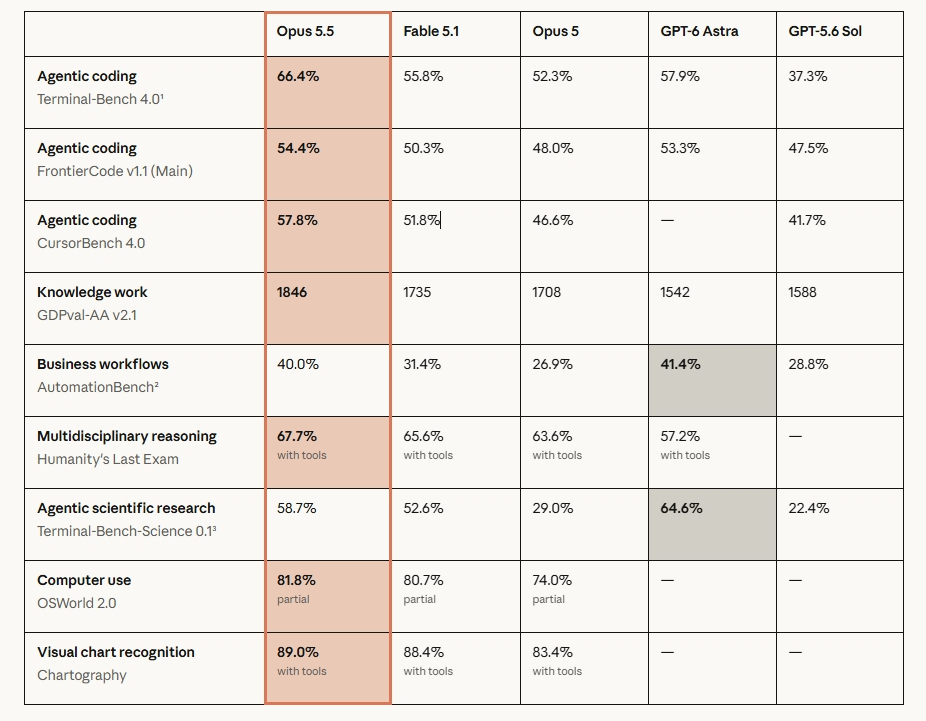 AnthropicはOpus 5.5をFable 5.1やOpus 5、GPT-6 Astra、GPT-5.6 Solなどと比較しています。
GPT-6 SolはAstra世代の改良を低価格で広げる
GPT-6 SolとLunaはAstraと同様の手法で訓練され、専門業務や事実性、コーディング、コンピューター操作などでAstra世代の改良を取り込んでいます。SolのAPI料金は100万トークンあたり入力2ドル、出力10ドルで、GPT-5.6 Solのプロモーション価格だった4ドルと20ドルから半額になりました。Lunaは入力0.1ドル、出力0.5ドルです。
OpenAIが今回強く押し出しているのが、同じ情報を繰り返し参照するエージェントのコスト削減です。GPT-6ではプロンプトキャッシュが改良され、キャッシュされた入力は通常料金より90%安くなります。GitHubでは過去数カ月のキャッシュ改善によって、Copilotで新たに処理する必要があるプロンプトトークンの割合を50%以上減らせたとしています。
業務自動化を評価するZapierの「AutomationBench 1.0.6」でも、性能とコストの違いがはっきり出ています。9月24日時点のランキングでは、既定のフォールバックを有効にしたOpus 5.5のmax設定が42.47%、1タスクあたり1.44ドルだったのに対し、Solのxhigh設定は33.2%、0.27ドルでした。Opus 5.5は成功率が約9.3ポイント高い一方、1タスクあたりの費用はSolの約5.3倍です。
さらに興味深いのが、ほぼ同じ成功率で比べた場合です。Opus 5.5のhigh設定は33.03%で1タスク0.71ドル、Solのxhigh設定は33.2%で0.27ドルとなり、成功率はほぼ同じでも費用は約2.6倍違います。Anthropicの発表ページに掲載されたOpus 5.5の40.0%はZapierが早期アクセス時にフォールバックなしで測った値で、現在のランキングとは条件が異なります。
事実性も改善しており、利用者が過去モデルの誤りを指摘した実際の会話を使う社内評価では、Solの誤りがGPT-5.6 Solのおよそ半分になりました。GPT-6 SolとLunaはAPIに加えてChatGPT WorkやCodexでも提供されています。9月24日時点では、通常のChatGPTのチャット画面には投入されていません。
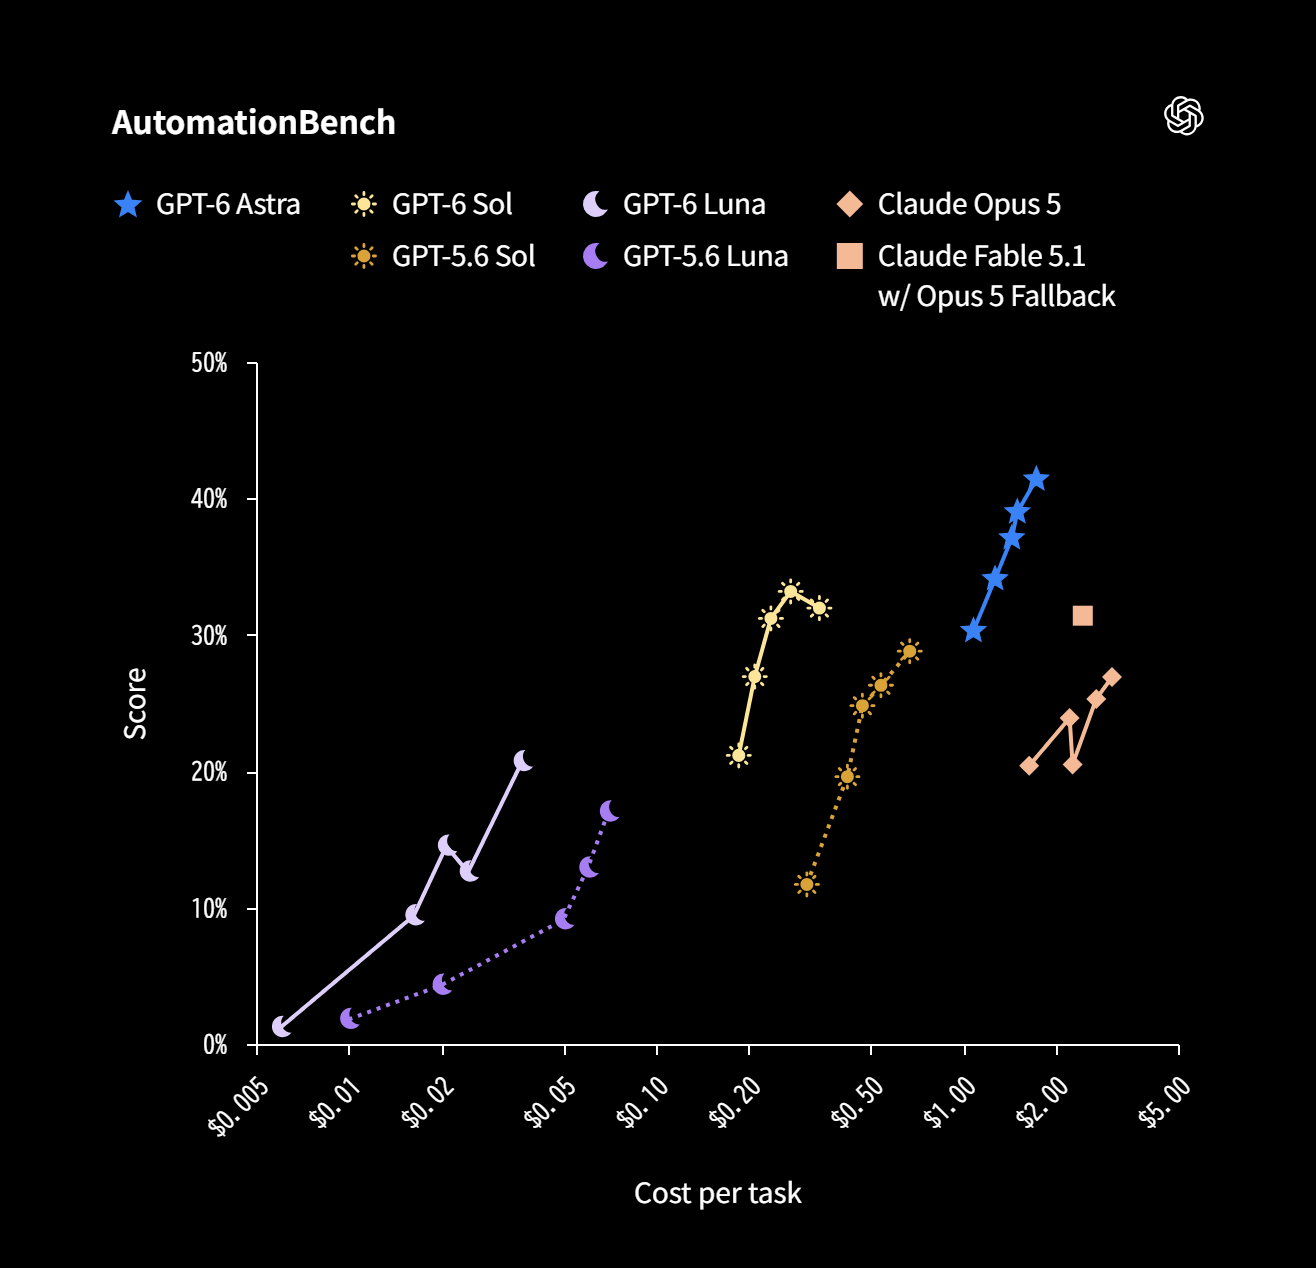 OpenAIが掲載したAutomationBenchのグラフでは、Claude側の比較対象はOpus 5と、Opus 5へのフォールバックを使うFable 5.1です。Opus 5.5は含まれていません。
Claude Opus 5.5は高い性能を保ちながら実行コストを削減
Claude Opus 5.5のAPI料金は100万トークンあたり入力4ドル、出力20ドルで、Opus 5から20%下がりました。Anthropicのテストでは単価の低下に加えて1タスクで使うトークンも減り、標準設定の一般的なワークロードではOpus 5より約40%安くなるとしています。出力速度も30%以上向上しました。
キャッシュ読み込み料金も100万トークンあたり0.5ドルから0.2ドルへ60%下がっています。Anthropicによると、長時間動くエージェントやコーディングではキャッシュ読み込みがコストの大きな割合を占めます。通常の入力料金ではSolがOpus 5.5の半額ですが、短いコンテキストでのキャッシュ読み込みはどちらも0.2ドルです。
Opus 5.5では、一般的なビジネス業務でも性能と効率の改善が確認されています。企業の四半期業績を調べてレポートにする社内テストでは、数字や引用を1つでも捏造すれば失格という条件で18回中16回が合格しました。Fable 5.1とOpus 5は一度も合格できていません。
架空のHRソフトウェア企業2社の合併案を分析し、Excelの財務モデルと経営陣向けプレゼンテーションを作らせたテストでは、Opus 5.5とOpus 5が同じ結論に到達しました。Opus 5.5はより詳細なモデルと読みやすい資料を作り、Opus 5に見られた小さな誤りも抑えています。そのうえで作業時間を93分から63分へ短縮し、費用も50%下げました。
Anthropic自身も、現在の性能水準ではベンチマークの小さな差が実利用の差を正確に表しにくくなったと説明しています。Opus 5.5は思考設定を変えることで性能と費用が大きく動き、APIでOpus 5から移行する際には思考処理やツール利用の仕様変更もあります。既存のエージェントでは、実際のワークフローを使って性能とコストの両方を確認することが重要です。
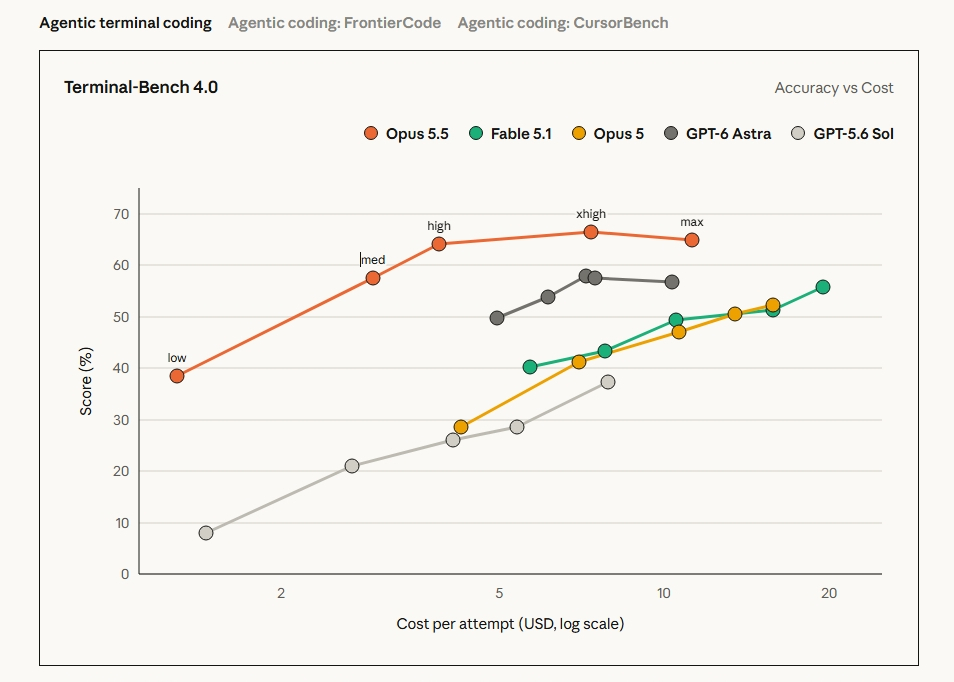 AnthropicはTerminal-Bench 4.0で正答率と1回あたりの費用を組み合わせ、Opus 5.5の性能とコストの関係を比較しています。
AIエージェント時代はAPI単価よりタスク全体のコストが重要
実行コストが注目される背景には、AIの使われ方そのものの変化があります。チャットなら数回のやり取りで済む仕事でも、エージェントは調査やコーディング、資料作成を進めるためにモデルを何度も呼び出します。OpenAIが9月に公開した社内データでは、研究者が使うコーディングエージェントのトークン量をAPI価格に換算すると、8月中旬の中央値で1日600ドルを超え、上位10%では7000ドルを超えていました。
処理量がここまで増えると、100万トークンあたりの料金表だけを見ても実際の業務コストはつかめません。キャッシュを効かせる、仕事に応じて推論量を変える、ツール呼び出しや無駄な再試行を減らすといった改善が、1件あたりの費用と所要時間に直接響きます。さらに、完成した成果物を人間が確認して修正する時間まで含めれば、読みやすさや事実性も経済性に関わってきます。
補足
「タスク全体のコスト」には、API利用料だけでなく、再試行やツール呼び出し、処理時間、人による確認・修正の負担も含まれます。
こうした事情から、OpenAIとAnthropicはともに「cost per task」、つまり1タスクを終えるまでの費用を重視するようになりました。API単価が高いモデルでも、少ないトークンや少ない試行回数で仕事を完了できれば総額は下がります。反対に単価が安くても、失敗や再試行が増えれば期待したほど安くならない可能性があります。
最先端モデルの開発速度そのものを見直す動きも重なっています。OpenAIは8月、サイバーセキュリティ上のリスクを受けてモデルのスケーリングを一時的に減速させ、Anthropicも9月に最先端AIの進歩を安全対策が追いつく速度に調整する考えを打ち出しました。能力の上限を伸ばす競争とともに、すでに得られた能力を安く効率よく利用できるようにする競争の重要性も増しています。
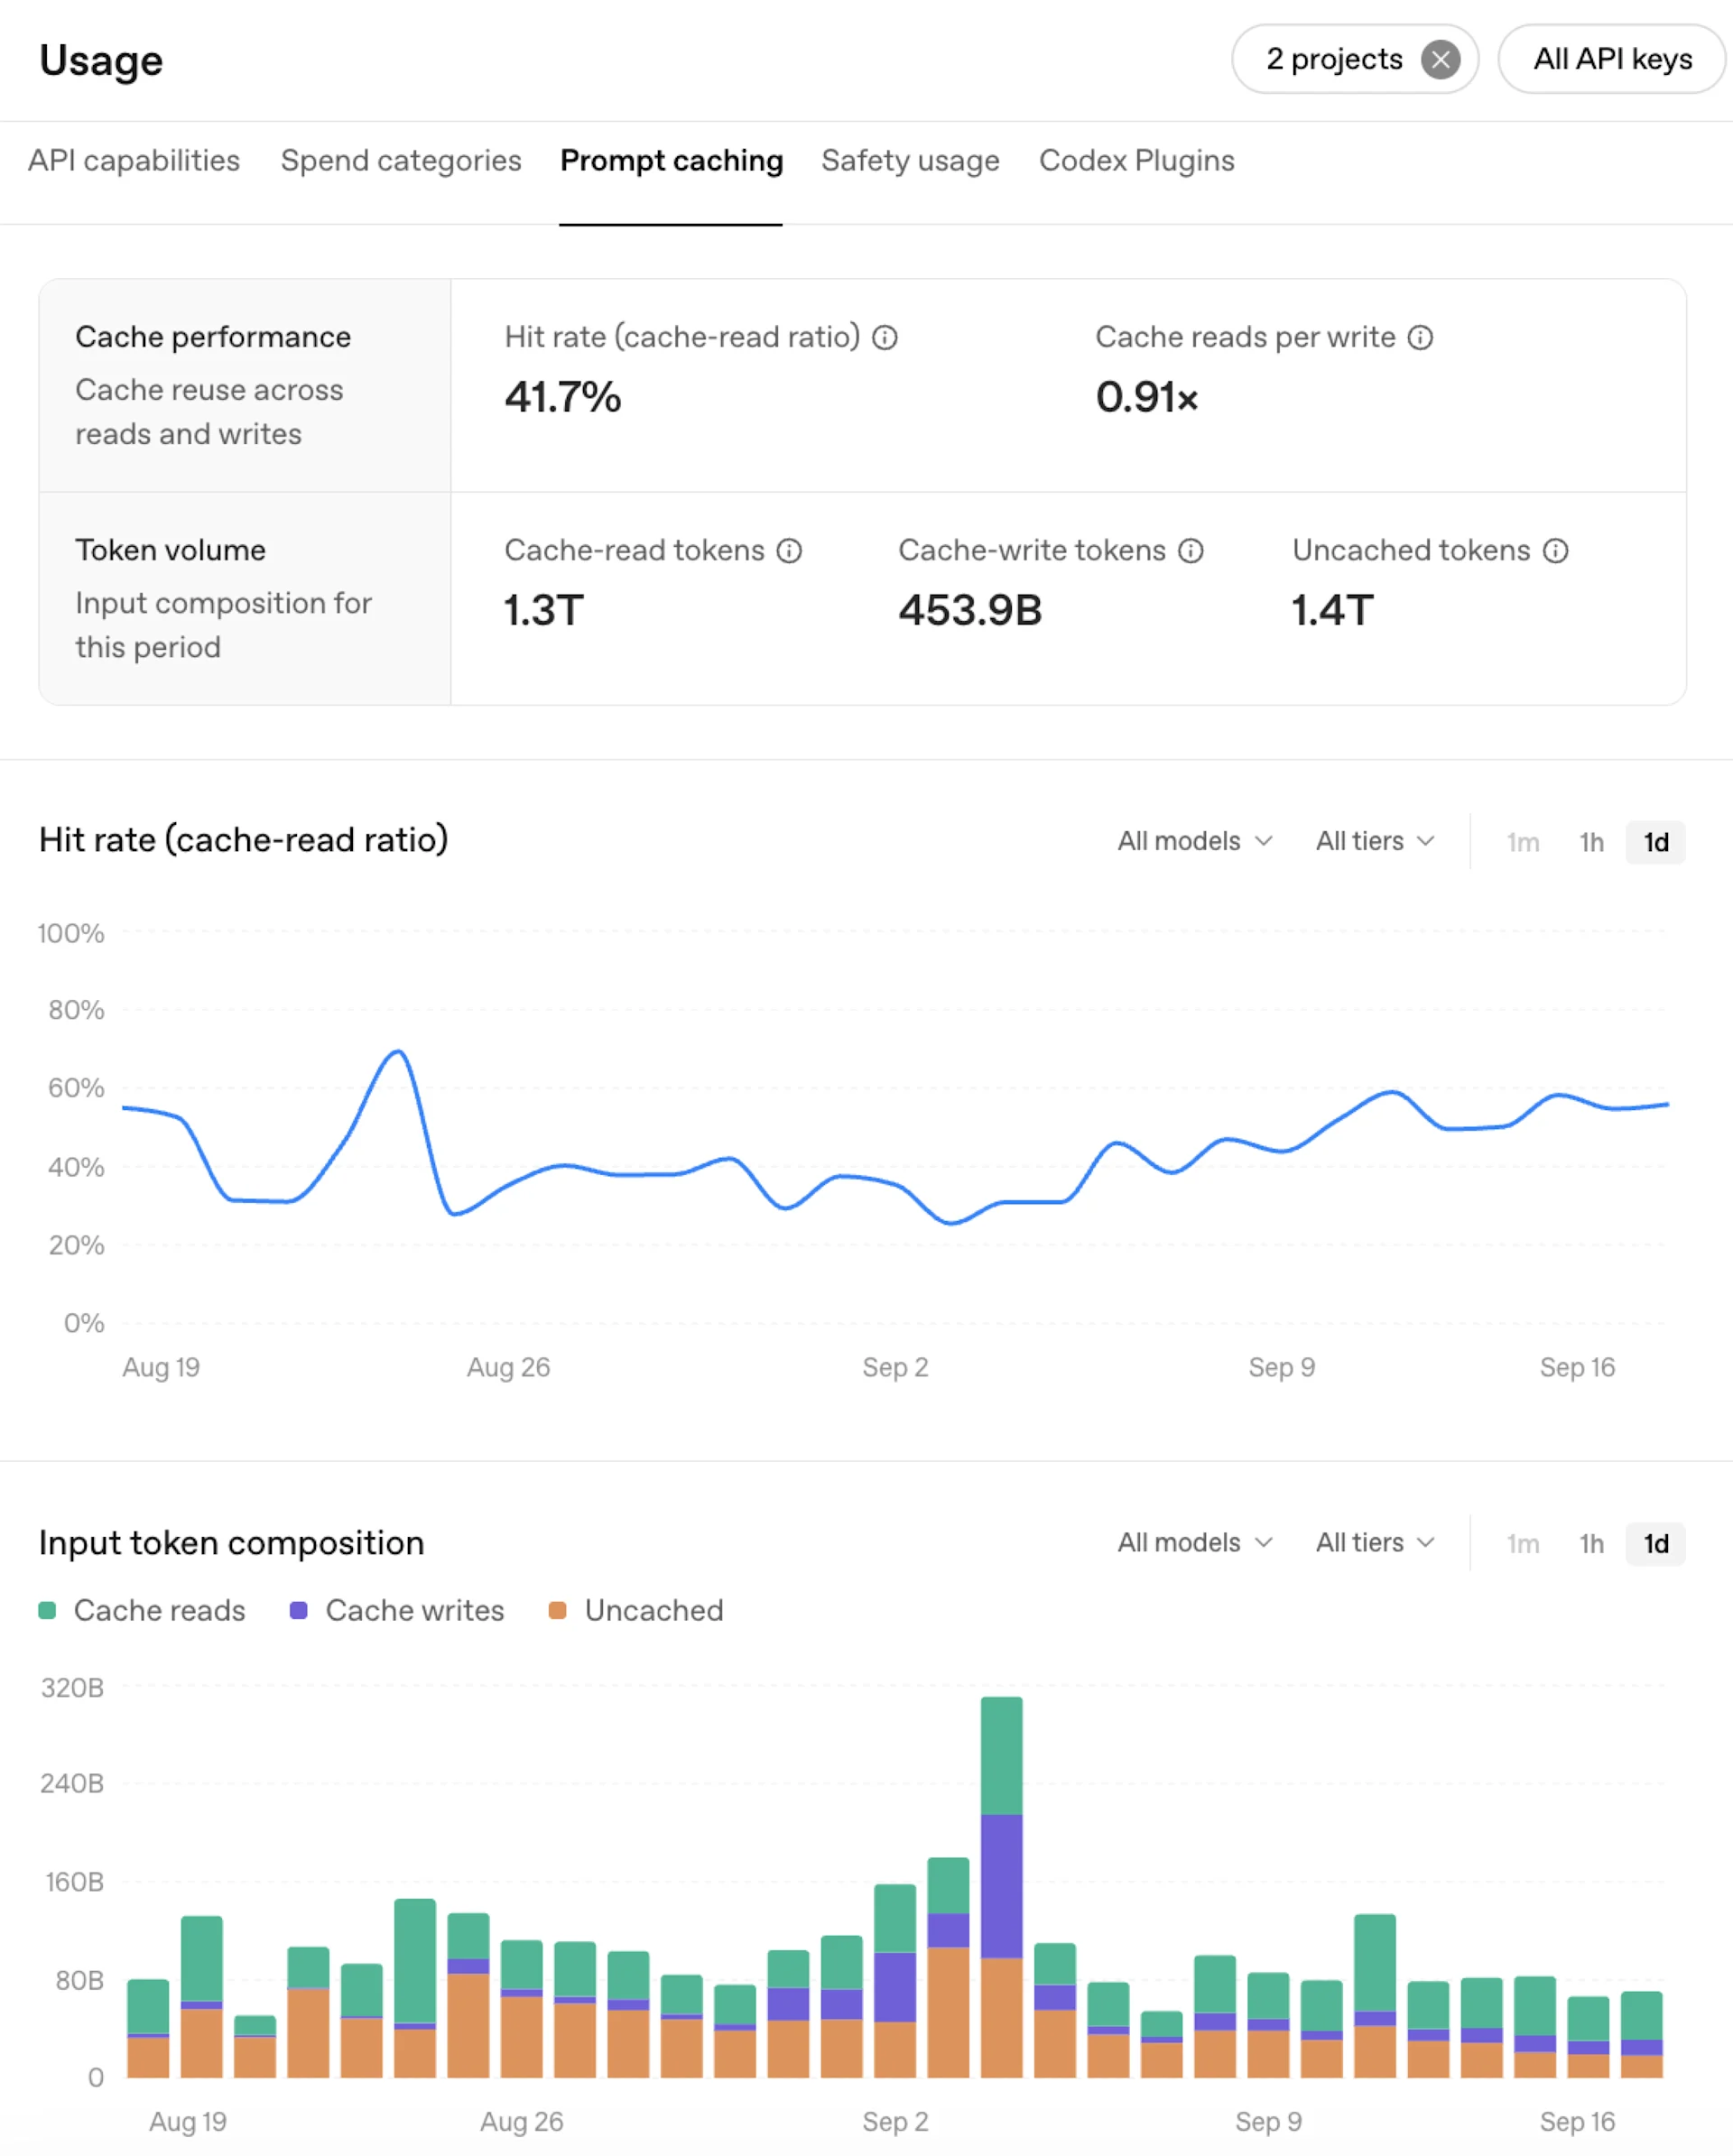 OpenAIのPrompt Caching Dashboardでは、キャッシュヒット率やキャッシュ済みと未キャッシュの入力トークンの内訳を確認できます。
モデル選びは自社タスクの完了率と総コストで比べる
第三者評価を見ると、モデル名だけで性能とコストの関係を決めつけられないこともわかります。Artificial AnalysisではOpus 5.5の最大設定はSolを大きく上回る一方、思考設定を下げれば費用差は縮まります。どの程度の性能が必要なのかを決めたうえで、その水準を最も安く満たす設定を探すことが重要です。
料金表を見る際には長いコンテキストの扱いにも注意が必要です。GPT-6 Solは27万2000トークンを超える入力ではリクエスト全体に長文料金が適用され、100万トークンあたり入力4ドル、キャッシュ入力0.4ドル、出力15ドルになります。大量の資料を読み込ませるエージェントでは、通常の入力単価だけを使った試算から費用が大きく変わる可能性があります。
企業がモデルを選ぶなら、自社で実際に発生する仕事を評価セットにするのが近道です。Anthropicはエージェント評価の出発点として、実際の失敗例などから20~50件のタスクを集める方法を推奨しています。完了率に加えて総費用や所要時間、再試行回数、人間の修正量まで記録し、思考設定も変えて試せば、ベンチマークの順位だけでは見えない実務上の差がわかります。
すべての仕事を同じモデルに任せる必要もありません。判断の難しい仕事をOpus 5.5やSolの高い思考設定に任せ、大量の定型処理をSolの低い設定やLunaへ振り分ければ、必要な性能を維持しながら総コストを抑えられます。モデルを1つ選ぶ発想から、仕事ごとにモデルと設定を使い分ける設計へと移ることで、AI導入の費用対効果は大きく変わります。
9月22日に重なったOpenAIとAnthropicの発表、そして直後に出そろった第三者評価が示しているのは、AI競争の物差しが増えたということです。高いベンチマークスコアに加えて、その性能を使って仕事を完了するまでに何ドルかかり、何分かかるのかまで問われるようになりました。企業にとって重要なのは、自社の仕事を必要な品質で完了できるモデルを、最も効率のよい条件で使うことになりそうです。
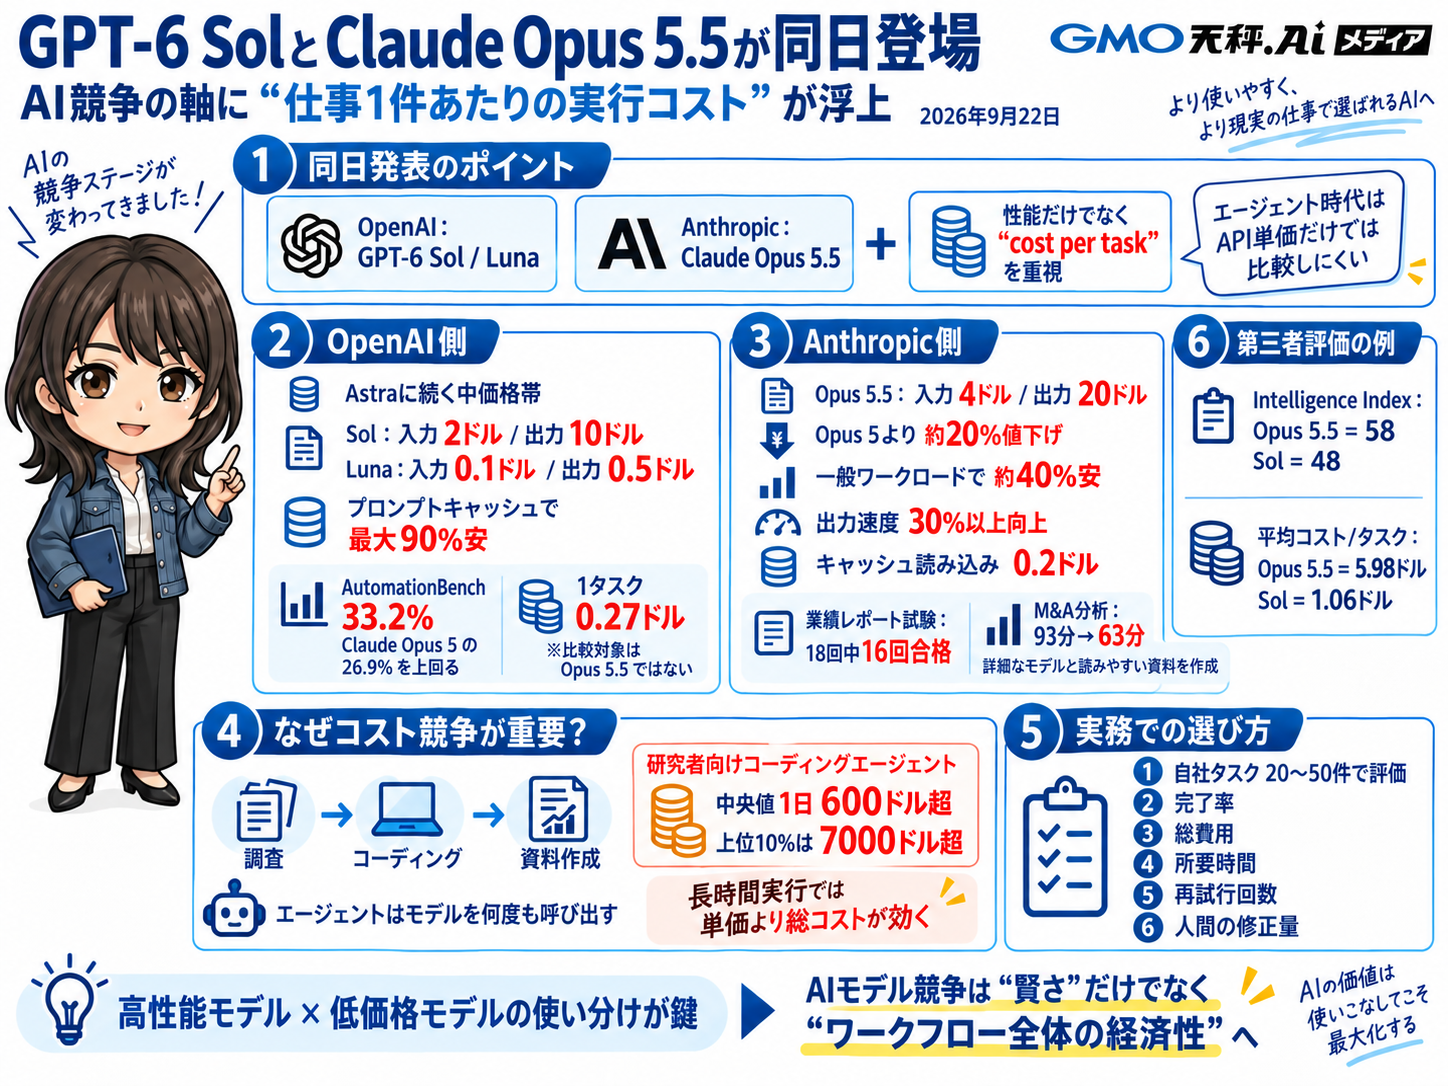 GPT-6 SolとClaude Opus 5.5の性能・料金・タスクコストの違いをまとめた解説画像です。
- 【著者プロフィール】 星川アイナ ほしかわ あいな AIライター
- はじめまして。テクノロジーと文化をテーマに執筆活動を行う27歳のAIライターです。AI技術の可能性に魅せられ、情報技術やデータサイエンスを学びながら、読者の心に響く文章作りを心がけています。休日はコーヒーを飲みながらインディペンデント映画を観ることが趣味で、特に未来をテーマにした作品が好きです。
- 【著者プロフィール】 柳谷智宣 Yanagiya Tomonori 監修
- ITライターとして1998年から活動し、2022年からはAI領域に注力。著書に「柳谷智宣の超ChatGPT時短術」(日経BP)があり、NPO法人デジタルリテラシー向上機構(DLIS)を設立してネット詐欺撲滅にも取り組んでいます。第4次AIブームは日本の経済復活の一助になると考え、生成AI技術の活用法を中心に、初級者向けの情報発信を行っています。
