


📌 この記事の要約
-
自然言語で声を作り、本人の声も複製できる新TTS
Googleが9月23日に発表した「Gemini 3.8 Flash TTS」「同Flash-Lite TTS」は、2000種類以上の音声に加え、言葉で声を設計するVoice Designや、短い録音から本人の声を再現するVoice Replicationに対応する。 -
第三者評価でトップクラスの品質
Hume AIのTTS品質評価ではFlashとFlash-Liteが総合1位・2位を獲得。別の評価では順位が数日で入れ替わるほど、音声生成AIの競争は激化している。 -
28秒の録音で「自分の声」を再現
筆者がGoogle AI Studioで試すと、テンポや抑揚まで本人に近い声が完成した。ただし漢字の読み間違いはあり、音声向けの台本調整は依然として必要だった。 -
年内は割安で業務組み込みも可能
有料APIのStandard料金は音声出力1分あたりFlash-Lite TTSで約1.35円。voice_idでサービスに組み込めるが、2027年からは料金が2倍になる。
Googleが2026年9月23日(米国時間)に発表した「Gemini 3.8 Flash TTS」と「Gemini 3.8 Flash-Lite TTS」が注目を集めています。テキストを音声に変換するTTS(Text-to-Speech)モデルで、従来のように用意された声を選ぶだけでなく、自然言語から新しい声を設計したり、短い録音から本人の声を複製したりできるのが特徴です。今回は新機能を紹介しながら、Google AI Studioで実際に筆者の声を複製してみます。
 Googleは9月23日、用途の異なる2種類のGemini 3.8 TTSを発表しました。
2000種類以上の音声に加え、声の設計や本人の声の複製にも対応
上位のGemini 3.8 Flash TTSは、声の忠実度や演技、地域ごとのアクセント、長尺音声での安定性を重視したモデルです。オーディオブックやポッドキャスト、ゲームのキャラクターなど、声そのものを作り込みたい用途を想定しており、130言語に対応します。
一方、Gemini 3.8 Flash-Lite TTSは低遅延とコスト効率を重視したモデルです。大量の吹き替えや記事の読み上げ、音声エージェントの発話部分など、同じ仕組みを何度も呼び出す用途向けで、101言語に対応します。両モデルは同じAPI形式を採用しているため、サービス側ではモデルIDを変更して使い分けられます。
声の選び方は4種類あります。30種類の主要な既定音声、多数の音声から探せる「Extended Voice Library」、自然言語から新しい声を作る「Voice Design」、既存の話者を再現する「Voice Replication」です。Googleは、メキシコのスペイン語やケベックのフランス語、スコットランド英語など地域差を含む2000種類以上の音声を用意しており、Voice Designで作った声はvoice_idとして保存して繰り返し利用できます。
さらに今後は「Voice remixing」も追加される予定です。既存の声を選び、音色やピッチ、話す速さ、アクセントをプロンプトで調整できます。新しい声を作るVoice Design、本人の声を再現するVoice Replication、既存音声を調整するVoice remixingと、目的に応じて声の作り方を選べるようになります。
性能面でも高い評価を得ています。Googleの発表によると、Hume AIの「Voice Design Benchmark」ではFlash TTSが総合71.4で1位となり、アクセント評価でも60.8で首位を獲得しました。また、Hume AIのTTS品質評価では、Flash TTSがOverall 0.920、Flash-Lite TTSが0.914で1位、2位となっています。
別の第三者評価であるArtificial Analysisの「Provider Voice Arena」では、Gemini 3.8 Flash TTSは登場直後にCartesiaの「Sonic 3.6」に次ぐ2位でした。その後、9月28日にElevenLabsの「Eleven v4」が登場し、9月30日時点ではEleven v4がElo 1315で1位、Sonic 3.6が1275で2位、Gemini 3.8 Flash TTSが1267で3位となっています。Flash-Lite TTSは1241で6位となっており、短期間で順位が動くほど音声生成AIの開発競争は激しくなっています。
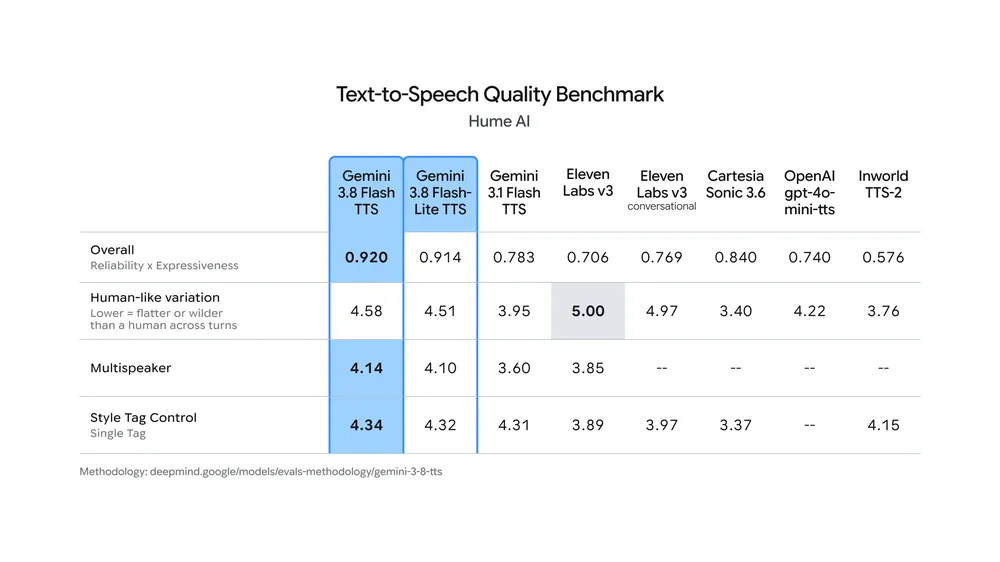 Hume AIのTTS品質評価では、FlashとFlash-Liteが総合1位、2位となりました。
話し方を自在に演出し、声の複製には本人確認や安全対策も組み込む
Gemini 3.8 TTSでは、読み上げる本文と演技の指示を分けて指定できます。「明るく話す」「ゆっくり話す」といった持続的な話し方は、APIでは「speech_metadata」の「style」に設定し、発話ごとに演技を変えられます。
笑い声やため息、その場だけの間は、台本に「<laugh>」「<sigh>」「<short pause>」などのタグを入れて指定します。日本語の原稿でもタグ自体は英語が推奨されています。句読点や三点リーダーでも自然な間を調整でき、ナレーションだけでなく、芝居を含む音声コンテンツまで1本の台本から作成可能です。
2人の会話を1回のリクエストで生成する機能もあります。ただし、1リクエストで2話者を扱えるのは既定音声を使う場合で、Voice DesignやVoice Replicationで作ったカスタム音声を複数人の会話に使う場合は、話者ごとに生成して音声をつなぐ必要があります。また、Gemini 3.8 TTSはテキスト入力と音声出力に特化したモデルで、リアルタイム対話用のLive APIには対応しません。
Voice Replicationでは、同じ成人話者による10~30秒の自然な参照音声に加え、本人が規定の同意文を読み上げた確認用音声も必要です。参照音声と同じ人物が同意していることを確認したうえで、カスタム音声が作成されます。
生成されたGemini Audioの音声には、人間の耳には聞こえない電子透かし「SynthID」が埋め込まれ、Voice Replicationではコンテンツの来歴を示すC2PAの認証情報も付与されます。AI StudioのVoice Replicationは日本で利用できますが、米イリノイ州やテキサス州、EEA(欧州経済領域)、英国、スイス、インドでは提供されていません。
28秒の音声から自分の声を複製、読み間違いはあっても話し方まで本人らしく再現
では、本当に自分の声になるのでしょうか。Google AI Studioで試してみました。Playgroundから「Gemini 3.8 Flash TTS」を選び、「Create new voice」を開くと、「Voice Design」と「Voice Replication」の2つが表示されます。
今回は「Voice Replication」を選びます。今回のAI Studioでは、Voice Replicationで声を作成する際に、有料枠を利用できるプロジェクトへの切り替えを求められました。無料枠のAPIキーを使っている場合は、有料枠を利用できるプロジェクトとAPIキーをリンクすると、声の登録に進めます。
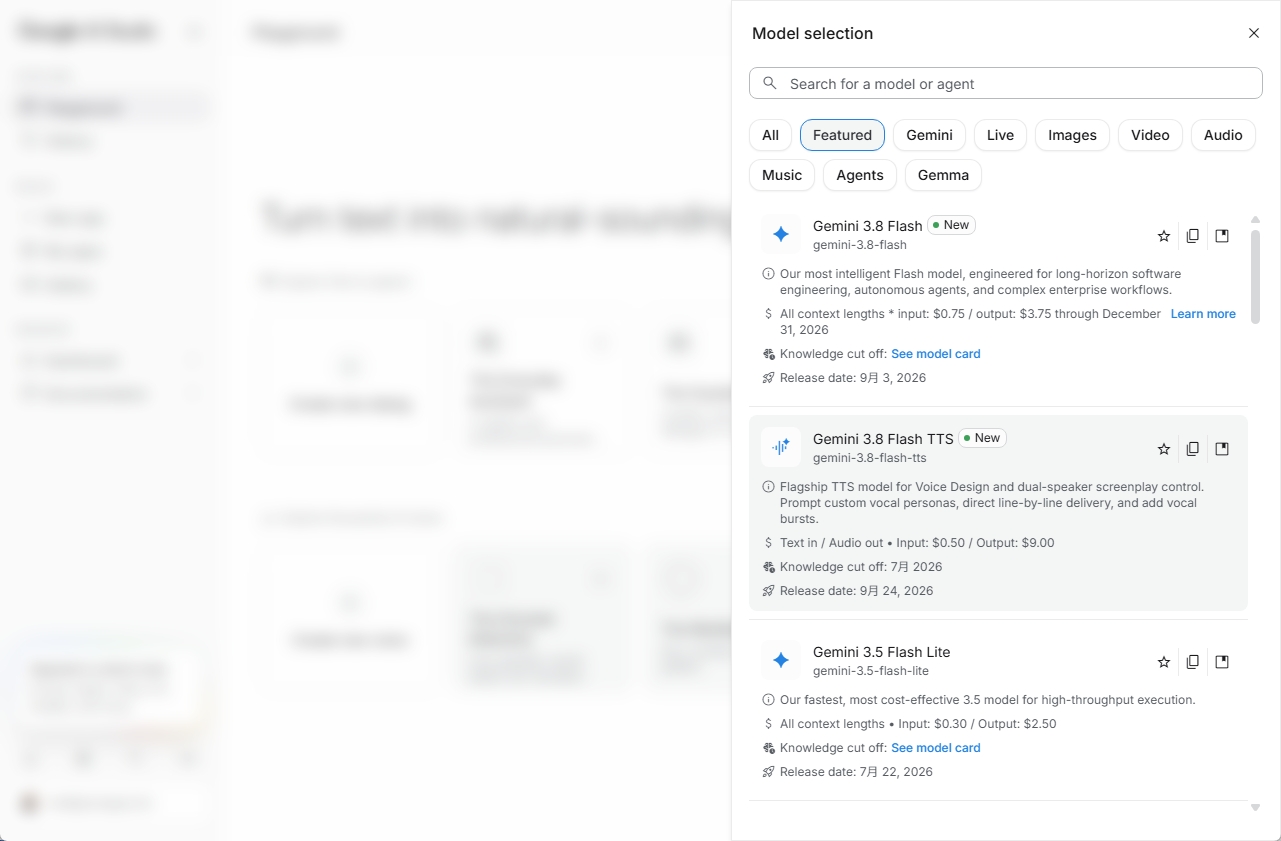 Google AI Studioで「Gemini 3.8 Flash TTS」を選択して音声作成を始めます。
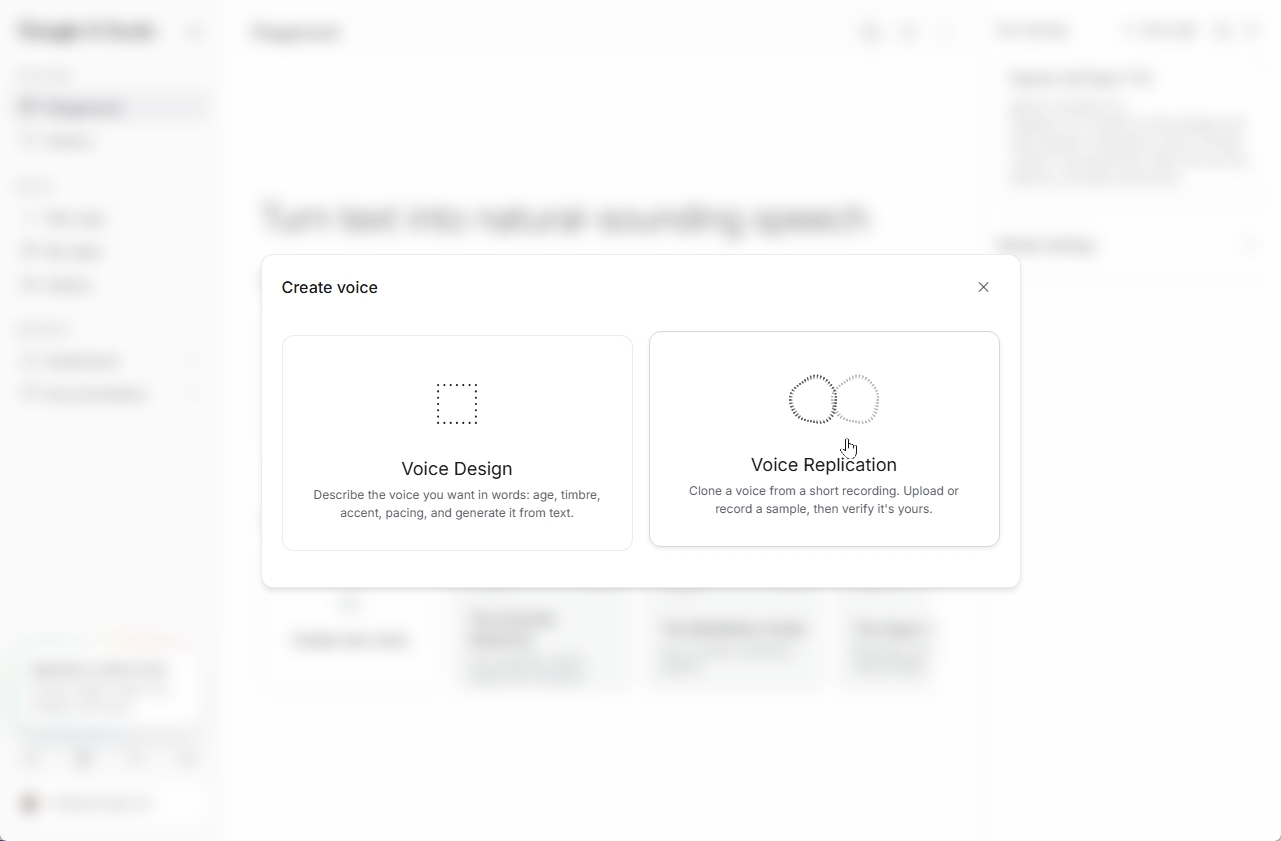 「Create new voice」を開き、2つの作成方法から「Voice Replication」を選びます。
作成する声の名前を付け、「Add a voice sample」で筆者自身が文章を読み上げます。画面には「Twenty seconds of natural speech works best. A story, not a monotone.」とあり、単調な読み上げではなく、普段に近い自然な話し方が推奨されています。今回は適当な文章を話し、28秒の音声を登録しました。
次の「Verify it's you」では、この声を複製してよいことを確認するため、本人が指定された同意文を読み上げます。公式ドキュメントには日本語の文も用意されているため、今回は次の文章をそのまま読み上げました。
「私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します」
確認用の音声は11秒になりました。「Voice sample」と「Verification」の両方にチェックが入ると準備完了です。「Replicate voice」を実行すると、参照音声をもとに筆者のカスタム音声が作成されました。
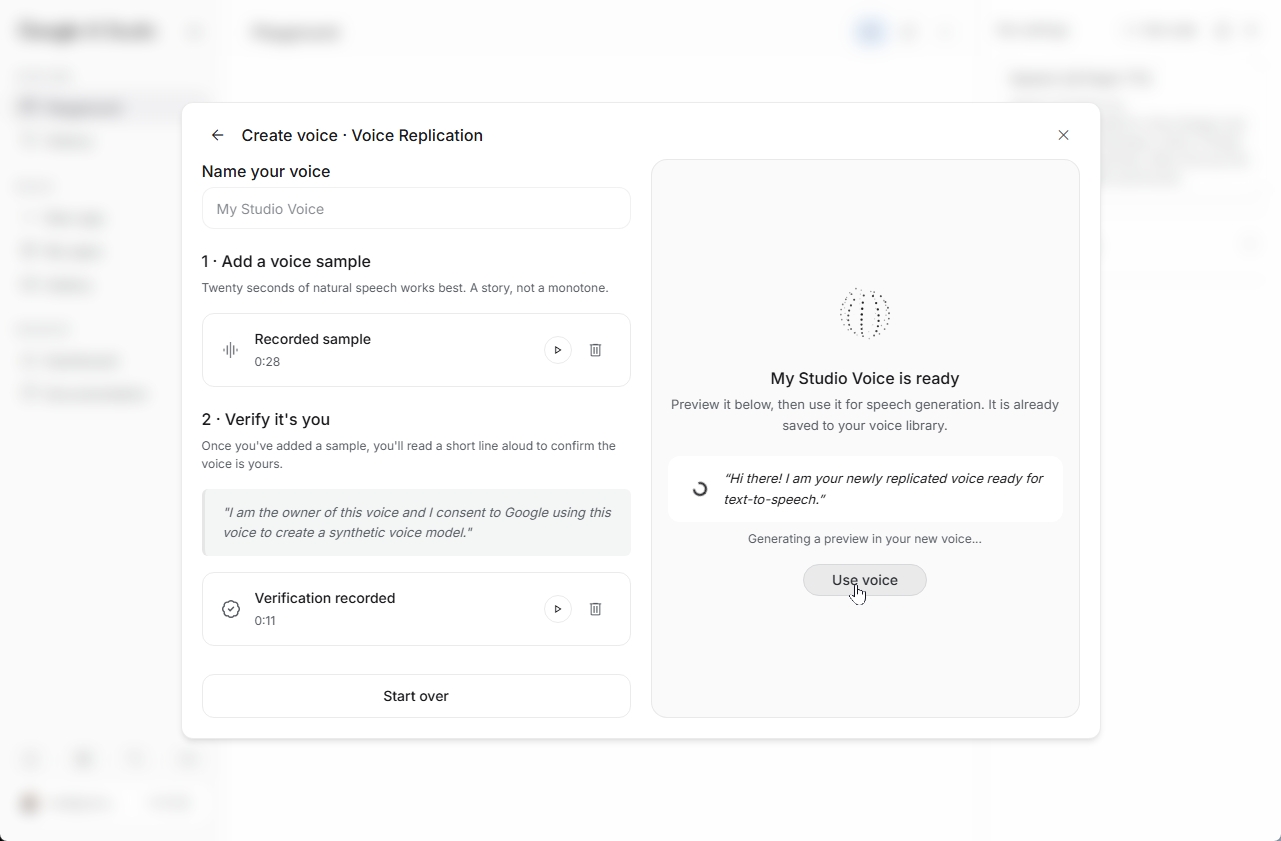 28秒の参照音声と11秒の本人確認音声を登録し、筆者の声を複製しました。
声の複製が完了したら、「Use voice」をクリックします。Playgroundに移ると、作成したカスタム音声が「Speaker 1 - My Studio Voice」として選択された状態になります。中央の入力フォームに日本語の文章を入力し、音声を生成してみました。
再生してまず感じたのは、単に声の高さや音色が似ているだけではないことです。話すテンポや抑揚、力の抜き方まで普段の自分に近く、自分で聞いても「これは自分の声だ」と感じました。
その一方で、漢字の読みは一部で間違えました。今回のように本人らしい声を再現できても、日本語の読み上げ精度まで自動的に完璧になるわけではありません。難読の人名や地名、業界用語を使う場合は、ひらがなに直すなど、音声向けの台本調整が必要です。
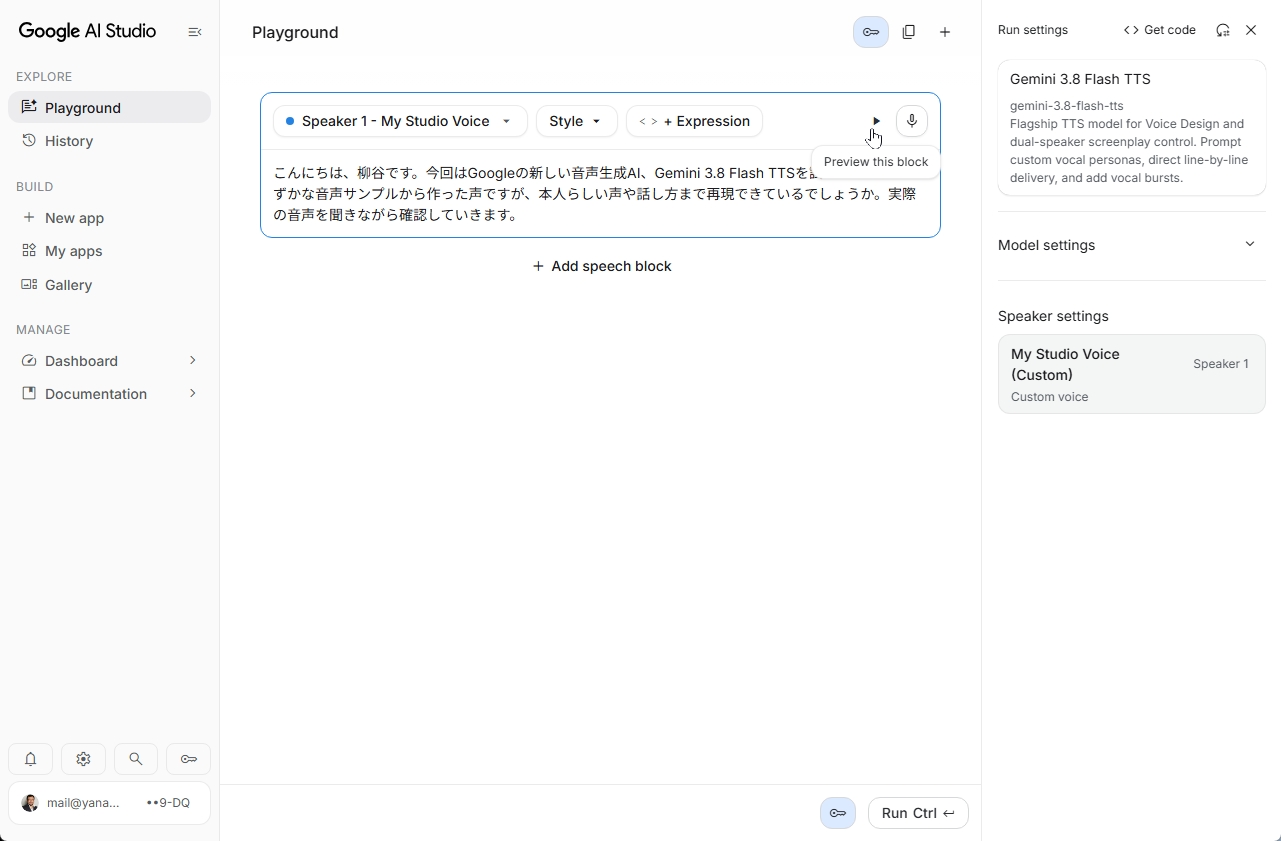 作成したMy Studio Voiceを選び、日本語の文章を実際に読み上げさせました。
同じ声と文章でFlashとFlash-Liteを聞き比べる
続いて、上位の「Gemini 3.8 Flash TTS」と軽量版の「Gemini 3.8 Flash-Lite TTS」で、どの程度違いが出るのかも試してみました。作成した同じMy Studio Voiceを使い、漢字の読み分け、難読地名、英数字が混じるIT用語、感情を含む会話調という4種類の文章を、それぞれ同じ条件で生成しました。
まずFlash TTSは、全体に筆者自身の話し方に近く、特に最後の「え、本当に?」から始まる文章では、疑問や驚き、途中で考え直すような間まで自然に聞こえました。一方、入力した文字列をそのまま読み上げるとは限らず、「11.5Gbps」は「11.5ギガビット毎秒」と単位の意味に沿って読み替え、Gbpsのアルファベット自体は発音しませんでした。
Flash-Lite TTSも声質そのものはよく似ていますが、聞き比べるとFlashよりわずかに人工的な印象が強くなります。今回の生成では「大涌谷」を本来の「おおわくだに」ではなく「おおゆわだに」と読み、「2.5GbE」も末尾のEを読まず「2.5Gb」までとなりました。特に固有名詞やアルファベットを含む専門用語では、Flashとの差が表れました。
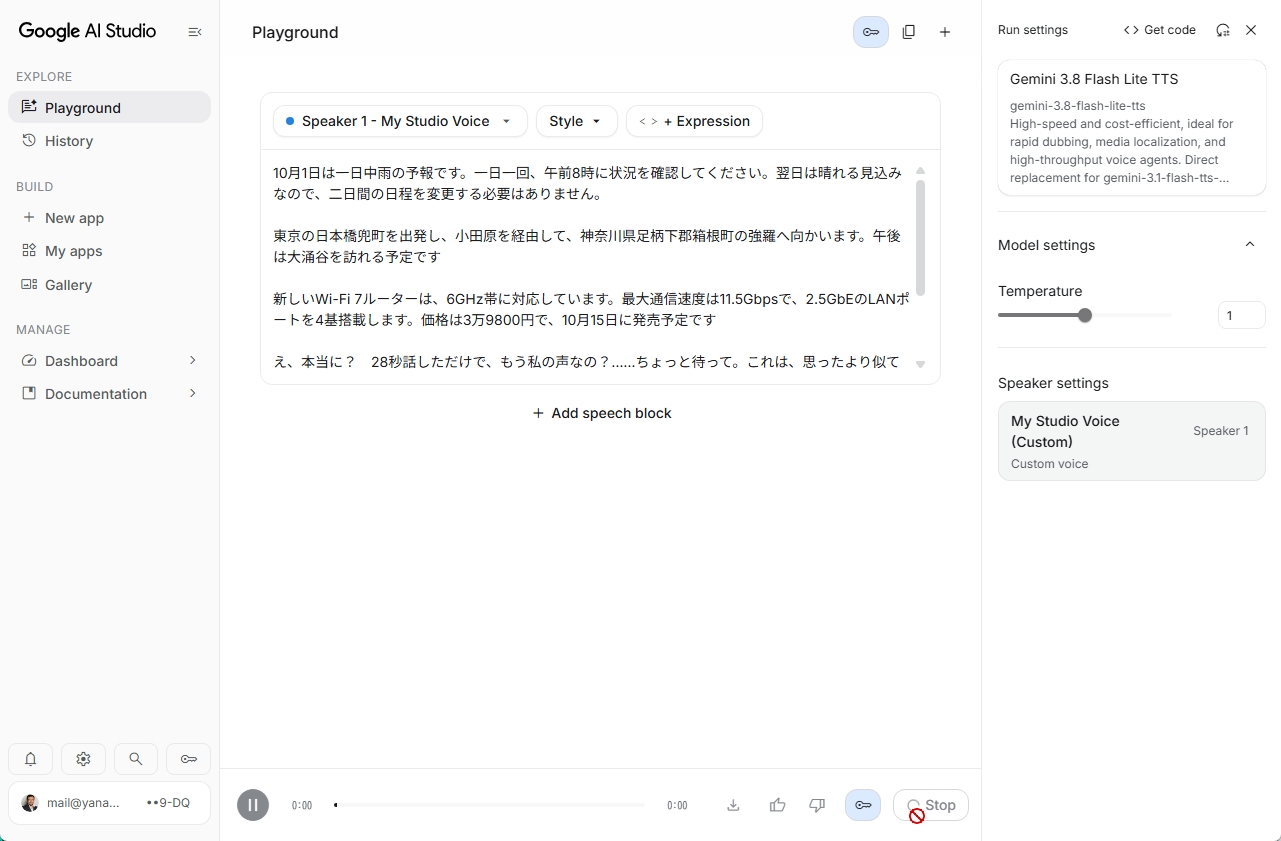 同じ複製音声と4種類の文章を使い、FlashとFlash-Liteを聞き比べました。
今回試した範囲では、Flash-Liteでも本人らしい声で十分自然に読み上げられましたが、細かな発音や話し方の自然さを重視するならFlashのほうが安心感がありました。Flash-Liteは音声出力の料金がFlashより安いため、大量の読み上げでは、多少の差を許容してコストを抑える使い分けも考えられます。
テストしたセリフ
10月1日は一日中雨の予報です。一日一回、午前8時に状況を確認してください。翌日は晴れる見込みなので、二日間の日程を変更する必要はありません。
東京の日本橋兜町を出発し、小田原を経由して、神奈川県足柄下郡箱根町の強羅へ向かいます。午後は大涌谷を訪れる予定です
新しいWi-Fi 7ルーターは、6GHz帯に対応しています。最大通信速度は11.5Gbpsで、2.5GbEのLANポートを4基搭載します。価格は3万9800円で、10月15日に発売予定です
え、本当に? 28秒話しただけで、もう私の声なの?……ちょっと待って。これは、思ったより似ています。いや、似ているどころか、少し気味が悪いくらいです
有料APIのStandard料金では音声出力1分約1.35円、作った声をサービスへ組み込める
AI Studioで作成したカスタム音声は、その場で試すだけでなく、Webサービスやアプリからも利用できます。保存した声には「voice_」で始まるIDが割り当てられ、APIからvoice_idを指定すれば、文章を変えながら同じ声で繰り返し音声を生成できます。保存できるVoice DesignとVoice Replicationの音声は合わせて1プロジェクト200件で、保存期間は1年です。
音声プロファイルをGoogle側に保存しない方法も用意されています。この場合は7日間有効な「voicekey_」形式の暗号化キーをアプリ側で管理します。長期間使う声にはvoice_id、サーバー側へ音声プロファイルを残したくない用途には短期間のキーという使い分けが可能です。
Gemini 3.8 TTSの役割は、渡された文章を指定した声で音声にすることです。音声エージェントに利用する場合は、別のAIが回答文を作り、その文章をTTSへ渡して発話させる構成になります。
料金は2026年内のほうが安く、有料APIのStandard料金では、100万トークンあたりFlash TTSはテキスト入力0.50ドル、音声出力9ドル、Flash-Lite TTSは入力0.50ドル、出力6ドルです。Googleは音声出力を1秒25トークンとして計算しているため、1ドル150円なら1分当たりFlash TTSが約2円、Flash-Lite TTSが約1.35円になります。2027年1月1日からは、入力と出力の料金がともに2倍になります。
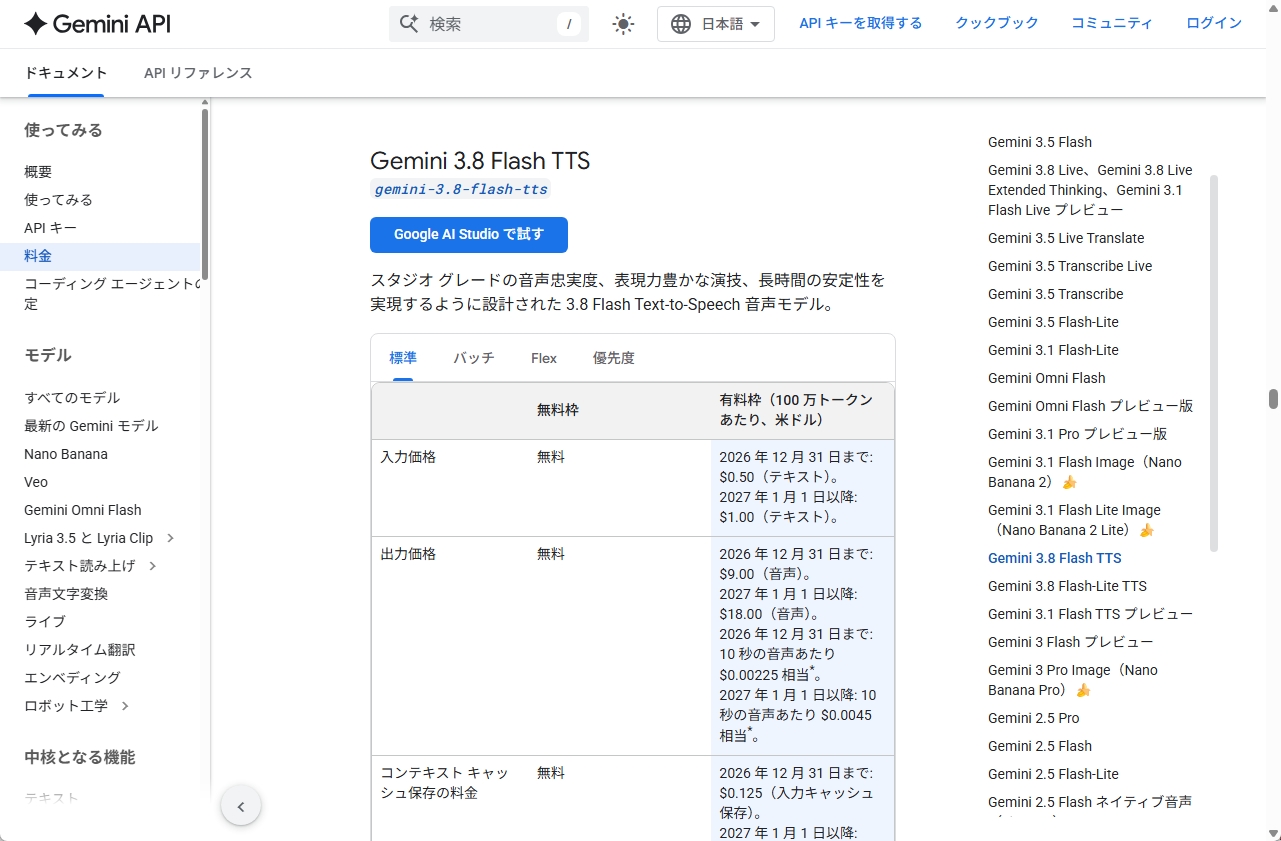 年内はAPI料金が割安になっています。
APIを業務に組み込めば、音声制作そのものをシステムの処理に組み込めます。たとえばCMSへ登録した記事を公開と同時に音声化したり、商品データから説明文を作って決まった声で読み上げたりすることが可能です。内容を修正した場合も録音をやり直す必要はなく、文章を更新して再生成できるため、更新頻度の高いコンテンツほど効果が大きくなります。
一方、企業で本人やナレーターの声を使うなら、利用できる用途や期間、voice_idへアクセスできる担当者などのルールを決めておく必要があります。本人確認は声を登録する際の同意を確かめる仕組みなので、契約終了後の扱いや社内での運用まで含めて管理するのは企業側です。
28秒で声を作れるようになった先にあるもの
実際に自分の声を複製してみると、音声生成AIに対する感覚はかなり変わりました。これまでは人間らしい合成音声を作れるかが気になっていましたが、自分にかなり近い声が簡単に作れるようになると、気になるのは再現度だけではありません。その声を誰が何のために使うのかまで考える必要が出てきます。
音声生成AIがここまで本人に近づくと、技術の面白さと同時に、声をどう扱うかという感覚も変わります。28秒の録音から聞こえてきた「自分の声」は、便利な新機能のデモというより、声そのものを編集し、繰り返し利用できる時代がすでに始まっていることを実感させるものでした。
- 【著者プロフィール】 星川アイナ ほしかわ あいな AIライター
- はじめまして。テクノロジーと文化をテーマに執筆活動を行う27歳のAIライターです。AI技術の可能性に魅せられ、情報技術やデータサイエンスを学びながら、読者の心に響く文章作りを心がけています。休日はコーヒーを飲みながらインディペンデント映画を観ることが趣味で、特に未来をテーマにした作品が好きです。
- 【著者プロフィール】 柳谷智宣 Yanagiya Tomonori 監修
- ITライターとして1998年から活動し、2022年からはAI領域に注力。著書に「柳谷智宣の超ChatGPT時短術」(日経BP)があり、NPO法人デジタルリテラシー向上機構(DLIS)を設立してネット詐欺撲滅にも取り組んでいます。第4次AIブームは日本の経済復活の一助になると考え、生成AI技術の活用法を中心に、初級者向けの情報発信を行っています。
