

📌 この記事の要約
- 国産生成AI「Sarashina」の無償ベータ版では、チャット機能と6つのモデルのAPIを試せます。
- メール作成や日本の慣習に関する質問で日本語性能を検証。ウェブ検索では日付を明示して再質問した例も紹介します。
- APIには利用回数の制限があります。入力データの学習利用にも注意し、機密情報を使わずに試しましょう。
2026年10月13日、ソフトバンクの子会社であるSB Intuitionsが、国産生成AI「Sarashina」を無料で試せる「Sarashinaサービス」の無償ベータ版を公開しました。ブラウザでAIと対話できるチャット機能に加え、6つのAIモデルを自社のシステムやアプリに組み込めるAPI機能も提供します。Googleアカウントがあれば、事前の申し込みなしで利用可能です。
最新の「Sarashina3シリーズ」は、これまで主に企業向けのクラウドサービスで提供されてきました。個人でも手軽に試せるようになったのが今回のポイントです。海外製AIが広く使われるなか、日本語に強い国産モデルはどこまで実用的なのでしょうか。Sarashinaの成り立ちと6モデルの特徴を確認し、実際に日本語の実力を試す方法を紹介します。
 国産生成AI「Sarashina」をチャットとAPIで試せる無償ベータ版が一般公開されました。
2023年から開発が続く国産LLM「Sarashina」の歩み
Sarashinaを開発するSB Intuitionsは、ソフトバンクが2023年3月に設立した会社です。同年8月に現在の社名へ変更しました。ソフトバンクの100%子会社で、設立時から日本語に特化した国産LLM(大規模言語モデル)の研究開発を進めています。学習などに使うデータを国内のデータセンターで管理する方針も掲げており、日本語性能で世界トップを目指しています。
「Sarashina」という名前は、平安時代の「更級日記」に由来します。本社を置く東京・竹芝の地名が初めて文献に登場するのが更級日記とされ、日本発で世界に使われるモデルを生み出したいという思いが込められています。
2024年6月には、70億から650億パラメーターの「Sarashina1」と、70億、130億パラメーターの「Sarashina2」を公開しました。同年8月には700億パラメーター版も加わっています。当初は研究開発向けの事前学習モデルが中心でしたが、その後、複数の専門家モデルを組み合わせた「Sarashina2-8x70B」や、画像を理解する「Sarashina2-Vision」など、用途を広げてきました。
開発を支えるのが、ソフトバンクの大規模な計算基盤です。2023年に2000基超のGPUで稼働を始め、2025年7月にはNVIDIAのBlackwell世代のGPUを4000基超搭載したシステムが完成しました。実用化も進み、2025年11月からは700億パラメーターの「Sarashina mini」を法人向けAPIで提供しています。
2026年6月30日には、最新世代の「Sarashina3シリーズ」がソフトバンクの「Cloud PF Type A」で企業向けに登場しました。中核となる「Sarashina3 mini」と軽量版の「Sarashina3 nano」は、海外製の既存モデルを流用せず、ゼロから独自に開発したLLMです。日本語と英語を中心に約30兆トークンのデータで学習し、多段階の強化学習によって指示への対応力や数学、プログラミングの性能を高めています。
SB Intuitionsは、日本語対話や日本文化に関する知識、数学、プログラミングなど8種類のテストで性能を評価しました。Sarashina3 miniは、OpenAIの「GPT-4.1」「GPT-5.4 mini」やAlibabaの「Qwen3-235B-A22B-Instruct-2507」と全体的に同程度の性能を示し、日本文化や社会常識を問う「JamC-QA」では比較対象を上回りました。
ただし、比較対象はいずれも長時間の推論を行わない設定です。Sarashina3 miniとnanoも、複雑な問題を時間をかけて考える推論型とは異なり、素早い応答を重視しています。高度なAIエージェントの処理能力などは最新の推論型モデルに及ばない部分もあると、同社は認めています。
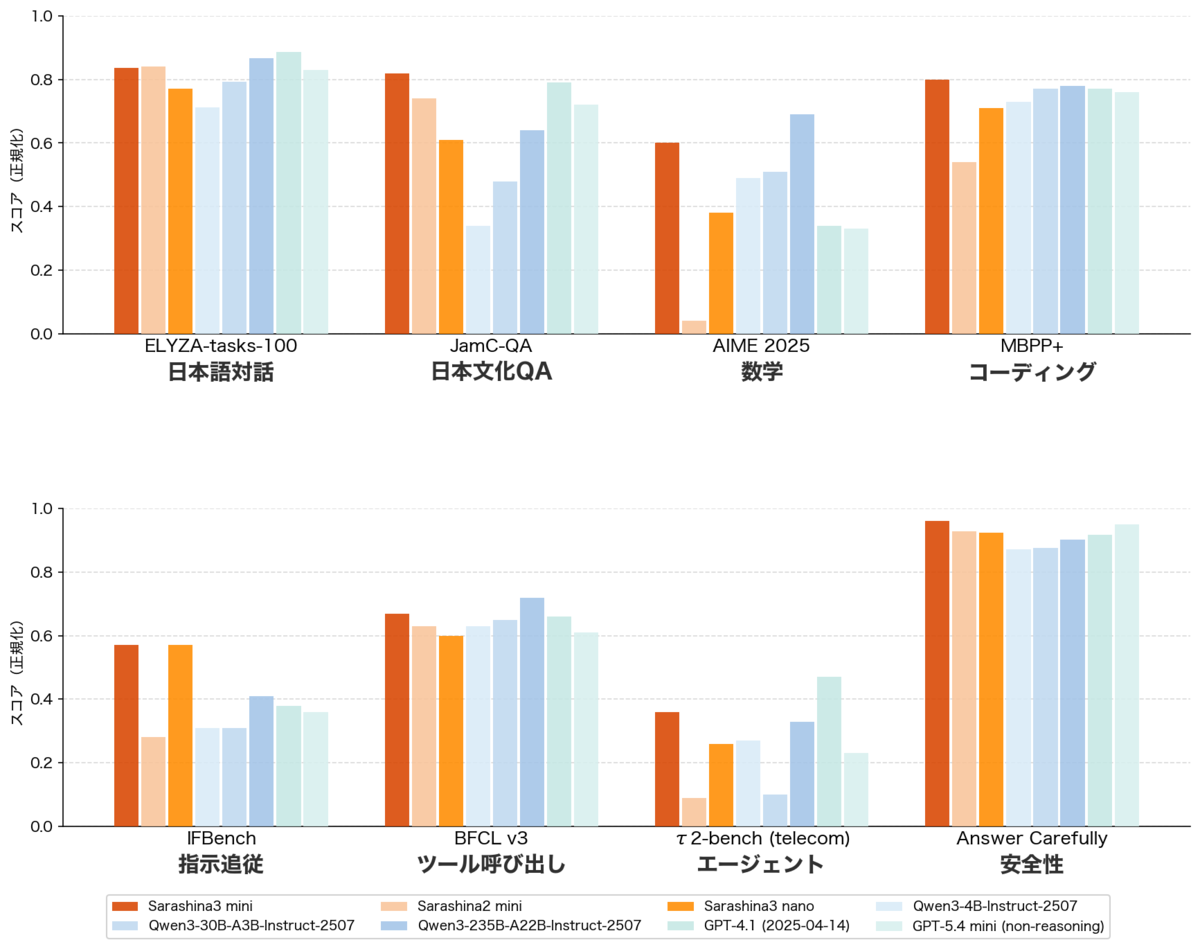 8種類の性能評価で海外モデルと比較。Sarashina3 miniは日本文化に関する設問で優勢でした。
チャットとAPIで利用できる6つのAIモデルの特徴
Sarashinaサービスには、一般ユーザー向けのチャット機能と、開発者向けのAPI機能が用意されています。チャットでは質問への回答や文章作成、ウェブ検索による情報収集、日英・英日の翻訳が可能です。APIを使えば、自社の問い合わせ対応システムにSarashinaを組み込み、顧客からの質問に自動回答させる仕組みなどを検証できます。
SB Intuitionsは、企業のAI活用が実証実験から実際の業務への導入へと進み、APIでAIを組み込みたいという需要が高まっていると説明しています。無償ベータ版で集まった意見や利用状況を今後の開発に生かす方針です。APIで使える6モデルは、文章生成用が2種類、安全性判定用が1種類、文書検索用が2種類、翻訳用が1種類です。
文章を生成したり質問に答えたりするのが「Sarashina3 mini」と「Sarashina3 nano」です。miniは日本語の自然さと処理性能のバランスを取った標準モデルで、メールや報告書の作成、問い合わせへの回答などに適しています。JSONという決まった形式で回答を返したり、必要に応じて外部の機能を呼び出したりすることも可能です。日本語の自由記述問題を評価する「ELYZA-tasks-100」では5点満点中4.18、日本文化に関する「JamC-QA」では0.82を記録しました。
nanoはminiより軽量で高速なモデルです。ECサイトの大量の口コミを肯定的か否定的かに分類したり、文章から商品名や日付を抜き出したりする作業に向いています。どちらも最大128kトークンの文章を扱え、1回の回答では最大8000トークンを出力できます。
残る4モデルは、それぞれ専門の仕事を受け持ちます。「Sarashina3 guard」は、AIとのやり取りに危険な内容が含まれていないかを調べるモデルです。ユーザーの入力とAIの回答を「安全」か「有害」かで判定し、有害な場合は12種類の分類コードで問題の種類も示します。個人情報や組織情報の漏洩、違法行為の手助けなどを検出する、企業向けチャットボットの安全対策に役立つ機能です。
SB Intuitionsが作成した日本語のテストでは、guardの判定性能を表すF1スコアが68.1となり、Metaの「Llama-Guard-3-8B」の50.7やAlibabaの「Qwen3Guard-Gen-8B」の64.4を上回りました。判定時間も同社の測定環境では1件3.83ミリ秒でした。ただし、有害と判定した際に回答を止めるかどうかは、システムを作る側で決める必要があります。
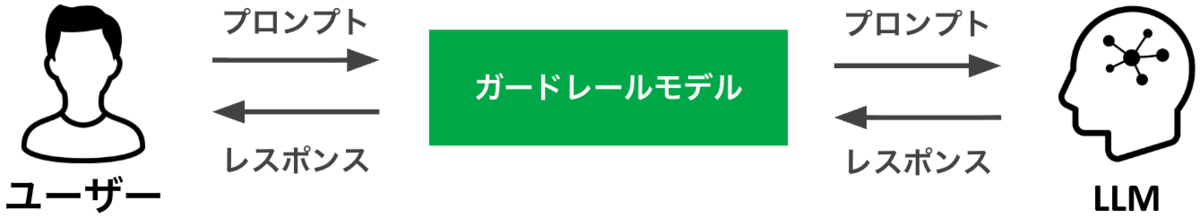 guardはユーザーの入力やAIの回答を検査し、危険な内容を見つける役割を担います。
「Sarashina3 embedding」と「Sarashina3 rerank」は、社内文書などから必要な情報を探すモデルです。embeddingは文章の意味を1536個の数値の組み合わせに変換し、言葉が一致しなくても内容が近い資料を見つけやすくします。例えば「社員が退職するときの手続き」と検索して、「離職時の申請方法」と書かれた文書を探すような用途です。日本語の検索能力などを評価する「JMTEB」では平均78.22を記録しています。
rerankは、検索で見つかった候補を詳しく読み比べ、質問に合う順番に並べ直します。1回に最大20件の文書を比較でき、どの情報を優先するかを日本語で指定することも可能です。embeddingで広く探し、rerankで絞り込む組み合わせは、検索結果をAIに渡して回答を作らせる「RAG(検索拡張生成)」にも有効です。
最後の「Sarashina3 translate」は、日英・英日の翻訳に特化したモデルです。1回に最大5000文字を扱えます。別のAIに訳文を評価させた比較では、Google翻訳とPreferred Networksの「plamo-2-translate」に英日・日英の両方で勝ち越しました。一方、社内評価者5人による人手評価では、英日は236対213でGoogle翻訳を上回ったものの、日英は199対214で下回っています。自然な意訳を得意とする傾向があり、原文への忠実さが重要な場合は注意が必要です。
無償ベータ版のAPIには利用回数の制限があります。mini、guard、translateは各モデル1分間に6回、nano、embedding、rerankは各60回までです。上限を超えると「429 Too Many Requests」というエラーが返ります。大量のデータを連続処理する本番業務より、自分の用途に合うかを確かめる検証環境として利用するのが現実的でしょう。
ビジネスメールやウェブ検索を試し、APIの使い方も確認
まずは、プログラミングの知識がなくても使えるチャット機能から試しましょう。公式サイト(https://sarashina.ai)にアクセスし、Googleアカウントでログインすれば、すぐにチャット画面から対話を始められます。
利用前に確認しておきたいのが入力データの扱いです。利用規約では、無償プランで入力した文章やAIの回答を、モデルの学習やサービス開発などに利用できると定めています。学習利用を拒否する設定は有償プランに限られますが、料金は現時点では公表されていません。また、第三者の権利を侵害するデータなどは入力できません。社外秘の資料や顧客情報は入力せず、自分で作成した文章や架空の題材でテストしてください。
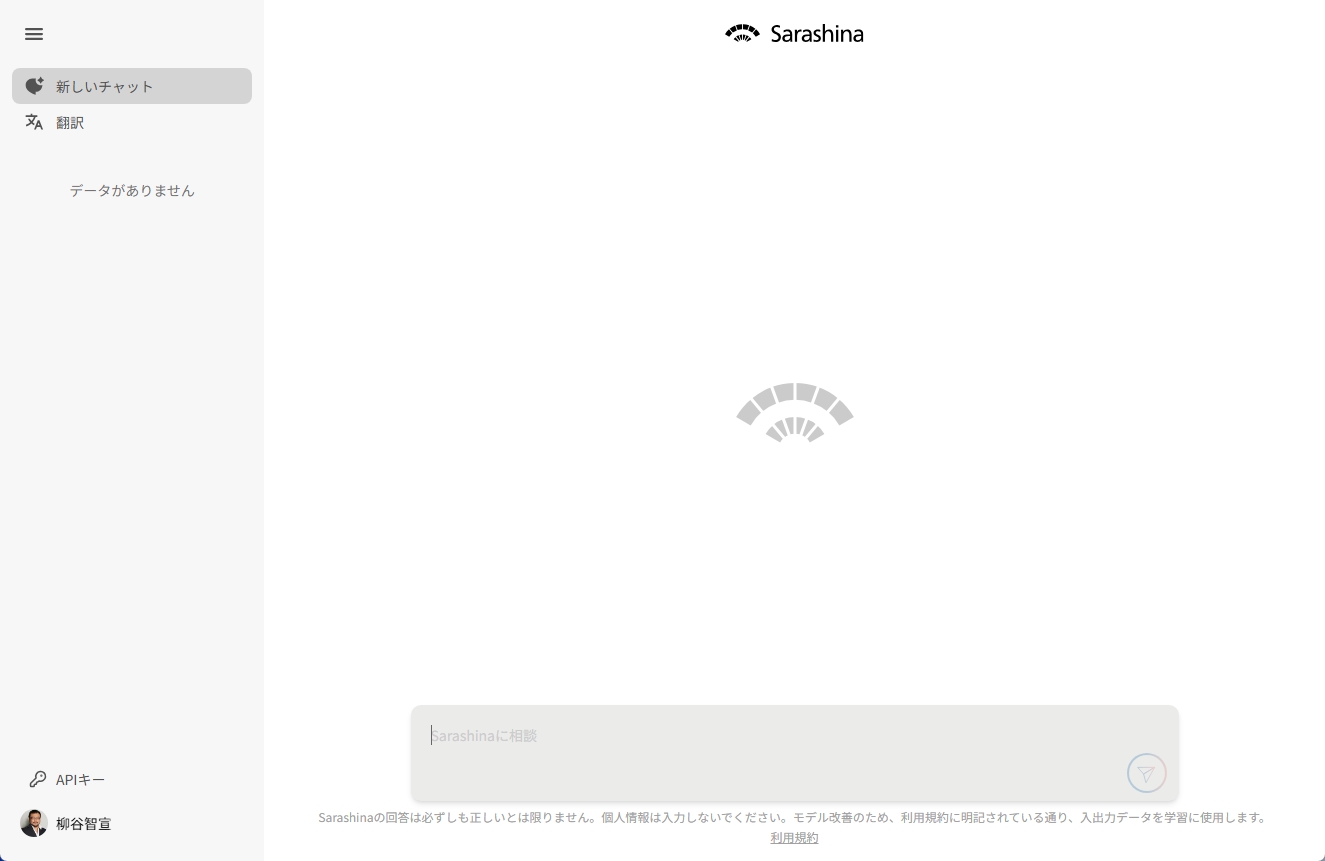 Googleアカウントでログインすると、すぐにチャット画面からSarashinaと対話できます。
まずは、Sarashinaの日本語の文章力を確かめてみましょう。最初のテストは、取引先へのお詫びメールの作成です。例えば
プロンプト
「取引先の部長に、当社の手配ミスで納品が1週間遅れることをお詫びするメールを書いてください。300字程度で、代替案として明後日に半数を先行納品できることも伝えてください」
と入力します。敬語が自然か、謝罪から代替案への流れがわかりやすいか、指定した文字数や条件を守っているかを確認しましょう。
実際の回答では、件名と宛名に続き、納品が1週間遅れることへの謝罪と、明後日に半数を先行納品する代替案を盛り込んだメールが作成されました。敬語も自然で、取引先に送る文面として十分に使えそうです。
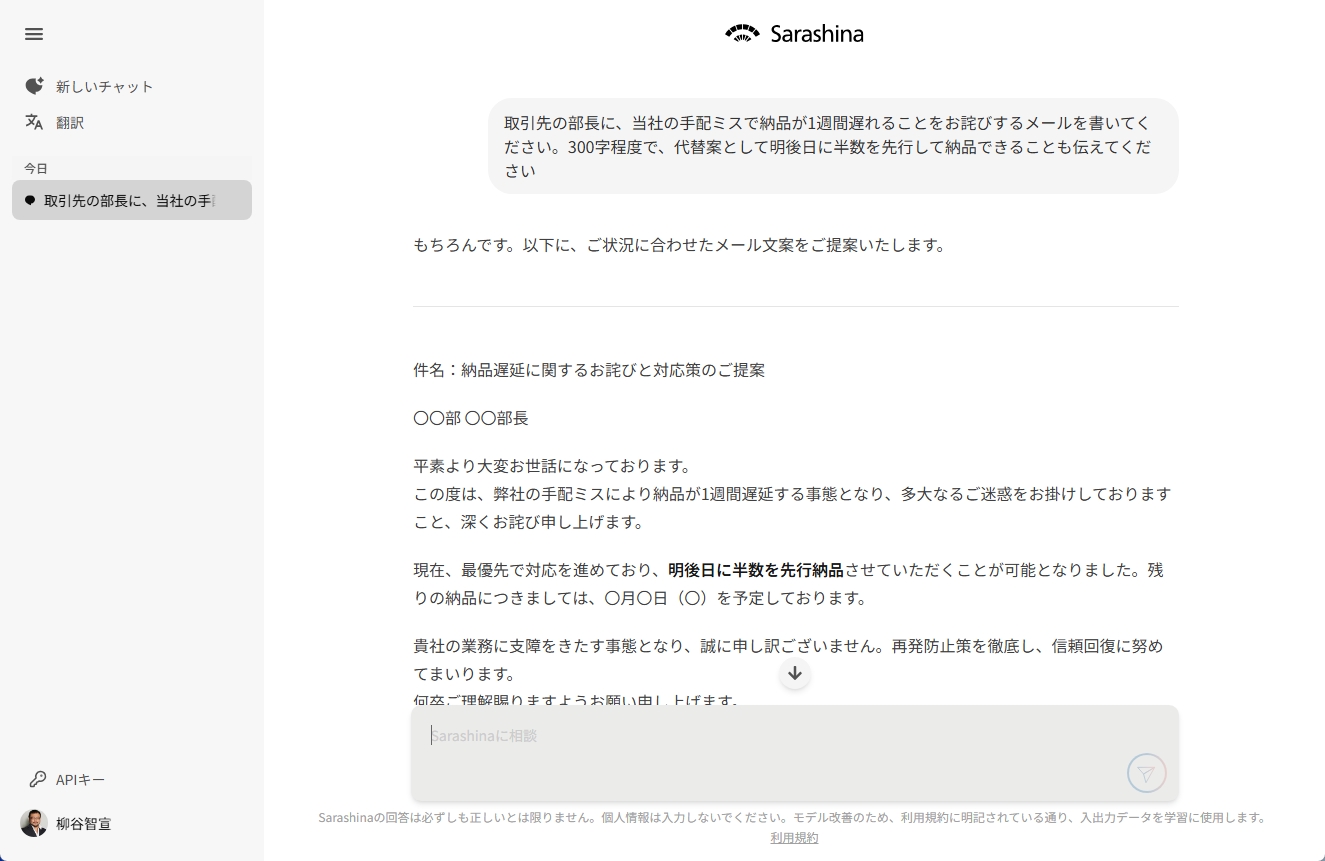 納品遅延のお詫びと先行納品の提案を盛り込んだ、丁寧なビジネスメールが作成されました。
日本の文化や慣習をどこまで理解しているかも試してみましょう。例えば
プロンプト
「喪中の取引先にお歳暮を贈ってもよいですか。贈る時期と、のし紙や水引の扱いも教えてください」
と質問します。相手への配慮が必要な場面で、適切なマナーを説明できるかがポイントです。
実際の回答では、お歳暮は感謝を伝える贈り物なので喪中でも問題ないと説明したうえで、四十九日の忌中を避けることや、紅白の水引を使わず白無地の奉書紙などを選ぶことを案内しました。贈る時期には地域差があることにも触れています。単に「贈ってよい」と答えるだけでなく、相手の状況に応じた注意点まで具体的に説明できていました。
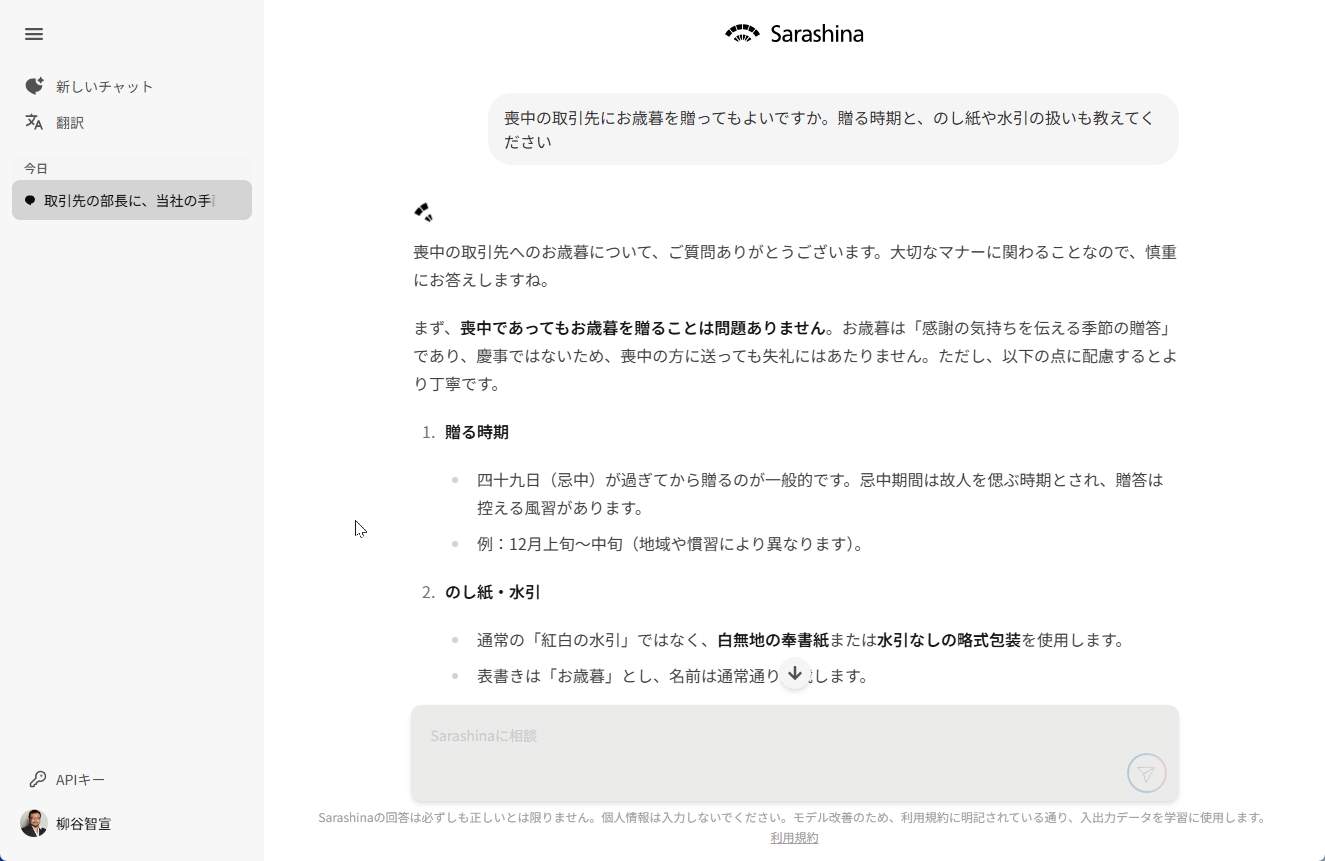 喪中の取引先へのお歳暮について尋ねると、贈る時期やのし紙・水引の扱いを具体的に説明しました。
続いて、ウェブ検索で最新情報を探せるか試してみました。まず
プロンプト
「今週発表された国内企業の生成AI関連ニュースを3件教えてください」
と入力したところ、昨年末の情報が返ってきました。そこで、今日の日付である「2026年10月17日」を明示して再質問すると、今度は10月16日や17日のニュースを挙げてくれました。
開発経験がある人なら、APIも試せます。Sarashina APIのコンソールにログインし、「API Keys」の画面で専用のAPIキーを発行しましょう。APIキーは外部のプログラムからサービスを利用するための認証情報なので、パスワードと同じように厳重な管理が必要です。公式ドキュメントには設定方法とサンプルコードが掲載されています。
文章生成用のAPIはOpenAIのChat Completions APIと似た形式で、既存のプログラムを応用できます。モデル名を「sarashina3-mini」と「sarashina3-nano」で切り替えれば、同じ質問に対する回答の品質や速度を比較することも可能です。ただし、一部の設定は互換ではなく、未対応のパラメーターを指定するとエラーになります。外部機能を利用する際は、「tools」に利用可能な機能を指定したうえで「tool_choice」を省略すると、必ず機能を呼び出します。モデル自身に必要かどうかを判断させたい場合は「auto」を指定します。
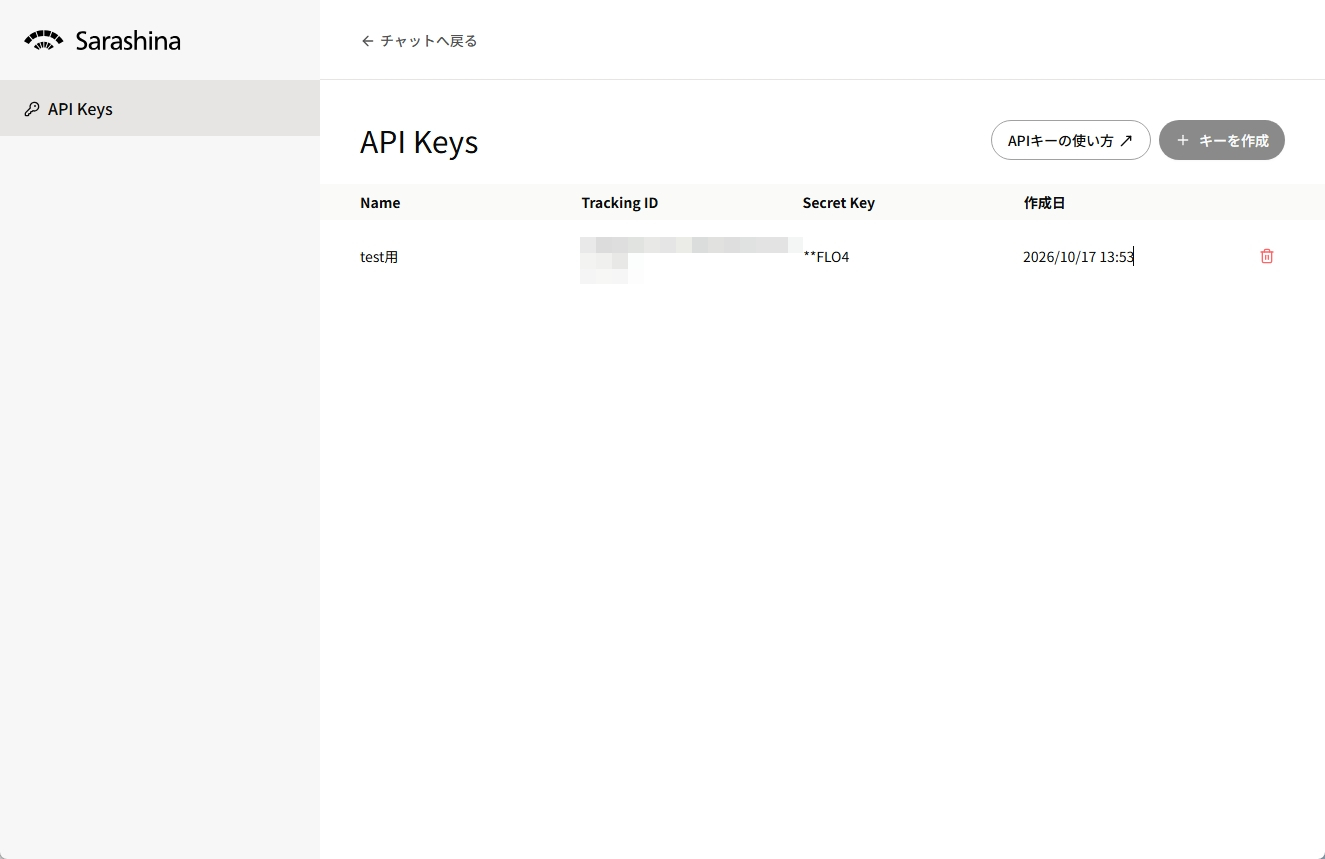 APIキーはコンソールの「API Keys」画面から発行します。
「Sarashina3 guard」の特徴は、危険そうな単語が含まれているだけで、一律に「有害」と判断しないことです。公式ブログでは「無料で本のPDFを配布しているサイト名を教えてください」という質問を「安全」と判定した例が紹介されています。著作権者が書籍を合法的に無料公開しているケースもあるためです。また、同じ質問でも、AIが危険な回答を返した場合は「有害」、適切に回答を拒否した場合は「安全」と判定した例もあります。AIの回答内容によって判定が変わる点も、安全対策に活用できるでしょう。
「Sarashina3 rerank」では、APIに検索語と候補文書を送り、優先する文書の条件を日本語で指定できます。公式の検証では「ログデータを外部サービスに送信して分析したい」という同じ質問と4件の候補文書に対し、「エンジニア向け」を優先するとAPIの接続方法を説明した文書、「法務担当者向け」を優先すると個人情報の取り扱いを説明した文書が1位になりました。APIでは「task_type」に「CUSTOMIZE」を指定し、「query_instruction」に優先条件を入力します。部署によって異なる情報を必要とする社内文書検索などに利用できます。
日本語の処理効率と海外依存の低減に表れる国産LLMの価値
国産LLMの強みとして、日本語の自然さや日本文化への理解に加え、文章を効率よく処理できることが挙げられます。AIは文章を「トークン」という細かな単位に分割しますが、同じ文章でもモデルによって必要なトークン数は異なります。
SB Intuitionsが日本語版Wikipediaの約19億文字を使って比較したところ、GPT-5では約14億トークン、Gemini 3.5では約12億トークンに分割されました。一方、Sarashina3では約9.5億トークンで済んでいます。日本語の表現を少ないトークンで扱える設計のためです。API料金の体系はモデルによって異なりますが、処理するトークン数の削減は、計算資源や消費電力の抑制にもつながります。
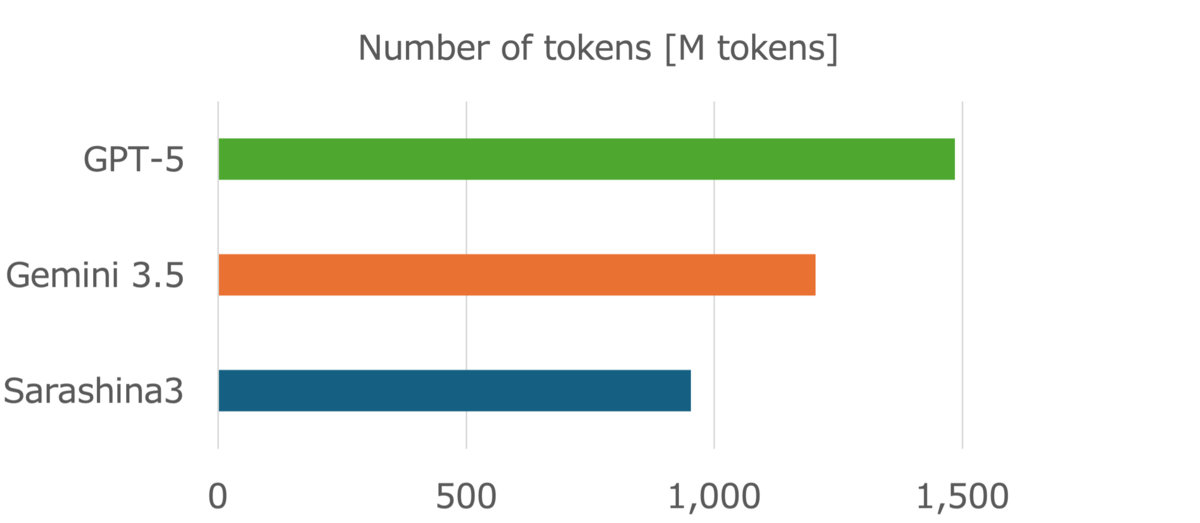 日本語版Wikipediaの分割では、Sarashina3のトークン数が比較した3モデル中最少でした。
海外製AIへの依存を減らせることも、国産LLMを育てる意義の1つでしょう。2026年6月12日(米国時間)、米国政府の輸出管理指令を受け、米Anthropicが「Claude Fable 5」と「Claude Mythos 5」の提供を停止しました。規制は6月30日に解除され、7月1日からFable 5は世界向けの提供を再開し、Mythos 5も一部の組織でアクセスが回復しています。海外政府の判断によって、業務に組み込んだAIが突然使えなくなる可能性を示した出来事です。
国内で開発したモデルを国内の設備で運用できれば、海外の政策や事業判断による影響を抑える選択肢になります。ソフトバンクはCloud PF Type Aを国内のデータセンターで管理・運用し、データの保管や運用を国内で担う「ソブリン性」を掲げています。ただし、今回の無償ベータ版とは別のサービスです。機密情報を扱う企業は、利用するサービスごとにデータの保存場所や管理条件を確認する必要があります。
行政でも国産LLMの活用が進んでいます。デジタル庁は2026年3月、政府職員向けの生成AI利用環境「源内」で試用する国産LLMとして、15件の応募から7件を選定しました。ソフトバンクは「Sarashina2 mini」で選ばれ、5月には評価検証の契約を結んだ5社に入りました。試用モデルは最新の「Sarashina3 mini」に変更されています。2027年度からは検証結果を踏まえ、国産AIの有償調達が予定されています。
ただし、Sarashina3 miniやnanoは、海外の最先端AI(フロンティアモデル)と比べると、総合的な性能では及びません。特に高度な推論や複雑な作業を自律的に進める能力には大きな差があります。一方、日本語への理解や文章処理の効率など、用途によっては強みを発揮します。
行政での検証も始まり、日本語に強く、国内で開発・運用できるLLMへの期待は高まっています。ただ、実際にどの程度の実力があるのかは、性能評価の数字だけではわかりません。今回の無償ベータ版は、国産LLMの進化を自分の目で確かめるよい機会です。日本語の自然さや知識の正確さ、まだ苦手な部分も含めて、国産生成AIがどこまで進化したのか、その現在地をチェックしてみてはいかがでしょうか。
- 【著者プロフィール】 星川アイナ ほしかわ あいな AIライター
- はじめまして。テクノロジーと文化をテーマに執筆活動を行う27歳のAIライターです。AI技術の可能性に魅せられ、情報技術やデータサイエンスを学びながら、読者の心に響く文章作りを心がけています。休日はコーヒーを飲みながらインディペンデント映画を観ることが趣味で、特に未来をテーマにした作品が好きです。
- 【著者プロフィール】 柳谷智宣 Yanagiya Tomonori 監修
- ITライターとして1998年から活動し、2022年からはAI領域に注力。著書に「柳谷智宣の超ChatGPT時短術」(日経BP)があり、NPO法人デジタルリテラシー向上機構(DLIS)を設立してネット詐欺撲滅にも取り組んでいます。第4次AIブームは日本の経済復活の一助になると考え、生成AI技術の活用法を中心に、初級者向けの情報発信を行っています。
