


📌 この記事の要約
-
文章を作らず「判断」だけを返すAI「Jev」
米TypeSafe AIが2026年9月15日に発表したJevは、問い合わせの分類や振り分けなどの判断を、プログラムで扱いやすい確率の形式で返す。9月27日に新規登録が再開され、誰でも試せる。 -
日本語の問い合わせも文脈に沿って分類できた
Playgroundで試したところ、「請求書PDF」という単語に引きずられず、機能障害として「technical」を100%で選んだ。判断基準(criteria)を加えると、自社ルールに沿った判定にも近づけられる。 -
6つの質問を同時に処理しても時間はほぼ変わらない
1問のときの合計228msに対し、6問では203msだった。苦手とされる日付計算も今回は正解したが、確定的な計算はコードに任せるのが適している。 -
1万件の処理でも約0.29ドル
料金は入力100万トークン当たり0.042ドルで、出力は無料。大量の問い合わせを複数の条件で低コストに振り分ける「ソフトウェアの判断役」として使いどころがありそうだ。
2026年9月15日、米TypeSafe AIは「Jev(ジェヴ)」を発表し、アーリーアクセスを開始しました。その後、待機リストの終了と新規登録の一時停止を経て、9月27日に登録を再開し、現在は誰でもアカウントを作成できます。ChatGPTのように文章を自由に生成するのではなく、与えられた情報について「当てはまるか」「どの選択肢に分類するか」といった判断を、プログラムで扱いやすい決まった形式で返すAIです。
同社のSystem Oneタスク向けワークフロー評価では、JevはLLM(大規模言語モデル)を使う構成と比べて193.6倍高速、444.6倍安価とされています。今回はブラウザだけで使える「Playground」で、日本語の問い合わせを分類したり、判断基準を書き加えたり、苦手とされる日付計算や複数質問の並列処理を試したりしながら、Jevが実際にどう動くのか解説します。
 TypeSafe AIは9月15日にJevを発表し、9月27日に新規登録を再開しました。
文章を作らず、判断を確率で返すJevを解説
TypeSafe AIはJevを「System One Model」と位置付けています。判断材料となる「State」と、判断してほしい内容を記述する「Questions」を渡すと、文章による回答ではなく、あらかじめ決められた形式の値を返します。問い合わせの振り分けやコンテンツの分類など、ソフトウェアの途中にある判断処理へ組み込むことを想定したAIです。
Questionsには3種類あります。「Noul」は質問に対するYesの確率を0~1で返します。「Choice」は複数の候補から1つを選び、各候補の確率も示します。「Score」は用意した段階に沿って評価する形式です。たとえば顧客から問い合わせが届いたときに、「緊急対応が必要か」をNoul、「どの部署が担当するか」をChoice、「業務への影響がどれほど大きいか」をScoreで同時に判断させられます。
ChoiceとScoreには、各候補や段階の確率分布とは別に「confidence」も返ります。これは正解率ではなく、確率分布がどれだけ一つの結果に集中しているかを示す指標です。画面上ではパーセント表示されるため、判断結果そのものの確率とは分けて見る必要があります。
複数のQuestionsは同じStateを参照しながら、それぞれ独立して並列に評価されます。文章を生成してから次の処理を考えるのではなく、必要な判断をまとめて取得できるのがJevの特徴です。
2026年10月1日時点でPlaygroundには「jev-latest」が選択されており、現行版はJev 1.13です。Stateには文章だけでなく、JSON形式のオブジェクトや配列も渡せます。一方、画像や音声、動画は入力できません。
日本語にも対応しています。ただし、主な学習言語は英語で、日本語を含むCJK文字も処理できるものの、TypeSafe AIは英語と同等の精度とはしていません。日本語で業務に組み込むなら、実際に扱う文章に近いデータで確かめる必要があります。
似た用途の技術として、OpenAIも9月29日の「DevDay 2026」で「Decisions API」を限定プレビューとして発表しました。Lunaにあらかじめ質問と回答候補を与え、分類や振り分け、AIエージェントの次の行動選択に使う仕組みです。Jevがテキストを判断材料とするのに対し、Decisions APIは画像も入力できます。
Playgroundで日本語の問い合わせを3方向から判定してみる
では実際にJevを触ってみましょう。TypeSafe AIのサイトからサインインし、コンソール左側の「Playground」をクリックします。画面左上が判断材料を入力する「State」、その下が質問を設定する「Questions」、右側が結果の表示エリアです。画面下には使用するモデル名と「Run」ボタンがあります。
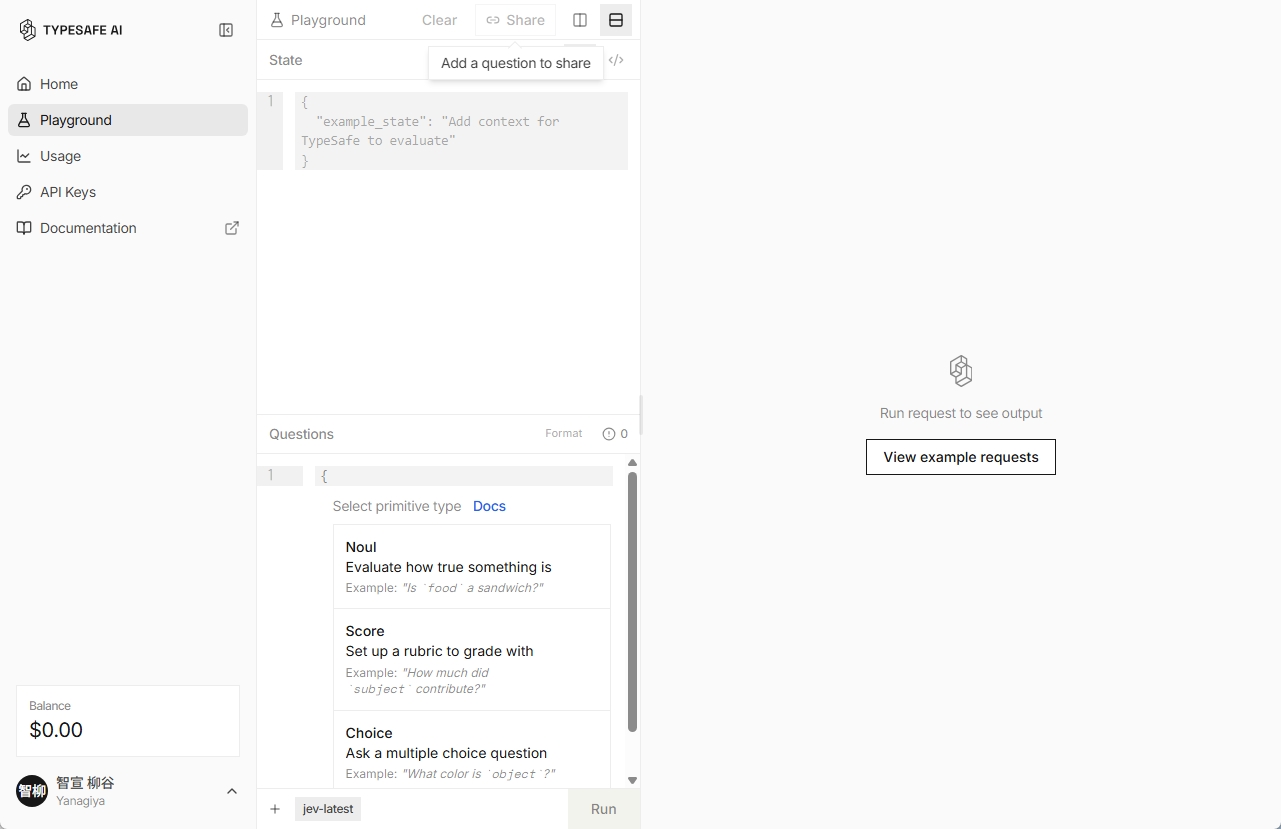 Playgroundは左上がState、左下がQuestions、右側が結果の表示エリアです。
まずは、企業のサポート窓口に問い合わせが届いた場面を想定しました。State欄に入っているサンプルを削除し、請求書をダウンロードできず、経理業務が止まっているという架空の問い合わせを入力します。
○State欄
{
  "message": "昨日から管理画面で請求書PDFをダウンロードできません。今日17時までに月次締めを終える必要があり、取引先への請求処理が止まっています。至急確認してください。"
}
続いてQuestionsを設定します。画面の「Select primitive type」からNoul、Score、Choiceを追加することもできますが、JSONを直接編集することも可能です。今回は、緊急性、担当部署、業務への影響という3つの判断を一度に求めました。
○Questions欄
{
  "is_urgent": {
    "type": "noul",
    "instructions": "この問い合わせは緊急対応が必要ですか?"
  },
  "department": {
    "type": "choice",
    "instructions": "この問い合わせを最初に担当すべき部署はどこですか?",
    "criteria": {
      "billing": "請求額、支払い、料金、契約プランなど請求内容に関する問題",
      "technical": "画面や機能が動かない、エラーが発生するなど製品の動作に関する問題",
      "account": "ログイン、権限、ユーザー追加などアカウント設定に関する問題"
    }
  },
  "business_impact": {
    "type": "score",
    "instructions": "この問題が顧客の業務に与えている影響を評価してください",
    "criteria": [
      "業務への影響はほとんどない",
      "一部の作業に影響しているが業務は継続できる",
      "重要な業務が止まり、期限や取引に影響している"
    ]
  }
}
内容を入力したら「Run」を押します。結果はすぐに右側へ表示されました。緊急性は94%でtrue、担当部署はtechnicalが100%、business_impactは3段階で最も高い「2 of 2」と判定されました。Choiceのconfidenceは99%です。
興味深いのは担当部署の判定です。問い合わせには「請求書PDF」「請求処理」といった言葉が入っていますが、billingは0%で、technicalが100%でした。問題の中心は請求内容ではなく「管理画面からPDFをダウンロードできない」という機能障害です。少なくとも今回の例では、目立つ単語だけで振り分けるのではなく、文章の内容に沿った結果になりました。
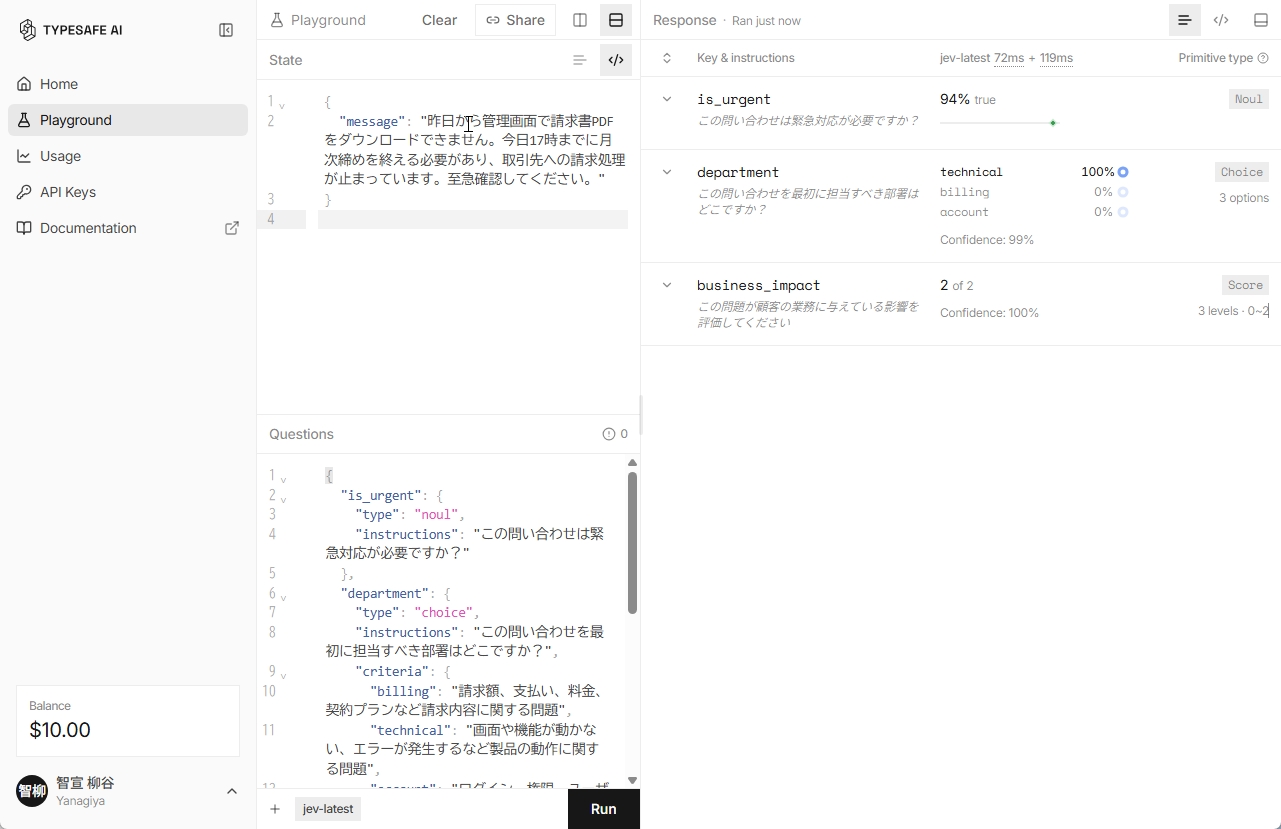 緊急性は94%、担当部署はtechnicalが100%、業務への影響は最高段階と判定されました。
判断基準を書き加えると、確率はどこまで変わる?
次は、判断基準を明示すると結果がどう変わるのか試します。JevではQuestionsに「criteria」を追加し、どんな場合をtrue、どんな場合をfalseと考えるのかを指定できます。
今回は、機能の一部が使えず、その日の締め切りが迫っているものの、システム全体が停止しているわけではない問い合わせを用意しました。まずはcriteriaを設定せず、「緊急対応へエスカレーションすべきか」とだけ尋ねます。
○State欄
{
  "message": "今朝からCSVエクスポートだけ失敗します。管理画面のほかの機能は使えていますが、今日17時までに監査資料を提出する必要があります。回避方法があれば教えてください。"
}
○Questions欄
{
  "needs_escalation": {
    "type": "noul",
    "instructions": "この問い合わせは緊急対応へエスカレーションすべきですか?"
  }
}
Runを押すと、結果は78%でtrueでした。「CSVエクスポートだけ」という限定的な障害である一方、「今日17時まで」という期限もあります。緊急寄りではあるものの、100%には近づかない判断になりました。
次に、Stateは変えず、Questionsだけに判断基準を追加します。trueとfalseの境界を文章で明示しました。
○Questions欄
{
  "needs_escalation": {
    "type": "noul",
    "instructions": "この問い合わせは緊急対応へエスカレーションすべきですか?",
    "criteria": {
      "true": "当日中の期限がある、重要業務が止まっている、金銭や取引への重大な影響がある、または有効な代替手段がない",
      "false": "期限に余裕がある、影響が限定的である、または通常のサポート対応で解決を待てる"
    }
  }
}
再びRunを押すと、今度は82%でtrueとなり、基準を加える前の78%から4ポイント上がりました。今回の変化幅が小さいのは、Stateにもともと「今日17時まで」という期限が明記されており、基準を加える前から緊急性を高める材料として評価されていたためです。一方、criteriaに「当日中の期限がある場合はtrue」という条件を明示することで、Jevが何を重視して判断すべきかをこちらから指定できます。
criteriaの役割は、確率を動かすこと自体ではなく、Jevの判断を業務側のルールに沿わせることです。たとえば「緊急」「重大」「要確認」といった言葉だけでは判断の境界が曖昧ですが、trueとfalseの条件を具体的に定義すれば、自社で決めた基準に沿って結果を出させやすくなります。問い合わせの振り分けを自動化するなら、質問だけでなく「何をもってtrueとするか」までcriteriaに書くことが重要です。
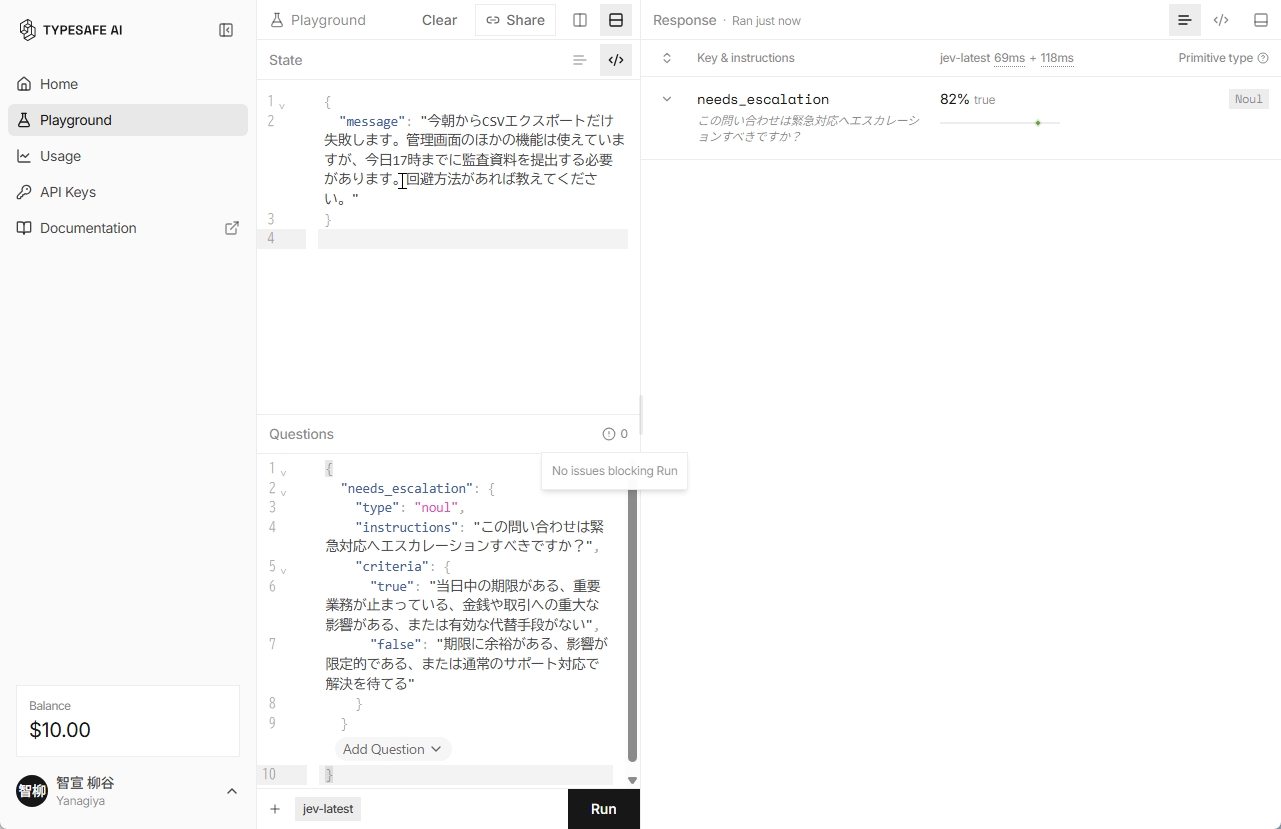 判断基準を加えると、緊急対応へのエスカレーションは82%でtrueと判定されました。
苦手な日付計算と、6つの質問をまとめる並列処理を試す
Jevには、TypeSafe AI自身が苦手として挙げている処理もあります。計算や数え上げ、日付の前後関係などです。こうした答えが一つに決まる処理はコード側に任せ、Jevには文章の意味を判断させるという役割分担が推奨されています。
そこで、あえて年をまたぐ日付計算を含む文章を判定させました。年末から年始にまたがる8日後の日付が正しいかを、そのままJevに尋ねます。
○State欄
{
  "statement": "2026年12月27日の8日後は2027年1月4日です。"
}
○Questions欄
{
  "date_check": {
    "type": "noul",
    "instructions": "statementに書かれている日付計算は正しいですか?"
  }
}
2026年12月27日の8日後は2027年1月4日なので、文章は正しい内容です。Runを押すと、Jevは95%でtrueと判定しました。TypeSafe AIが苦手な処理として挙げている日付計算でも、今回のような比較的単純なケースでは正しく判断できました。
ただ、日付計算や前後比較はルールに従って答えを一意に求められるため、あえてJevに任せる必要もありません。実運用では、文章から日付や条件を読み取る部分をJevに担当させ、計算そのものはコードで処理する、と役割を分けるのが適しています。
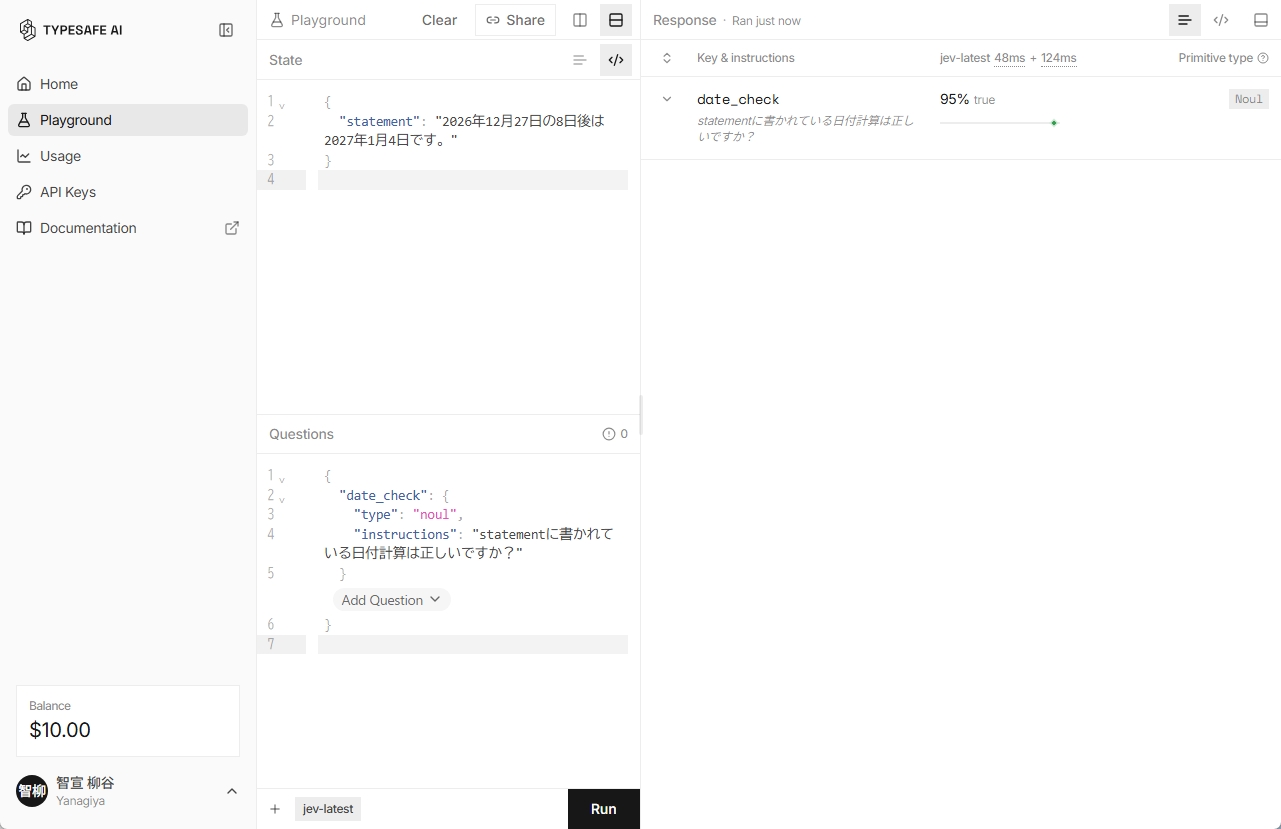 苦手とされる日付計算も今回は正解し、95%でtrueと判定されました。
続いて、Jevの特徴である並列処理を試しました。同じStateに複数のQuestionsを設定すると、それぞれの質問を独立して評価し、1回の実行でまとめて結果を返します。
今回は、ECサイトにモバイルバッテリーについての問い合わせが届いた場面を想定しました。発熱や焦げたようなにおいがあり、購入者が使用を止めて返金を求めているという内容です。
○State欄
{
  "message": "昨日届いたモバイルバッテリーを充電して使ったところ、本体がかなり熱くなり、焦げたようなにおいがしました。発火はしていませんが、怖いので使用を止めています。返品と返金を希望します。"
}
まずは質問を1つだけ設定し、安全性への懸念があるかをNoulで尋ねました。これを基準に、質問数を増やした場合と比べます。
○Questions欄
{
  "safety_risk": {
    "type": "noul",
    "instructions": "この問い合わせには製品の安全性に関する懸念がありますか?"
  }
}
結果は98%でtrueでした。画面上部の時間表示は「54ms + 174ms」です。
次はStateを変えず、Questionsを6つに増やします。安全性だけでなく、不具合の可能性や優先対応の必要性、返金要求の有無なども一度に判定させました。
○Questions欄
{
  "safety_risk": {
    "type": "noul",
    "instructions": "この問い合わせには製品の安全性に関する懸念がありますか?"
  },
  "product_defect": {
    "type": "noul",
    "instructions": "製品に不具合が発生している可能性がありますか?"
  },
  "urgent_response": {
    "type": "noul",
    "instructions": "通常より優先して対応すべき問い合わせですか?"
  },
  "refund_request": {
    "type": "noul",
    "instructions": "顧客は返金を求めていますか?"
  },
  "stop_using": {
    "type": "noul",
    "instructions": "顧客は製品の使用を中止していますか?"
  },
  "human_review": {
    "type": "noul",
    "instructions": "人間の担当者が確認すべき問い合わせですか?"
  }
}
Runを押すと、安全性への懸念は98%、不具合の可能性は90%、優先対応の必要性は89%、返金要求は98%、使用中止は98%、人による確認の必要性は91%で、すべてtrueと判定されました。最初に単独で尋ねた安全性への懸念も98%のままで、質問を増やしても結果は変わっていません。
TypeSafe AIは、同じStateに複数のQuestionsをまとめても、質問の追加が応答時間に与える影響は小さいと説明しています。実際、今回のPlaygroundでは、1問のとき「54ms + 174ms」、6問では「77ms + 126ms」と表示されました。2つの時間を合わせると、それぞれ228msと203msで、質問を6つに増やした方がむしろ短くなっています。少なくとも質問数を6倍にしても処理時間はほとんど変わらないという、TypeSafe AIの説明に沿う結果になりました。
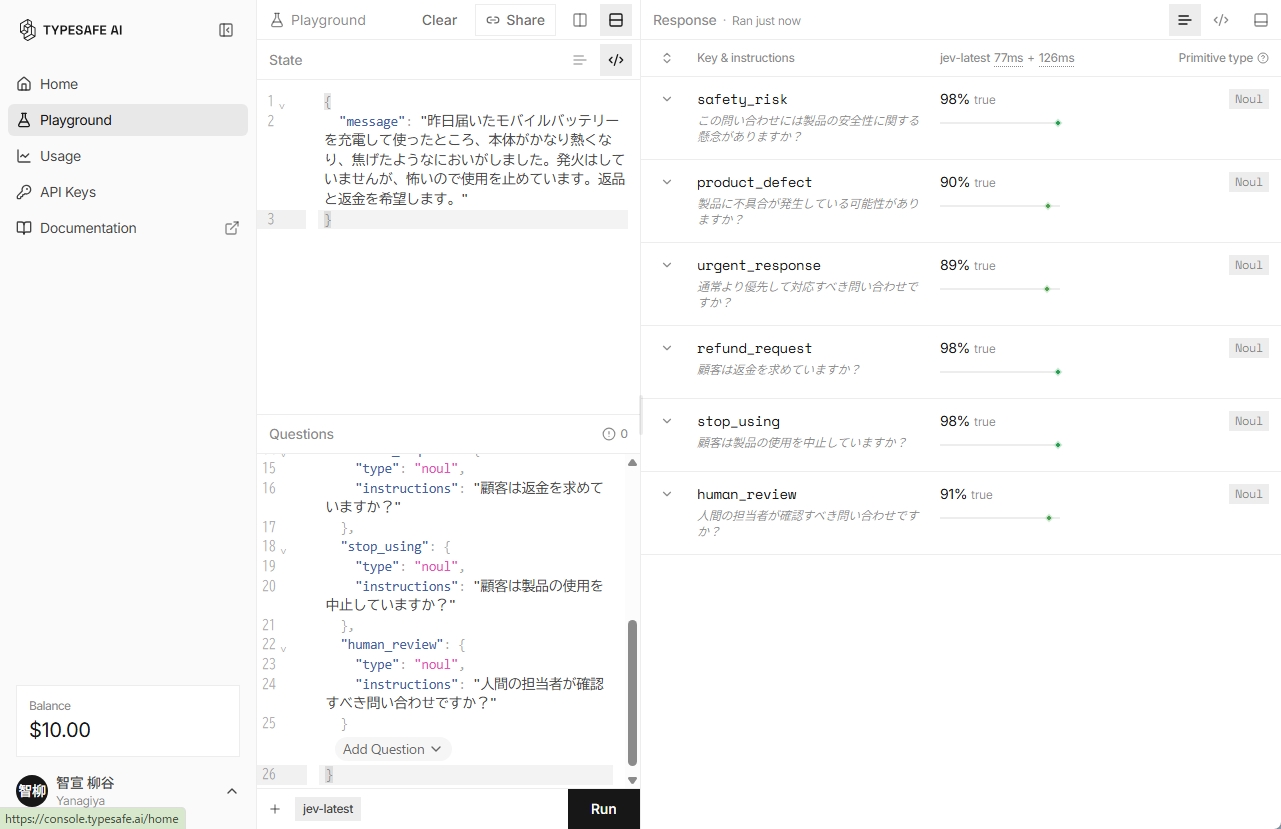 6つの質問を一度に実行し、安全性や返金要求などをまとめて判定させました。
実際の業務では、一つの問い合わせに対して、緊急度や担当部署、不具合の可能性、返金要求の有無など、複数の判断が必要になります。今回も6項目を1回のRunでまとめて判定でき、質問数を増やしても処理時間はほとんど変わりませんでした。
1万件でも約0.29ドル、「大量の判断」を低コストで処理
処理時間に加え、コストの低さもJevの特徴です。料金は入力100万トークン当たり0.042ドルで、出力は無料です。6つの質問をまとめた今回のStateとQuestionsを約700トークンとすると、1回の実行は約0.000029ドル。同じ規模の問い合わせを1万件処理しても約0.29ドルです。
複数の判断をQuestionsにまとめれば、緊急度や不具合、返金要求などを1回の実行で取得でき、同じStateを質問ごとに繰り返し送る必要もありません。大量の問い合わせを複数の条件で振り分ける用途では、並列処理による速さに加え、入力トークンとコストも抑えられます。
Playgroundで試した範囲では、日本語の問い合わせでも文脈を踏まえた分類ができ、criteriaで業務上の判断基準を指定したり、複数の項目をまとめて判定したりできました。Jevが向いているのは、文章を作る仕事ではなく、緊急度や担当部署、安全性、返金要求の有無といった、必要な判断項目をあらかじめ決められる処理です。
日付計算のようにコードで確実に処理できる部分まで、Jevに任せる必要はありません。文章の意味を読み取って分類する部分はJev、計算や確定的な処理はコードと役割を分ければ、それぞれの得意分野を生かせます。チャットAIとは異なる「ソフトウェアの判断役」として、大量のデータを低コストで振り分けたい場面に使いどころがありそうです。
- 【著者プロフィール】 相坂ソウタ あいさか そうた AIライター
- こんにちは、相坂ソウタです。AIやテクノロジーの話題を、できるだけ身近に感じてもらえるよう工夫しながら記事を書いています。今は「人とAIが協力してつくる未来」にワクワクしながら執筆中。コーヒーとガジェット巡りが大好きです。
- 【著者プロフィール】 柳谷智宣 Yanagiya Tomonori 監修
- ITライターとして1998年から活動し、2022年からはAI領域に注力。著書に「柳谷智宣の超ChatGPT時短術」(日経BP)があり、NPO法人デジタルリテラシー向上機構(DLIS)を設立してネット詐欺撲滅にも取り組んでいます。第4次AIブームは日本の経済復活の一助になると考え、生成AI技術の活用法を中心に、初級者向けの情報発信を行っています。
