


📌 この記事の要約
-
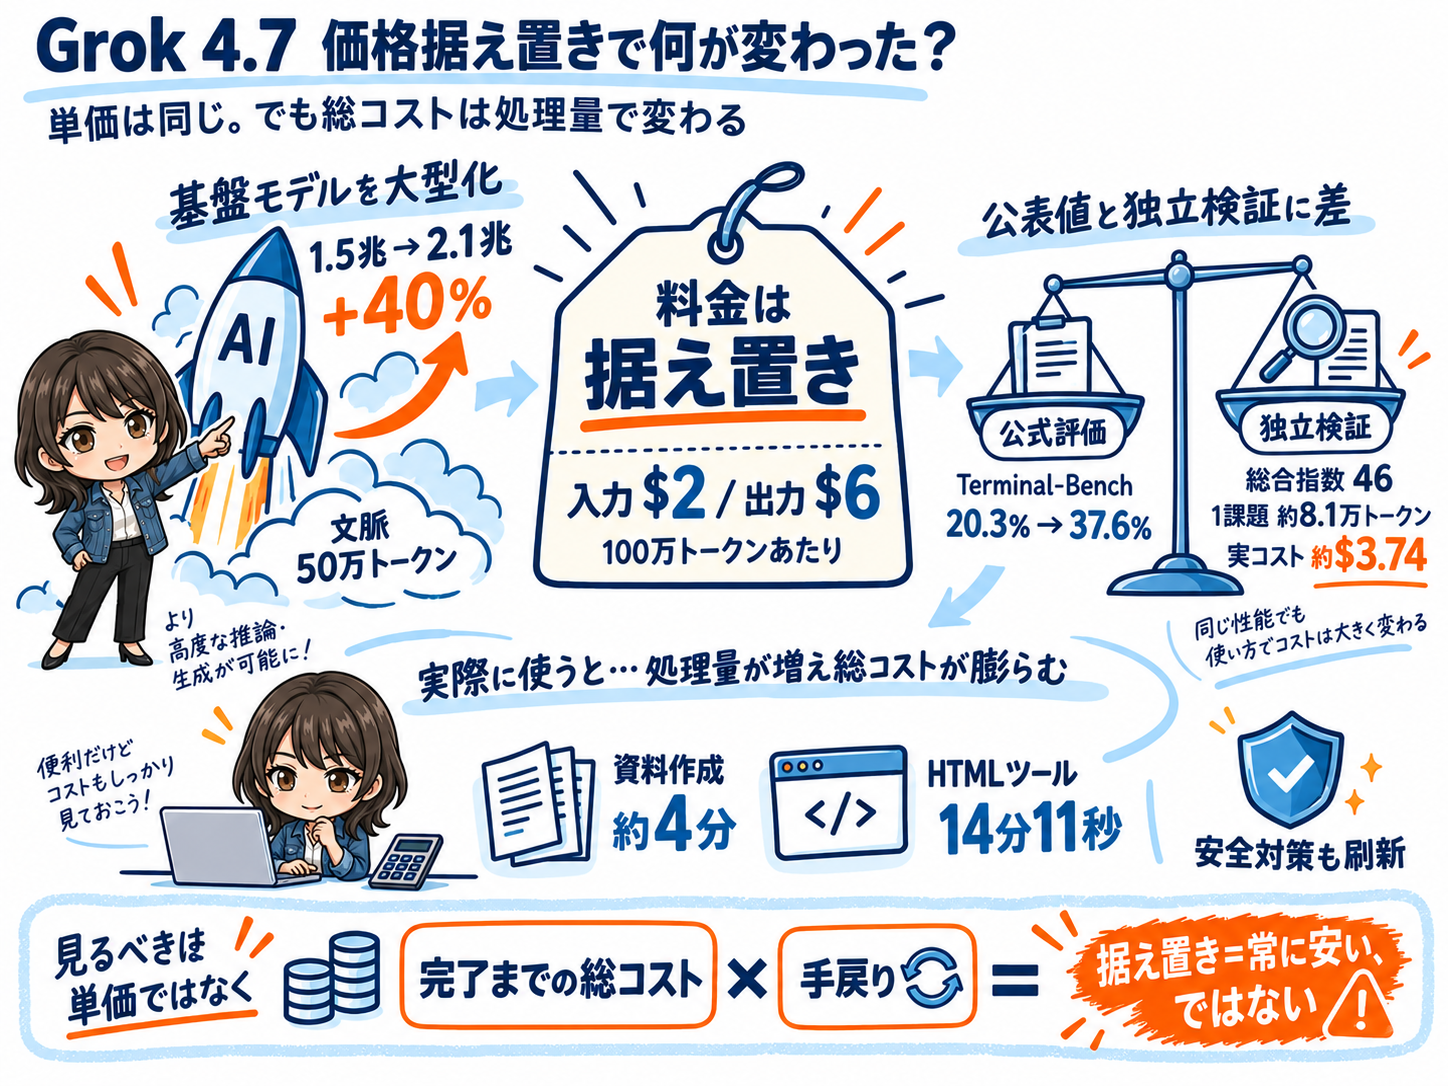
料金は据え置き、基盤モデルは40%大型化
SpaceXAIの新モデル「Grok 4.7」は、パラメータを1.5兆から2.1兆へ増やしつつ、100万トークンあたり入力2ドル・出力6ドルの料金をGrok 4.6から据え置いた。 -
公式値と独立検証で開く差
Terminal-Bench 4.0はSpaceXAI公表で38.0%だが、共通環境で測るArtificial Analysisでは26%。総合指数46はGPT-6 AstraやClaude Fable 5.1の53に届かない。 -
単価は同じでも総コストは膨らむ
xhigh設定では課題1件あたり約8万1000トークンを出力し、Grok 4.6の2倍以上。1件あたり約3.74ドルと、単価の高い競合を上回るケースも出た。 -
Grok Buildの実機テストは好印象
スライド案作成では原文の紛らわしい記述を拾って照合まで報告し、原稿チェッカー開発では指示にない便利機能まで自分で追加した。
2026年9月21日、イーロン・マスク氏率いるSpaceX傘下のSpaceXAI(旧xAI)が、新しい大規模言語モデル「Grok 4.7」を公開しました。料金は前バージョンの「Grok 4.6」から据え置かれています。マスク氏は8月の段階で「現行のあらゆるモデルを上回る」と予告していましたが、公開の1週間前には「AnthropicのClaude Opus 5とほぼ同等」と控えめな表現に改めました。では、実力はどれほどなのでしょうか。公式のベンチマークや独立機関による検証、海外の反応を確認したうえで、コーディングエージェント「Grok Build」で実際に使ってみた感触も紹介します。
 2026年9月21日に公開された「Grok 4.7」の発表ページです。
価格を据え置いたまま大型化した新モデルの中身
Grok 4.7は、Grok 4.6よりも大きな基盤モデルを採用しました。SpaceXAIはパラメータ数を公表していませんが、マスク氏はX上で、Grok 4.6の1.5兆から40%増の2.1兆に達すると明かしています。文脈を保持できる範囲を示すコンテキストウィンドウは、Grok 4.6と同じ50万トークンです。知識のカットオフ(学習データの最終時点)は2026年5月で、テキストに加えて画像も入力できます。
学習面では強化学習の期間を延ばし、完了までに数時間かかるような難しい課題の比率を高めました。その結果、自分の出力を検証する力や長い文脈を扱う力が向上したとSpaceXAIは説明しています。マスク氏は8月に、大量のSpaceX社内データを追加して補助的に学習させていると明かしており、実世界の工学分野では他のモデルを上回るとの期待も示していました。ただし、SpaceXAIの発表ページにはSpaceXデータへの言及がなく、具体的にどのデータを使ったのかも明らかにされていません。会話型のタスクに強くなるよう、同社のAIエージェント製品「Grok Bot」の実行環境にも最適化しました。推論の深さはlowからxhighまでの4段階で調整でき、標準はhighです。
料金は100万トークンあたり入力2ドル、出力6ドルで、Grok 4.6と変わりません。1回の入力が20万トークンを超えると、そのリクエスト全体の単価が倍になります。出力速度を2倍にした「Grok 4.7 Fast」は標準の2倍の料金で、現時点ではCursorとGrok Buildに限って提供され、Grok Buildの無料プランでは使えません。Grok 4.7はCursorやGrok Build、APIなどで利用できます。今回は、モデルを明示的に選びながら試せるGrok BuildのCLI版を使いました。Grok Buildは無料プランでも利用上限の範囲内で使えるほか、有料プラン「SuperGrok」の共通利用枠も利用できます。
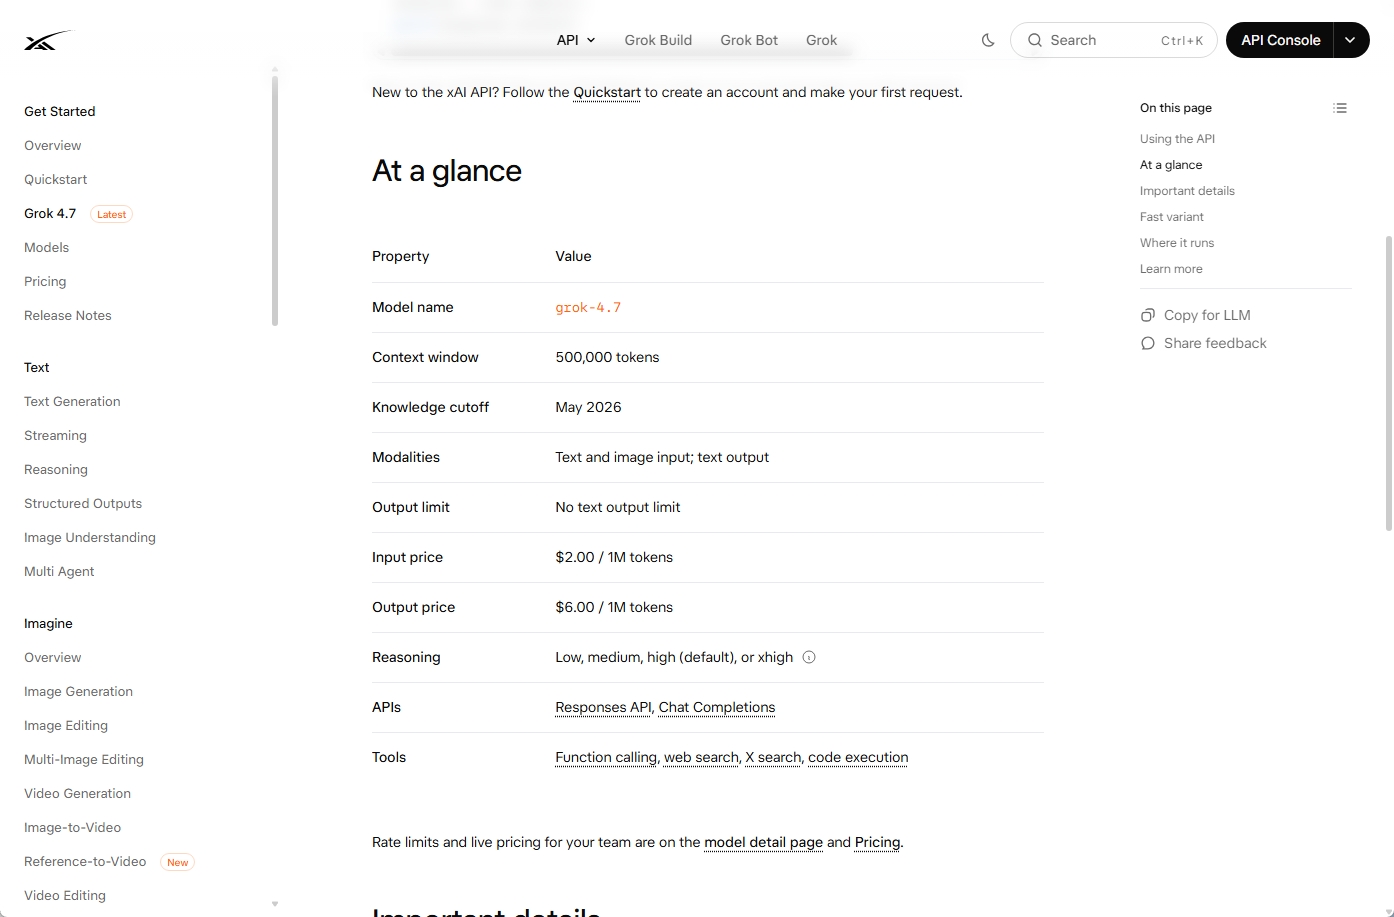 Grok 4.7の技術仕様ページです。料金や推論設定の詳細を確認できます。
公式ベンチマークと独立検証の間に開いた差
SpaceXAIの公表値を見ると、長時間のコーディング課題を測る「CursorBench 4.0」は40.4%から46.3%に、実務に近い開発力を測る「DeepSWE v1.1」は65.2%から71.0%に上がりました。ターミナル操作を評価する「Terminal-Bench 4.0」は20.3%から38.0%と、ほぼ倍増しています。電気工学の「EEBench」では64.0%、法律実務の「Harveyリーガルエージェントベンチマーク」では19.6%を記録し、いずれも比較表の中で最高値でした。もっとも、比較表の7項目中4項目で首位に立ったのはClaude Fable 5.1 Maxです。Grok 4.6との比較も、ほとんどの項目でGrok 4.7は最上位のxhigh設定、Grok 4.6はhigh設定で測られています。CursorBenchを手がけるCursorが同じ設定にそろえた結果では、伸び幅は3.5〜4.9ポイントでした。
独立系評価機関のArtificial Analysisでは、評価環境によって数字が大きく変わりました。同社が各モデルを共通の環境で測るTerminal-Bench 4.0では26%で、SpaceXAI公表の38.0%を12ポイント下回っています。一方、Grok Buildを使ったコーディングエージェントとしての評価では33%でした。10種類の評価を束ねた総合指数は46で、GPT-6 AstraやClaude Fable 5.1の53に届いていません。トークン消費量も多く、xhigh設定では課題1件あたり約8万1000トークンを出力し、同じxhigh設定のGrok 4.6の約3万8000トークンから2倍以上に増えました。課題1件あたりのコストは約3.74ドルで、APIの単価が高いGPT-5.6 Sol Maxの約1.99ドルを上回っています。一方、長時間の知的作業を評価する「AA-Briefcase」では、Claude Opus 5とClaude Fable 5.1に次ぐ位置につけました。
海外の開発者の反応も割れています。Terminal-Benchの結果を酷評する声があり、キャッシュ済み入力の単価が通常入力の4分の1と他社より割高で、長時間のエージェント処理では費用がかさむという指摘も出ました。その一方で、CursorBenchでは約6.01ドルの費用でClaude Fable 5.1 Medium(約7.05ドル)とほぼ同じ正答率を出しており、費用対効果は高いと評価する声もあります。回答が平易で読みやすい点や、法律関係の調査で要点に早くたどり着く点を好む利用者も見られました。
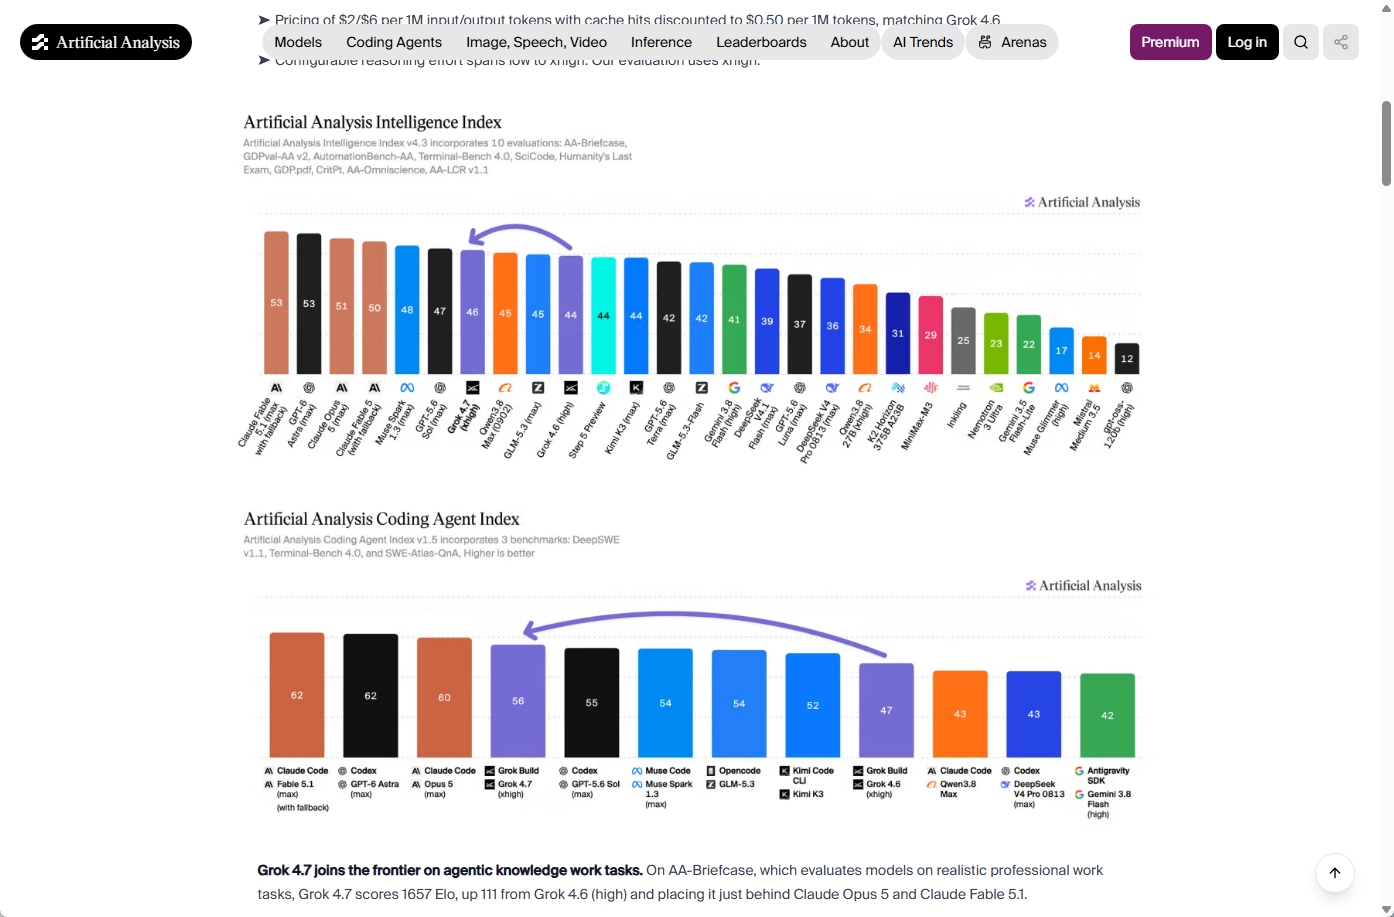 Artificial Analysisの総合指数では、Grok 4.7は46にとどまり、Claude Fable 5.1やGPT-6 Astraの53に届いていません。
Grok BuildでGrok 4.7を実際に使ってみる
公開時点ではGrokアプリの通常のチャット画面でGrok 4.7を選べないため、今回はモデルを指定できるGrok BuildのCLI版を使いました。SuperGrokの共通利用枠で利用しています。Grok Buildはもともと開発者向けのコーディングエージェントですが、日本語で質問を入力すれば普通のチャットと同じように回答が返ってくるので、プログラミングの知識がなくても使えます。
まず、Grok Buildの公式ドキュメントに掲載されているインストール用のコマンドを、Macなら「ターミナル」、Windowsなら「PowerShell」に貼り付けて実行します。コマンドはOSごとに異なるので、自分の環境に合ったほうを1行コピーしましょう。インストールが終わったら作業用のフォルダーを作って移動し、「grok」と入力すると起動します。初回はブラウザーが開くので、SuperGrokを契約しているアカウントでログインしましょう。あとは画面下部の入力欄に質問を書き込み、Enterキーを押せば回答が表示されます。使用中のモデルは「/model」と入力すると確認でき、Grok 4.6などへの切り替えもここから行えます。Webページの読み込みやファイルの作成が必要な場面では確認を求められるので、内容を見て許可すれば作業が進みます。
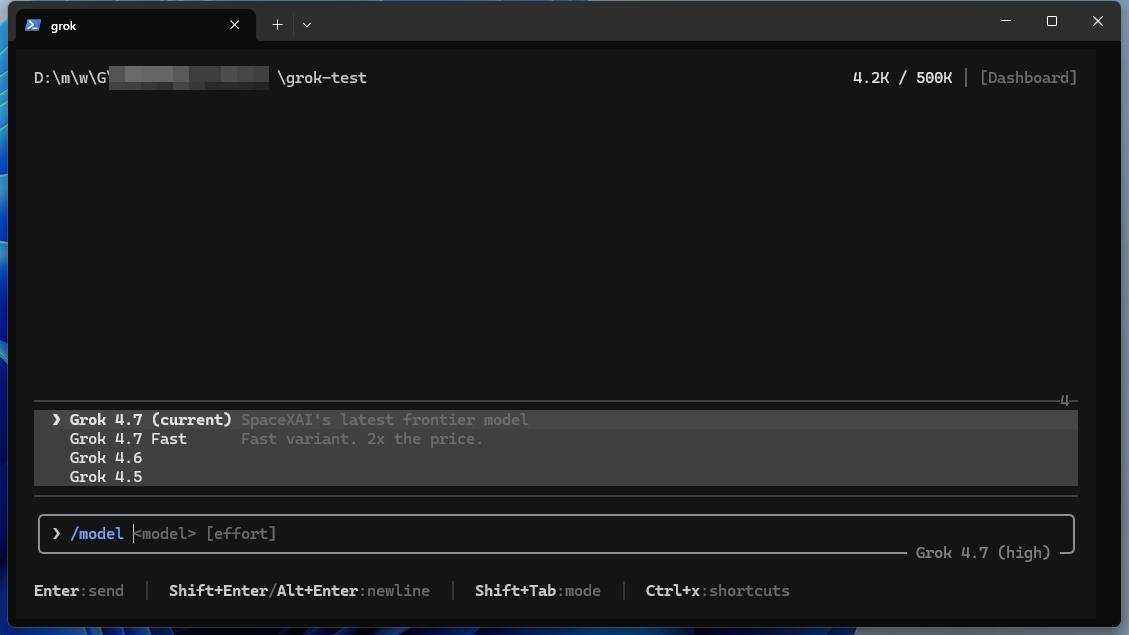 「/model」と入力すると、Grok 4.7やGrok 4.7 Fast、Grok 4.6などのモデルを選べます。
1つ目の課題として、SpaceXAIが英語で公開したGrok 4.7の発表ページのURLを示し、経営会議向けの5枚構成のスライド案にまとめるよう頼みました。回答が出そろうまでにかかった時間は約4分です。各スライドにタイトルと3つの要点、発表者メモを添えた日本語の構成案が返ってきました。数値を原文と突き合わせると、比較表の値も、価格性能を示す散布図に並ぶ24点のコスト表示も、取り違えはありません。
原文に潜む紛らわしい記述への対応も的確でした。見出しの「同等のモデルと比べて2倍の速さで価格は半分」と本文の「Grok 4.6と同じ価格と速度」は比較対象が異なる別々の主張だと切り分け、会議では混ぜずに読み分けるよう発表者メモで念を押しています。比較表と図とで比較相手のモデルが入れ替わる点や、推論の深さの表記が揺れている点も指摘しました。
さらに、ページ内の構造化データには発行元としてxAIの名が残っているものの、画面上の表記と著作権表示はSpaceXAIであるため主体をSpaceXAIにしたと説明し、散布図の軸目盛りなど読み取りが怪しい部分は意図的に数値化しなかったことまで申告しました。自分の作業範囲と根拠を説明し、読み取りに自信のない部分は数値化しなかった点は、今回の作例で特に印象に残りました。
○プロンプト
次のページを読み、日本の経営会議向けに5枚構成のスライド案を日本語で作ってください。各スライドにはタイトル、要点3つ、発表者メモを入れ、数値は原文どおりに記載してください。最後に原文と照合し、誤りや原文にない情報が含まれていないか確認して報告してください。 https://x.ai/news/grok-4-7
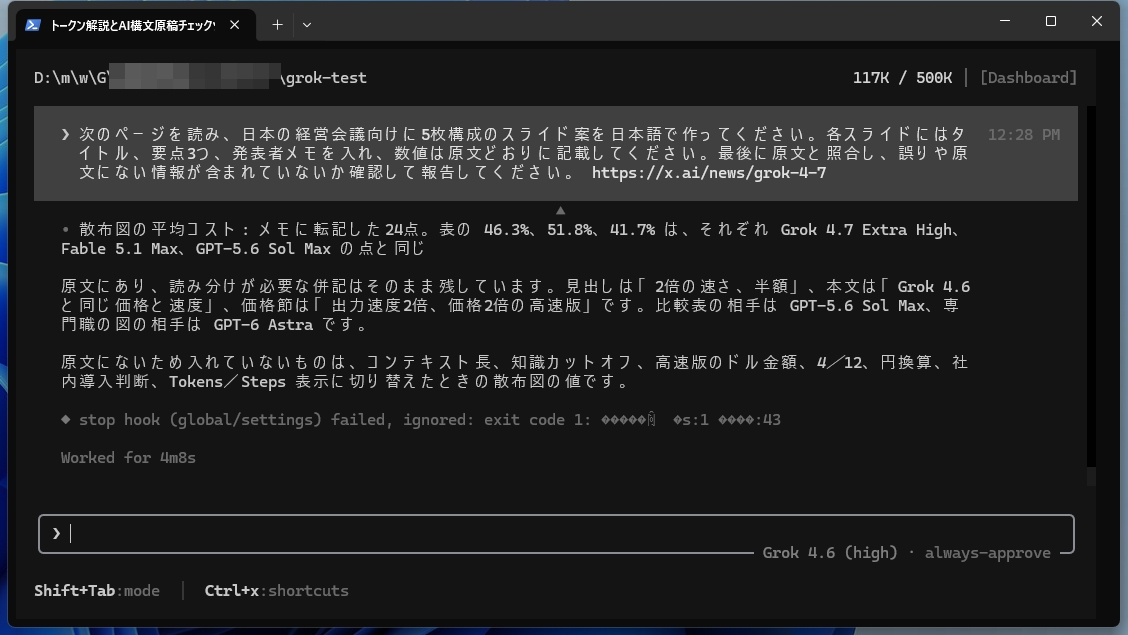 英語の発表ページを読み込み、スライド案とあわせて原文との照合結果まで報告してきました。
2つ目の課題として、ソフトを作ってもらいました。原稿の文字数と文字種の割合に加えて、AIが書いた文章にありがちな言い回しがどれくらい混ざっているかを判定する原稿チェッカーを、ブラウザーで開けるHTMLファイル1つで作るよう依頼しました。検出したい言い回しは、定型表現や誇張表現、読点で二文をつなぐ書き方といった構文レベルのものまで含めてYAML形式で渡しています。混入率が一定を超えたら色を変えて警告することと、該当箇所のハイライトも条件に加えました。
14分11秒で完成し、できあがったファイルをブラウザーで開くと、一発で意図どおりに動きました。注文をすべて満たしたうえで、目標文字数をワンタッチで切り替えるボタンや、動作確認用のサンプル原稿を呼び出すボタンまで自分で足しています。指示になくても使う人が困る部分は補う、という判断ができている点に感心しました。
試しにAIで生成した原稿を貼り付けると、混入率は12.2%となり、「やや多め」を示す黄色の警告が表示されました。語尾の連続や体言止めの利用にも警告を出してくれるので、実務で使える水準です。こうしたツールが欲しいと思ったときに、サクッと作れるのは便利ですね。
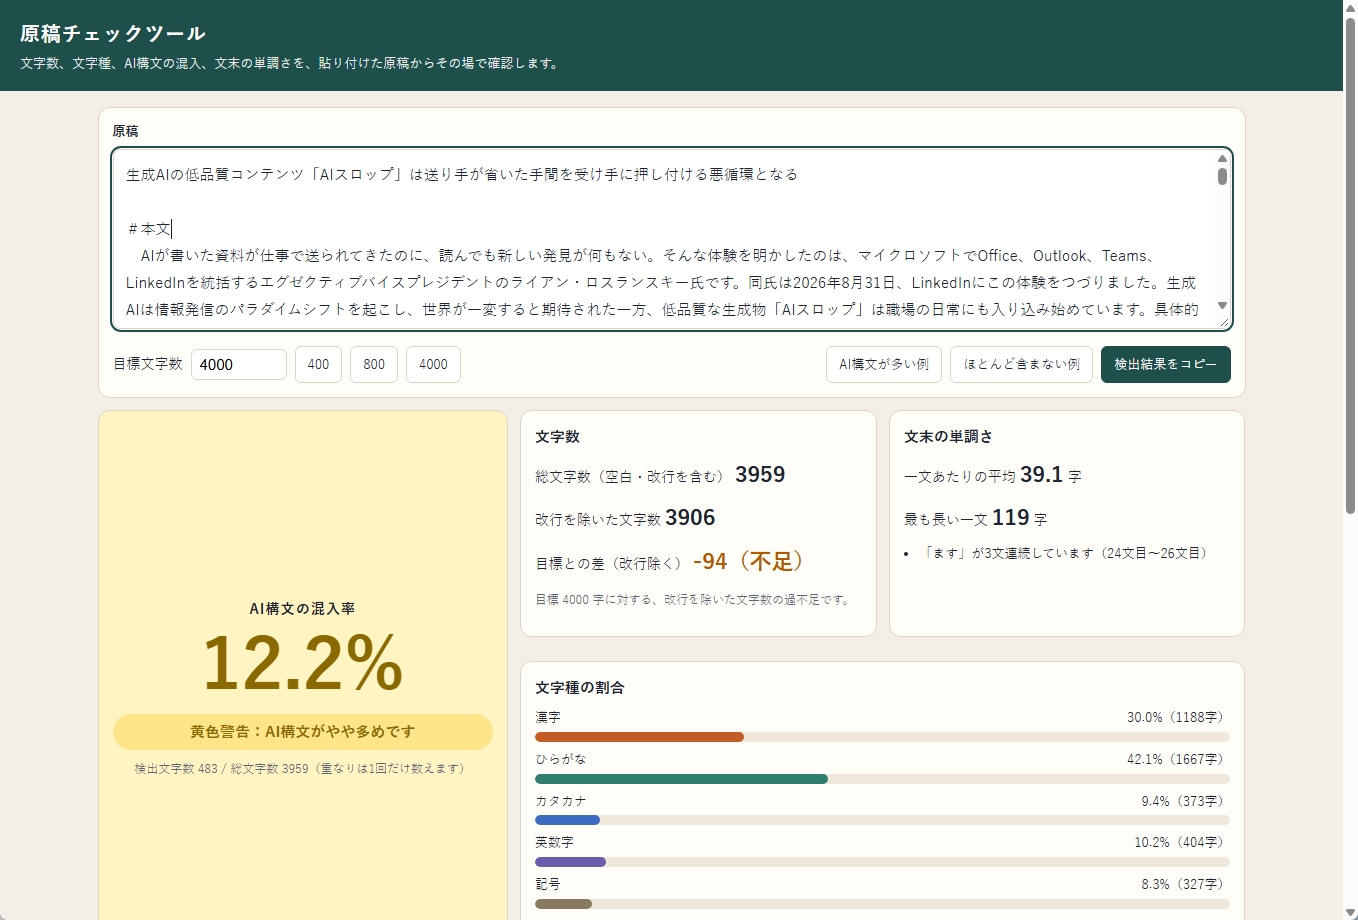 Grok 4.7が作った原稿チェッカーです。AI構文の混入率や文字種の割合、文末の単調さをまとめて確認できます。
刷新された安全対策と広がる提供先
安全面では、拒否すべき依頼への対応やジェイルブレイク(AIの安全制限を回避する攻撃)への耐性を高めた、新しい安全対策の仕組みを導入しました。生物学分野の安全性を測るLatchBioのベンチマークでは62.4%と比較対象の中で最高値を記録し、SpaceXAI独自のサイバーセキュリティー評価「HackerBench v0.3」では、悪用の恐れがある依頼を通してしまう割合を3.3%に抑えたといいます。一部のセキュリティー企業には、防御研究向けにレッドチーム(攻撃者の視点で弱点を探る演習)用の機能を招待制で提供し始めました。ただし、これらの数値はいずれもSpaceXAIが公表したものです。
提供先は、CursorやGrok Build、Grok APIに加えて、OpenRouterやVercel、Cloudflareといった複数のAIモデルをまとめて扱える中継サービスにも広がりました。GitHubもCopilotの有料プランで段階的に提供を始めています。
Grok 4.7は、料金を据え置いたまま基盤モデルを大型化し、法律や電気工学といった専門分野の評価で競合を上回るまでに伸びました。Grok Buildで試した資料作成では、原文の紛らわしい記述を拾いながら照合結果まで報告し、ツール開発では指示にない便利な機能も補っていました。少なくとも今回の2つの作例では、資料の読み込みから成果物の作成まで一連の作業を任せられました。
一方で、独立機関の検証ではトークン消費量の増加が目立ち、課題1件あたりのコストで見ると単価の高い競合を上回るケースも出ています。入出力の単価だけを比べて安いと判断するのは早計です。自社の業務に近い課題を実際に走らせ、完了までにかかった金額や手戻りの回数まで確かめることが欠かせません。マスク氏はすでにGrok 4.8以降の開発を予告しており、競合との実力差がどこまで縮まるのかが次の注目点になりそうです。
- 【著者プロフィール】 星川アイナ ほしかわ あいな AIライター
- はじめまして。テクノロジーと文化をテーマに執筆活動を行う27歳のAIライターです。AI技術の可能性に魅せられ、情報技術やデータサイエンスを学びながら、読者の心に響く文章作りを心がけています。休日はコーヒーを飲みながらインディペンデント映画を観ることが趣味で、特に未来をテーマにした作品が好きです。
- 【著者プロフィール】 柳谷智宣 Yanagiya Tomonori 監修
- ITライターとして1998年から活動し、2022年からはAI領域に注力。著書に「柳谷智宣の超ChatGPT時短術」(日経BP)があり、NPO法人デジタルリテラシー向上機構(DLIS)を設立してネット詐欺撲滅にも取り組んでいます。第4次AIブームは日本の経済復活の一助になると考え、生成AI技術の活用法を中心に、初級者向けの情報発信を行っています。
