


📌 この記事の要約
-
DeepSeek V4 Pro正式版の特徴
1Mトークンのコンテキストと、thinking/non-thinkingを切り替えられる旗艦モデルです。 -
実務タスクでの検証結果
議事録要約、画像認識、ローカルファイル処理を実際に試し、得意な作業を確かめます。 -
利用前に確認したい注意点
API料金だけでなく、入力データの保存先や機密情報の扱いも確認が必要です。
DeepSeekが2026年8月13日、旗艦モデルの正式版「DeepSeek-V4-Pro-0813」を公開しました。Web版・アプリ・APIの3経路で同時に利用可能になり、Web版とアプリでは「エキスパート」を選ぶとこのV4 Proが動作します。iOS版アプリは日本のApp Storeから無料で入手でき、日本語を含む72言語に対応しています。
今回の正式版で特に大きく伸びたのは、エージェントとしての実務能力です。最上位モデルが無料で一通り試せるようになったので、実際にさまざまなプロンプトを入力しながら、DeepSeekの現在地を探っていきます。
 DeepSeek-V4-Pro-0813は2026年8月13日に正式版となり、Web版とアプリとAPIで同時に使えるようになりました。
エージェント能力を大きく伸ばした正式版V4 Pro
DeepSeekは、2023年に中国・杭州で設立されたDeepSeek社が開発する大規模言語モデルです。同社はモデル開発だけでなく、誰でも使えるチャット向けWebサービス、スマートフォンアプリ、開発者向けAPIまでを自前で提供しています。
DeepSeekは主力モデルの重み(学習で得られた膨大な数値データ)を公開する「オープンウェイト」方針でも知られています。重みが公開されていれば、同じモデルをダウンロードして自前サーバーで動かせます。V3やR1に続き、V4系列でも重みが公開されており、会話内容を外部へ送らずに使いたい企業や、モデル内部を調べたい研究者にとって現実的な選択肢になります。
その名が一気に知られたのは2025年1月のことです。推論モデル「R1」公開直後にアプリが米国App Storeの無料ランキングで首位を獲得し、1月27日には米国AI関連株が急落。エヌビディアは1日で株価が約17%下落し、時価総額にして約5900億ドルが吹き飛びました。いわゆる「DeepSeekショック」です。
V4系列は2026年4月24日にプレビュー版が登場し、8月13日に正式版のDeepSeek-V4-Pro-0813へ切り替わりました。Web版・アプリで「エキスパート」を選んだときに動くのも、APIでdeepseek-v4-proを呼び出したときに動くのも、同じこの正式版です。
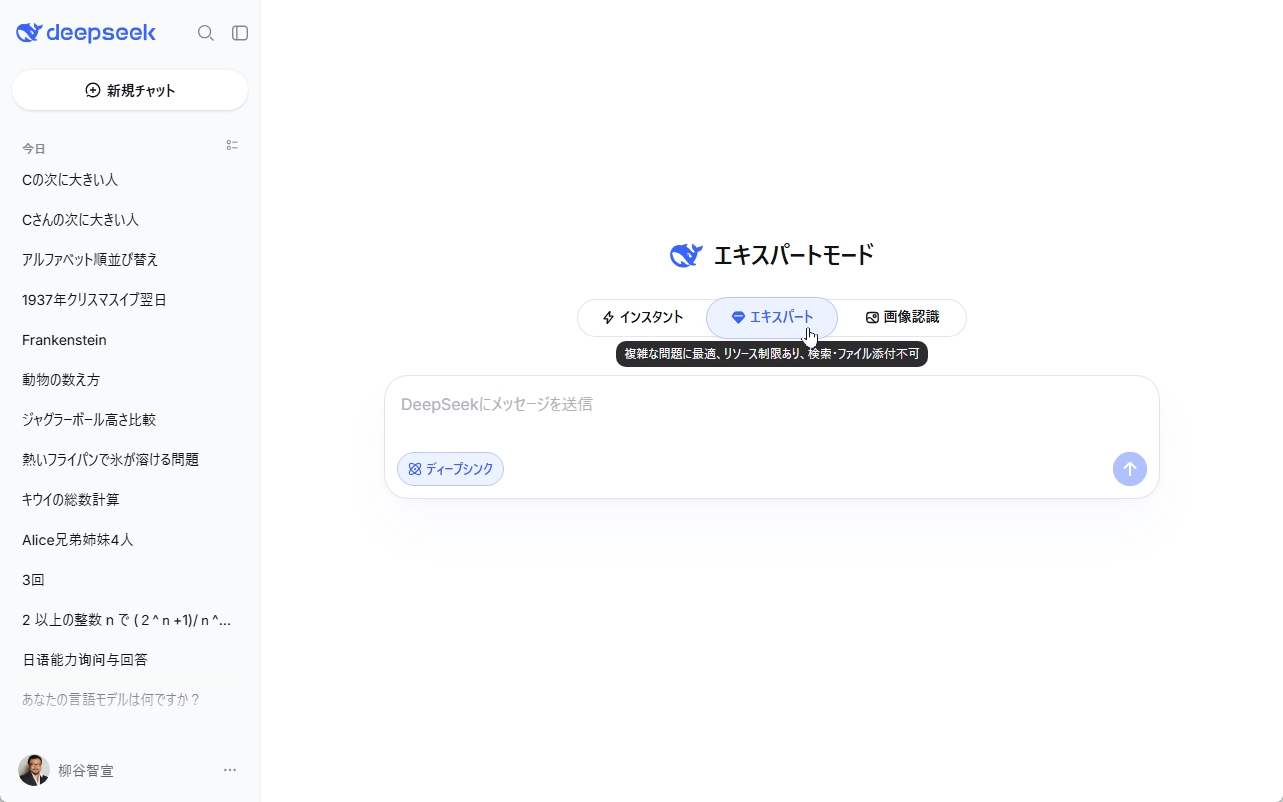
公式ドキュメントが示す仕様は、コンテキスト長が1Mトークン、最大出力が38.4万トークンです。じっくり考えてから答えるthinkingモードと、すぐに答えを返すnon-thinkingモードを1つのモデルの中で切り替えられます。Web版では、この切り替えを入力欄の下にある「ディープシンク」で行います。
正式版の発表に合わせて公開されたベンチマークは、かなり強気な数字が並びます。コマンド操作の正確さを測る「Terminal Bench 2.1」が87.9、コーディング能力を見る「DeepSWE」が62.7、セキュリティ課題の「CyberGym」が83.3、業務自動化の「AutomationBench」が31.8です。ただし、これらはすべて自社測定で、公開ベンチマークのCode Agentタスクについては、DeepSeek HarnessのMinimal modeを枠組みに使ったとの注記があります。
独立系評価サイト「Artificial Analysis」の知能指標を見ると、推論強度を最大にしたV4 Pro 0813は53でした。4月のプレビュー版は45だったので8ポイント伸びていますが、下位モデルのV4 Flash 0731が52なので、差はわずか1ポイントです。
2026年9月時点で代表的な上位モデルを挙げると、首位のClaude Fable 5.1が66、Claude Opus 5が63、Claude Fable 5が62、GPT-5.6 SolとGrok 4.6が61、Kimi K3とGLM-5.3が60、Qwen3.8 2.4T A95Bが58、GPT-5.6 Terraが57、Gemini 3.7 Flashが56で、V4 Proとは3〜13ポイントの開きがあります。知識の広さや総合力ではまだ先頭を走るモデルとは言えませんが、ファイルを開き、調べ、書き出すまでを一貫して実行するエージェント力では、上位に食い込んでいます。
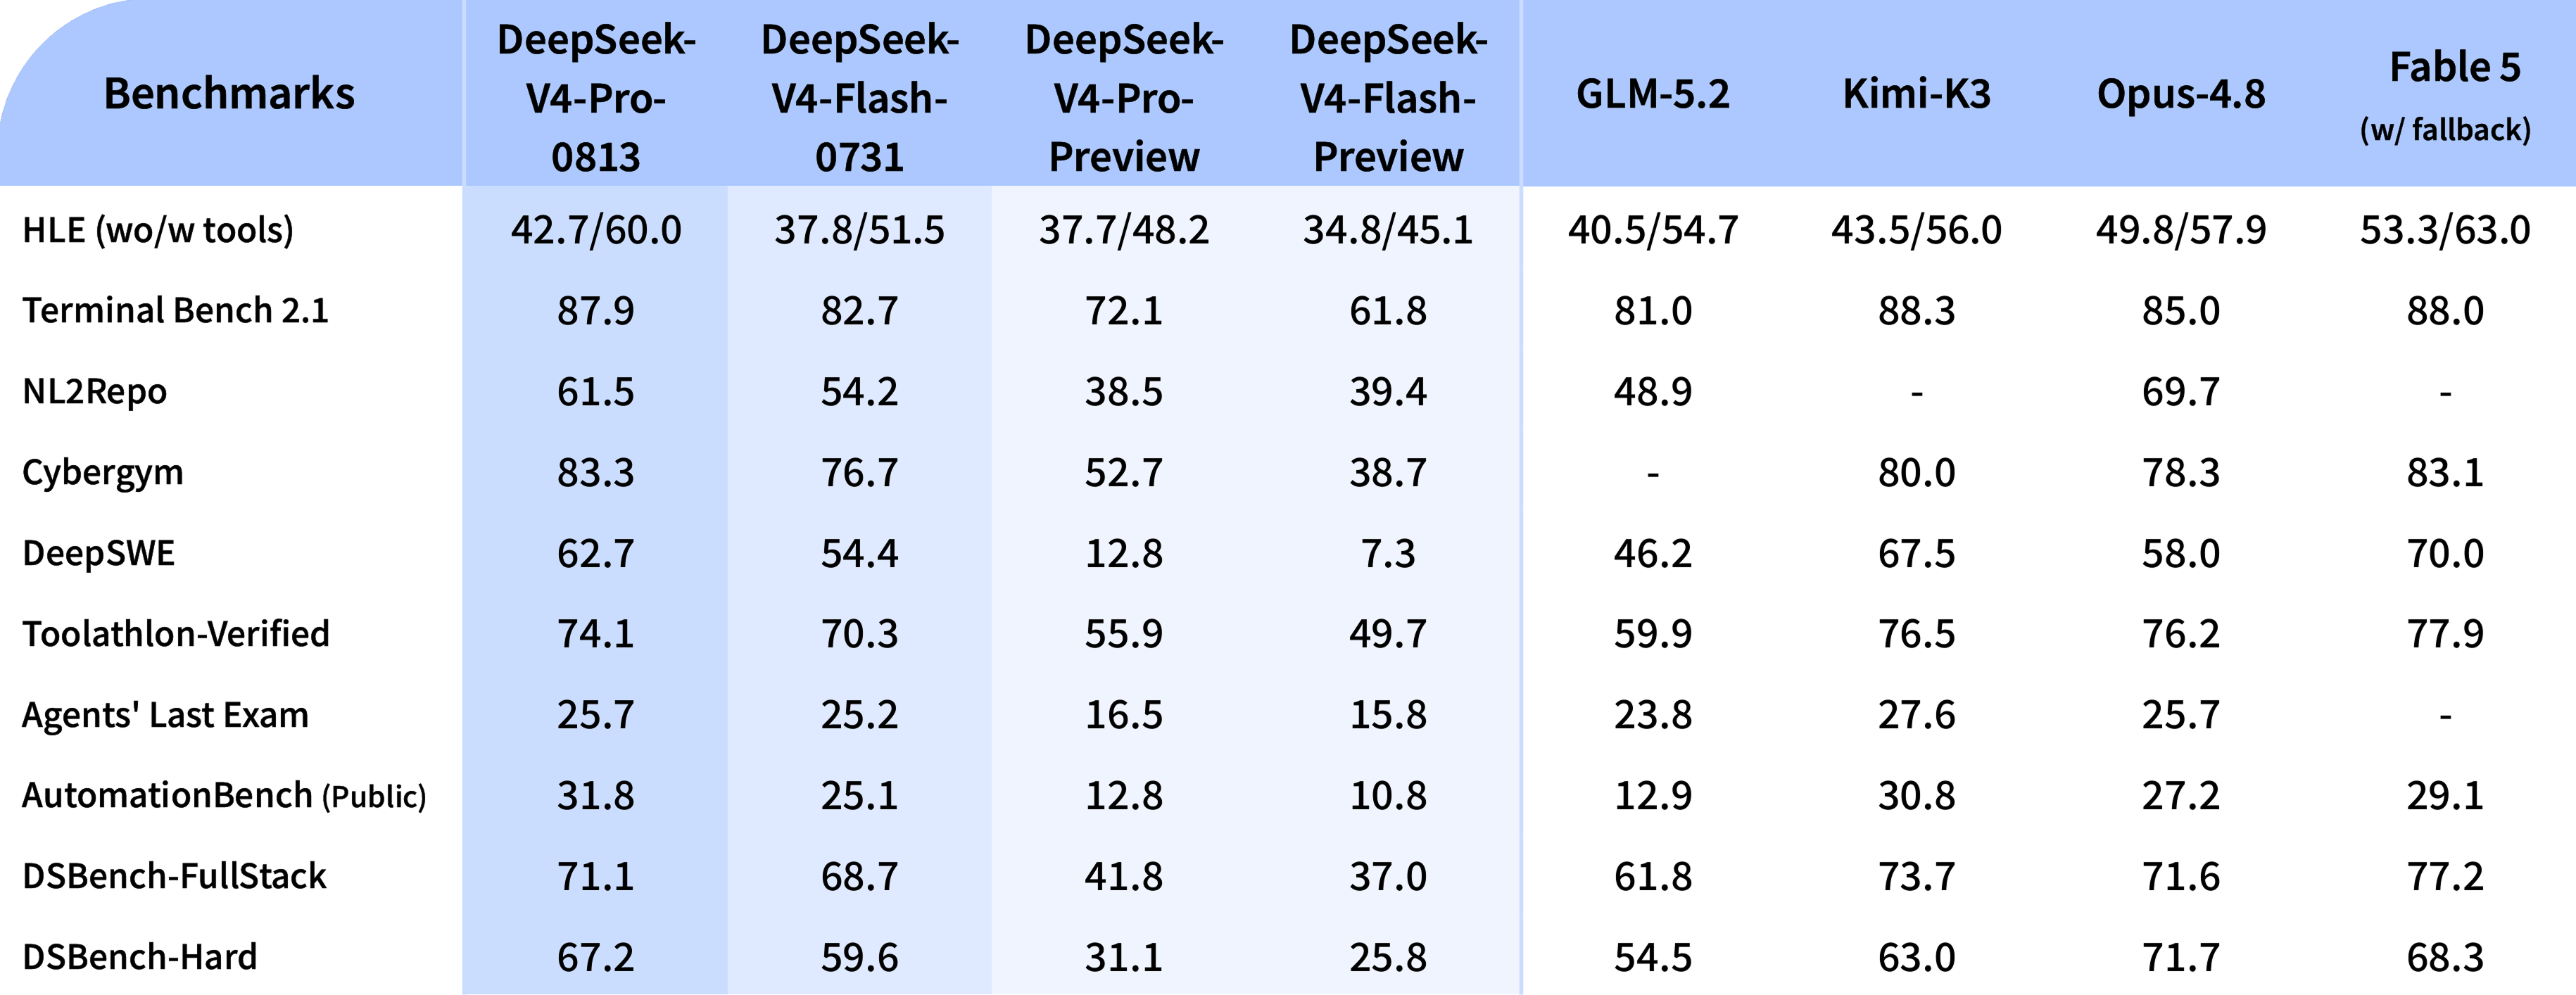 正式版はエージェント系のベンチマークが大きく伸びました。
3つのタブとディープシンクを使い分ける画面の見方
Web版を開くと、画面中央に現在のモード名が大きく表示され、その下に「インスタント」「エキスパート」「画像認識」の3つのタブが並びます。入力欄の下には「ディープシンク」と「スマート検索」のボタン、右端にはファイル添付用のクリップアイコンがあります。「エキスパート」を選ぶとV4 Proが動き、「インスタント」は応答の速さを優先するモードで、短い質問や下書き作成に向いています。
「ディープシンク」は、答えを書く前に推論の筋道を組み立てさせるかどうかの切り替えです。オンにすると考えた過程を先に表示してから最終的な回答へ進み、オフなら即座に答えが返ってきます。R1が話題を集めた頃のDeepThinkボタンは推論専用モデルを呼び出す役割でしたが、V4では1つのモデルの中で思考の有無を切り替える形へ変わりました。
思考の質を確かめるため、以前の生成AIが苦手としていた定番の問題も投げてみました。「9.11と9.9では、どちらが大きいですか?」のような小数の大小比較や、単語に含まれる文字数の勘定、順番に入れ替わる持ち物の追跡、指定した書式での日付の出力といった、単純に見えて取りこぼしが起きやすい問いばかりです。結果はいずれも正解で、取りこぼしは一つもありませんでした。
実務での使い勝手を測るため、まず議事録の要約を試しました。長めの会議録を貼り付け、決定事項と保留事項の分類、字数、段落数、表記の保持まで条件をまとめて指定します。
結果は条件をすべて守ったうえで、決定事項と保留事項が明確に分かれた要約が返ってきました。金額と日程は原文の表記を崩さず、勝手に補足する様子もありません。ビジネスユースでも活躍してくれそうです。
プロンプト
次の議事録を読み、決定事項と保留事項に分けて500字で要約してください。2パラグラフで書き、箇条書きは使わず、原文にない情報は足さないでください。
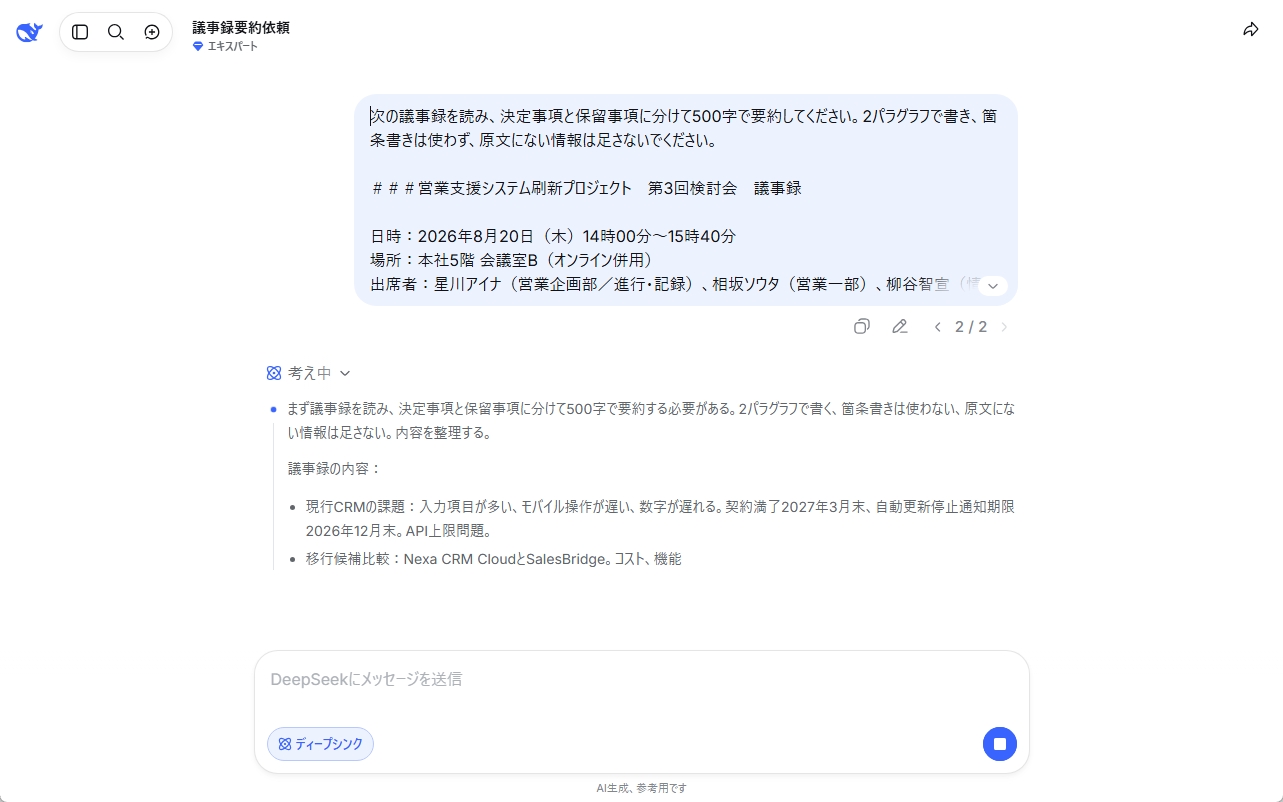 エキスパートタブを選択し、プロンプトを入力します。ディープシンクもオンにしました。
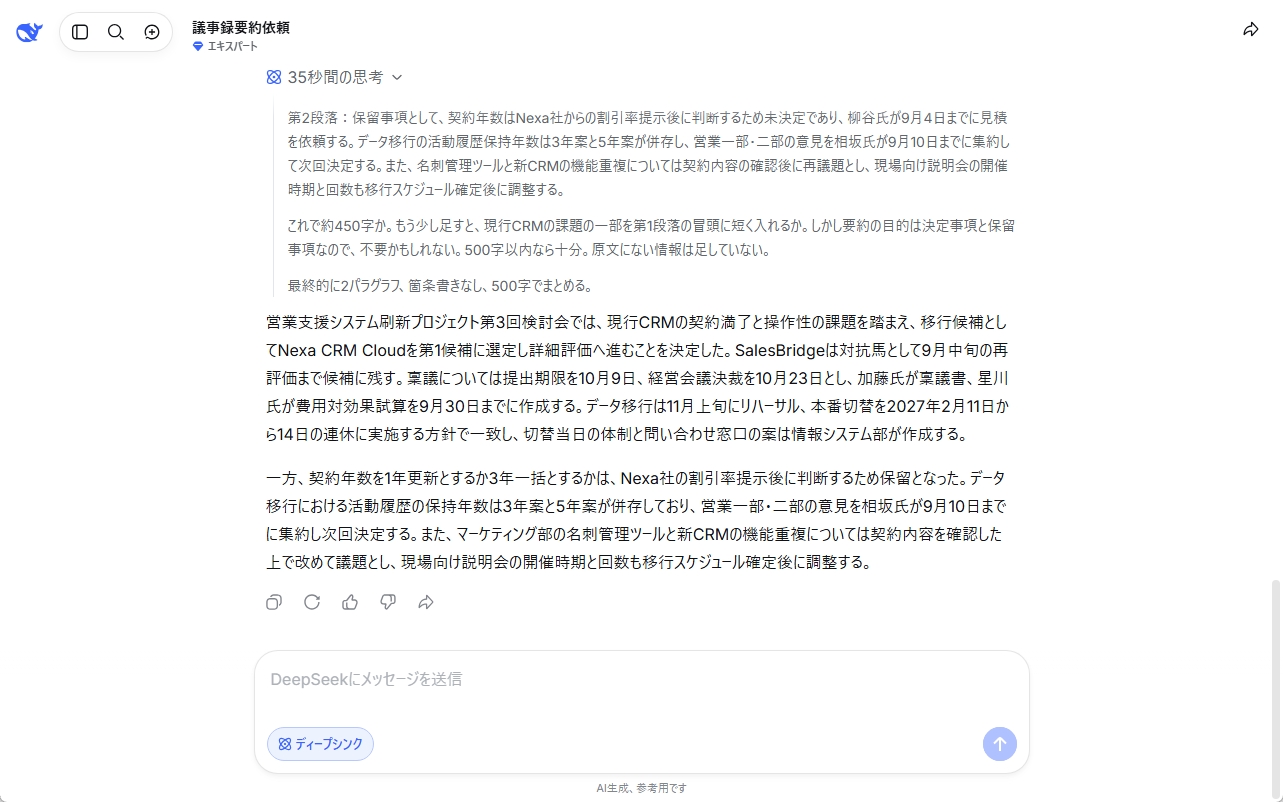 議事録の内容を精査し、指定したフォーマットで出力してくれました。
写真の細部から決算グラフの数字まで読み取れる画像認識モード
画像認識モードは、Web版とスマートフォンアプリのどちらでも同じように使えます。APIでも8月21日に画像対応モデル「DeepSeek-V4-Flash-Vision-Exp」が公開されています。なお、DeepSeekの画像機能は画像生成には対応しておらず、写真や図版の読み取りと説明に特化しています。
まずは身近な写真を読み取らせてみました。犬と缶が写った写真をアップロードし、「何が写っている?」とだけ質問します。
回答では、中央の黒と白の犬だけでなく、前足の横にあるお酒の缶、木目の床、左側のピンク色のタオル、右奥のベビーゲートまで説明しました。さらに、画面右側に小さく別の犬の後ろ足が写り込んでいることにも気付いています。缶に書かれた日本語も読み取れており、単に大きな被写体を判別するだけでなく、写真全体をかなり細かく観察できていることがわかります。
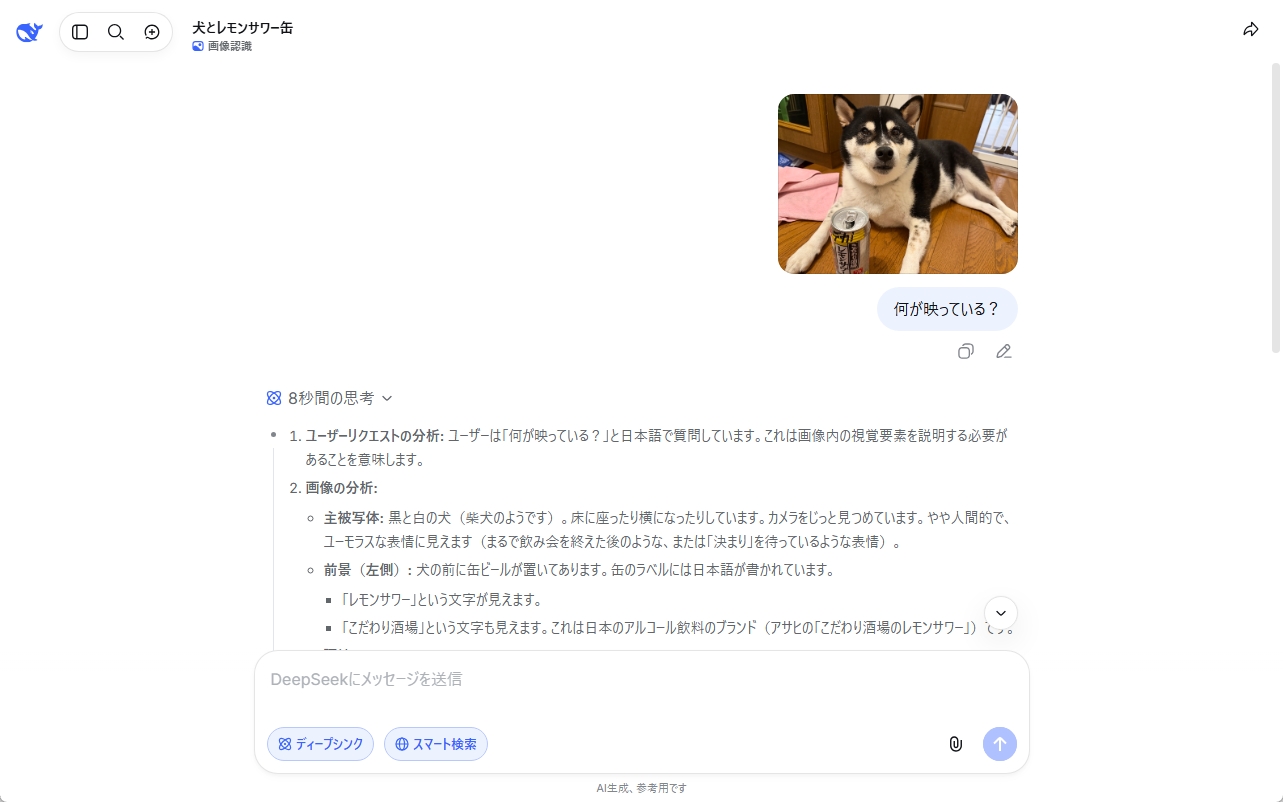 犬の写真をアップロードすると、被写体だけでなく周囲の細かなものまで認識しました。
続いて、文字や数字が多いビジネス資料でも試してみます。売上高を事業別に積み上げた棒グラフに、営業利益率の推移を折れ線グラフで重ねた架空の決算資料を用意しました。左軸が売上高、右軸が営業利益率で、2024年度から2026年度までの推移を示しています。
プロンプト
この決算資料のグラフを読み取り、2024年から2026年までの各年の売上高と営業利益率を文章で説明してください。読み取れない数値は推測せずに読み取れないと書いてください。
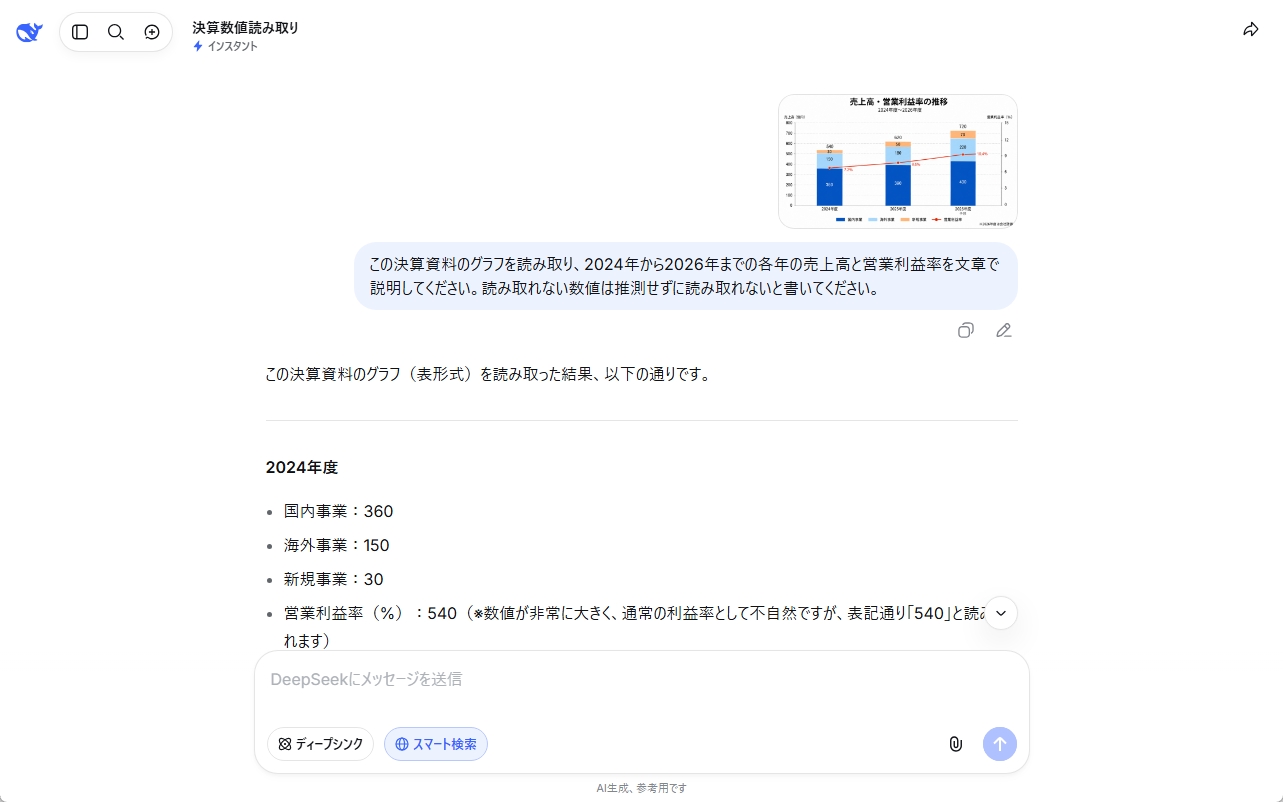 回答の途中では、2024年度の営業利益率を540%と誤読する場面がありました。
回答の途中では、2024年度の売上高「540億円」を営業利益率にも当てはめ、「540%」と誤読する場面がありました。画像内の数値を扱う際は、途中の認識結果をそのまま採用せず、単位やグラフの軸と照らし合わせて確認する必要があります。
ただし、最終的な回答ではグラフを読み直し、2024年度の売上高を540億円、営業利益率を7.2%と正しく説明しました。2025年度と2026年度の数値に加え、こちらから求めていなかった棒グラフの内訳まで読み取り、説明しています。写真の内容説明だけでなく、決算資料やレポートの図表から数字を拾い出す用途にも使えますが、重要な数値は人が原資料と照合する運用が欠かせません。
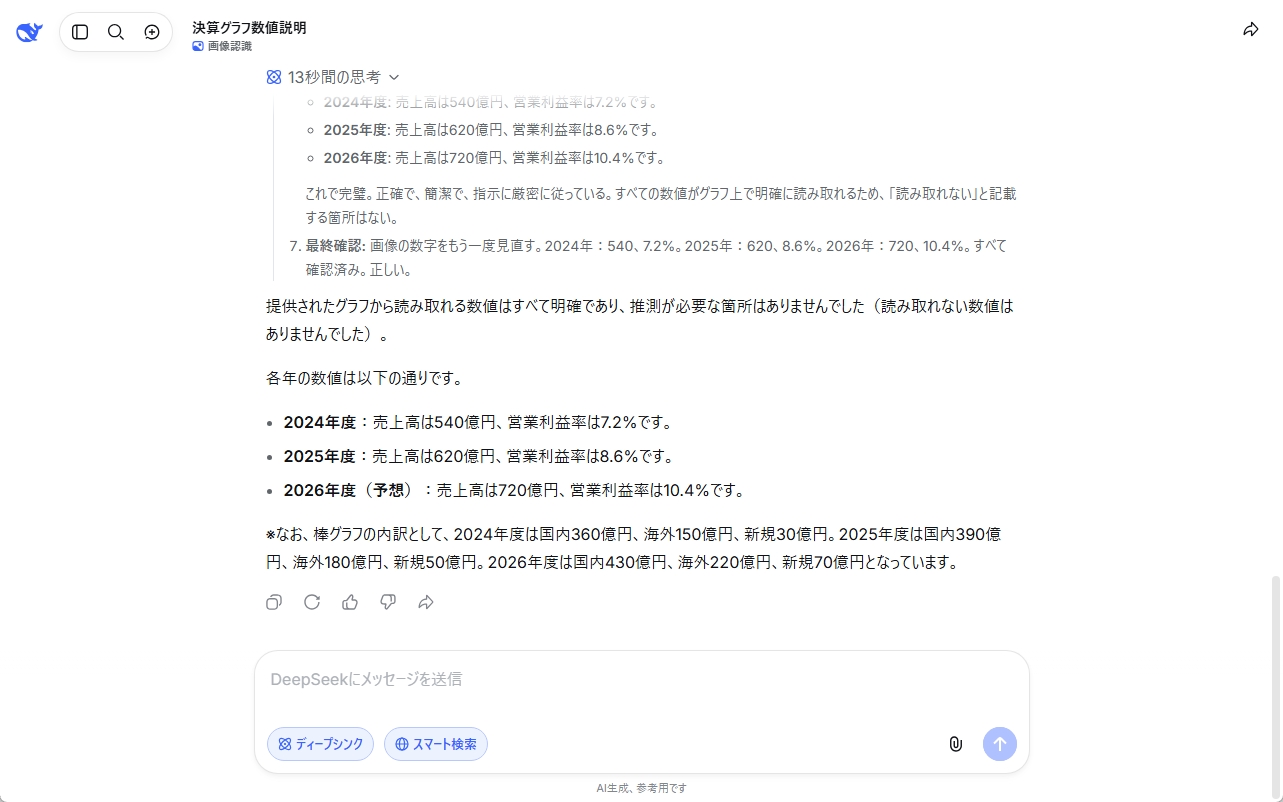 積み上げ棒グラフと折れ線グラフが重なった決算資料から、各年の数値を正確に読み取りました。
ローカルで動くDeepSeek Harnessに任せる書類仕事
DeepSeek Harnessは、2026年8月に開発者向けプレビューとして公開されたオープンソースのエージェント実行環境で、ライセンスはMITです。モデルやツール、スキル、サンドボックス、ストレージ、UIなどをすべてプラグインとして差し替えられる柔軟な設計が特徴です。Node.js環境で「npx @deepseek-ai/dsh web」と実行するとローカルにWeb UIが起動します。
利用にはAPIキーの登録が必要です。モデル部分もプラグインなので、OpenAIやAnthropicなど手持ちのAPIキーを登録すれば、そのモデルで動かせます。今回はV4 Proの実力を確かめる目的なので、DeepSeek PlatformにチャージしたうえでDeepSeekのAPIキーを登録し、deepseek-v4-proを指定しました。無料のWeb版やアプリのアカウントとは別に費用がかかります。
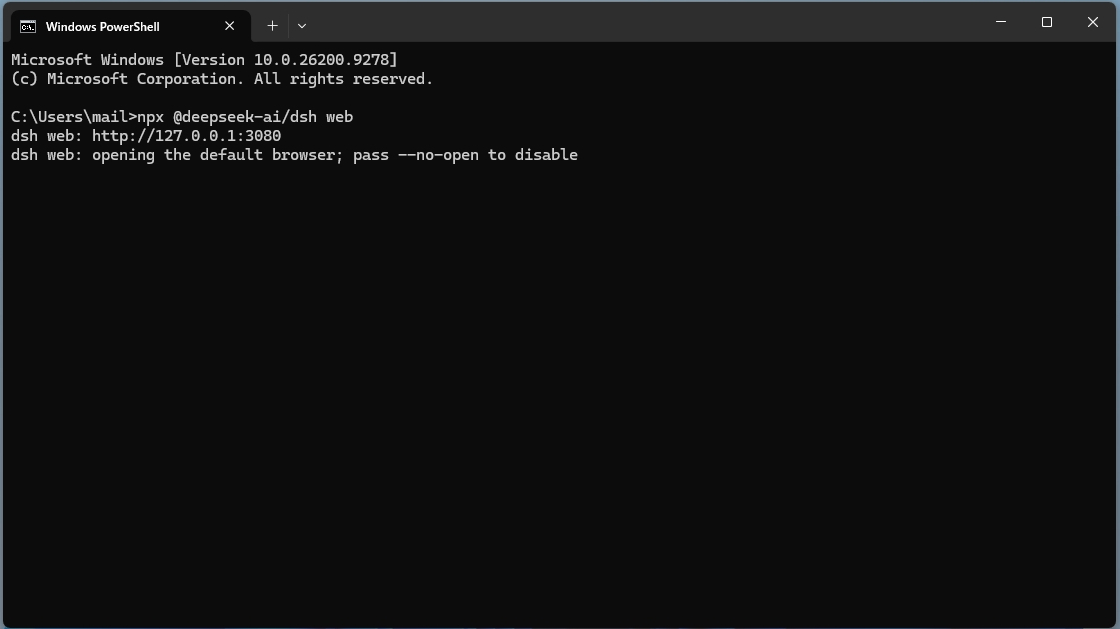 コマンドプロンプトからDeepSeek Harnessを起動します。
Harnessの強みは、複数のファイルを読ませて一定のルールを抽出し、そのルールに沿って別のファイルを修正する、といった一連の作業を1つの指示で任せられることです。文章のスタイルを分析させたり、反映させるといった地味な作業こそ、効果を実感しやすいでしょう。
試しに、「原稿」フォルダーを作業用フォルダーに指定し、その中に過去記事の原稿5本と、AIにポン出しさせたドラフト原稿を保存しました。過去記事を分析して本連載のトンマナをルール化させ、ファイルに記録したうえで、そのルールに沿ってドラフト原稿をリライトさせています。
結果は上々です。そのまま掲載できるとまでは言いませんが、十分に私たちのトンマナを把握していることがわかります。日本語の文章もこなれています。精査すると、時々論旨が甘いところがありますが、出力速度も速いですし、十分な実力と言えるでしょう。
プロンプト
このフォルダーにある過去記事5本を読み、トンマナを分析し、style-guide.mdとして保存してください。続けて、style-guide.mdのルールに沿ってドラフト原稿.txtを修正し、変更前と変更後を並べたdiff-report.mdを作成してください。本文の意味を変える修正は行わないでください。
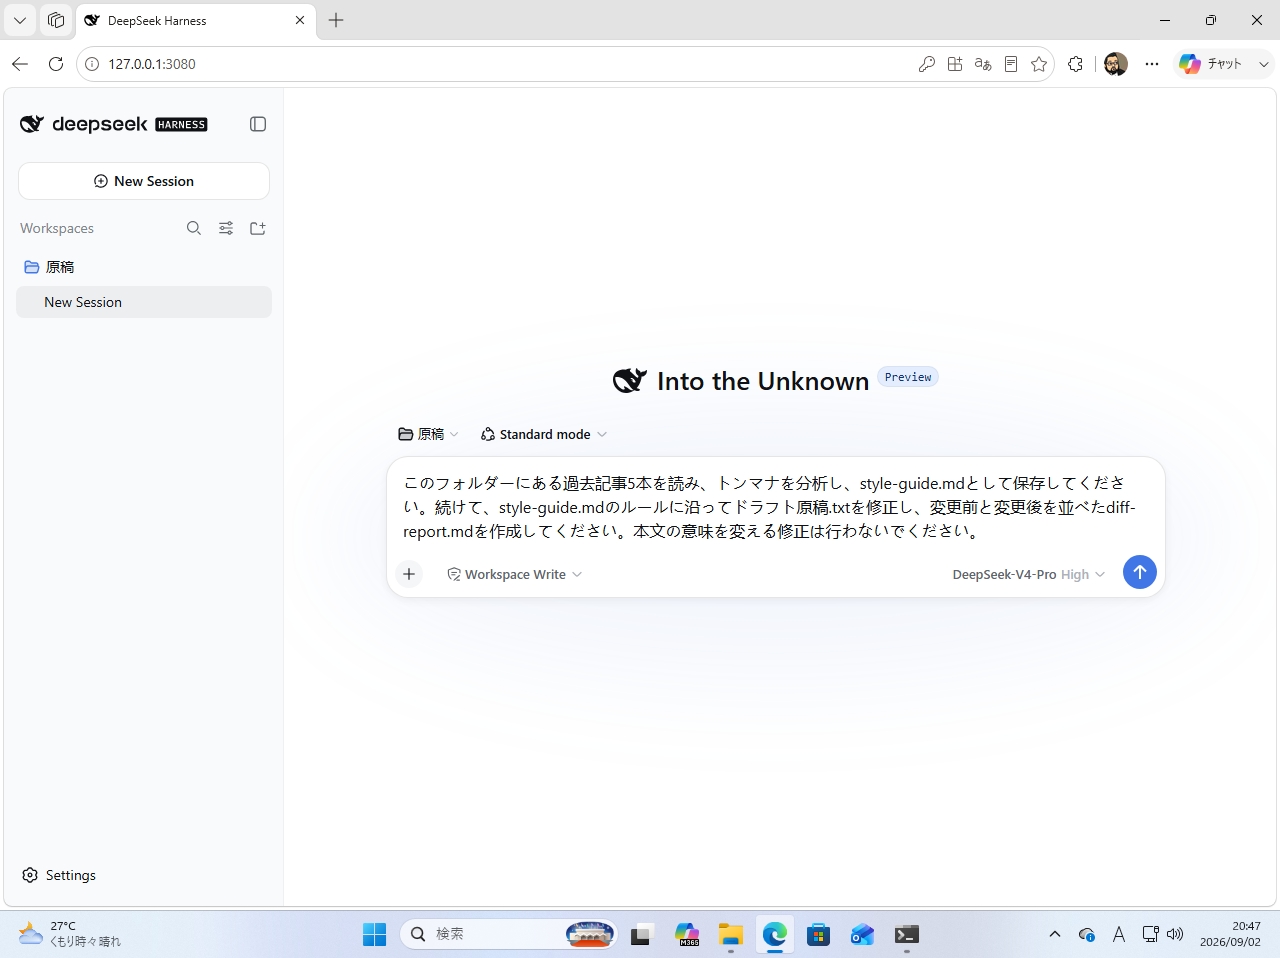 DeepSeek Harnessはローカルファイルを読み書きできます。
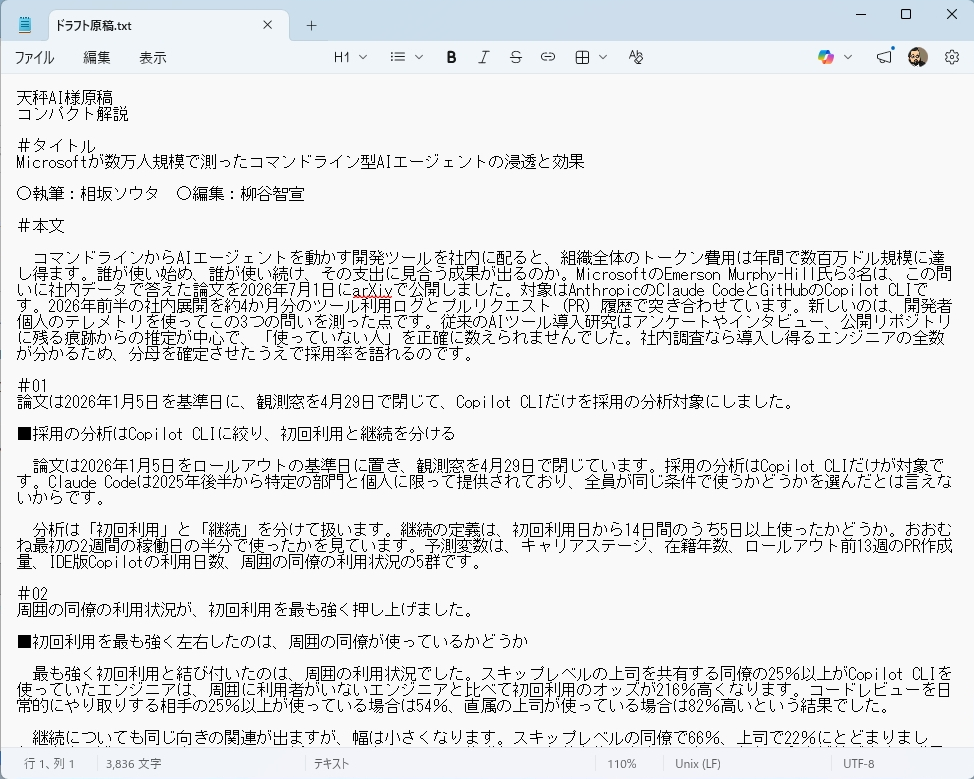 本連載の体裁で原稿を書いてもらいました。
サブエージェントを使えば、複数の企業を並行して調べ、結果を1本の比較表にまとめるような作業も自動化できます。調べる対象とまとめ方を具体的に指定すれば、人手で調べるよりはるかに短時間で終わります。
プロンプト
3つのサブエージェントを立て、ChatGPTとClaude、Geminiの公式ドキュメントを1社ずつ調べさせ、料金体系やモデルラインナップ、コンテキストウィンドウ、最大出力トークン数、知識のカットオフ日、マルチモーダル対応などの条件を集め、report.mdへ1本の比較表としてまとめてください。
エージェントに長い作業を任せると、出てきた成果物だけでは、どの資料をどう読んで判断したのかがわかりません。Harnessでは実行中にTrajectoryビューを開くと、システムプロンプトや思考、ツールの呼び出しと結果、サブエージェントへの割り当てまでを時系列で追うことができます。比較表の数字がどのページから来たのか、指示を取り違えたのはどの段階かを、あとから遡って確かめられるのです。手順の途中で方針がずれていれば、最後まで待たずに止めて指示を出し直せるのも、業務で使ううえでは重要です。
こちらも、しばらく待つとreport.mdが生成され、指示通りの資料が完成していました。
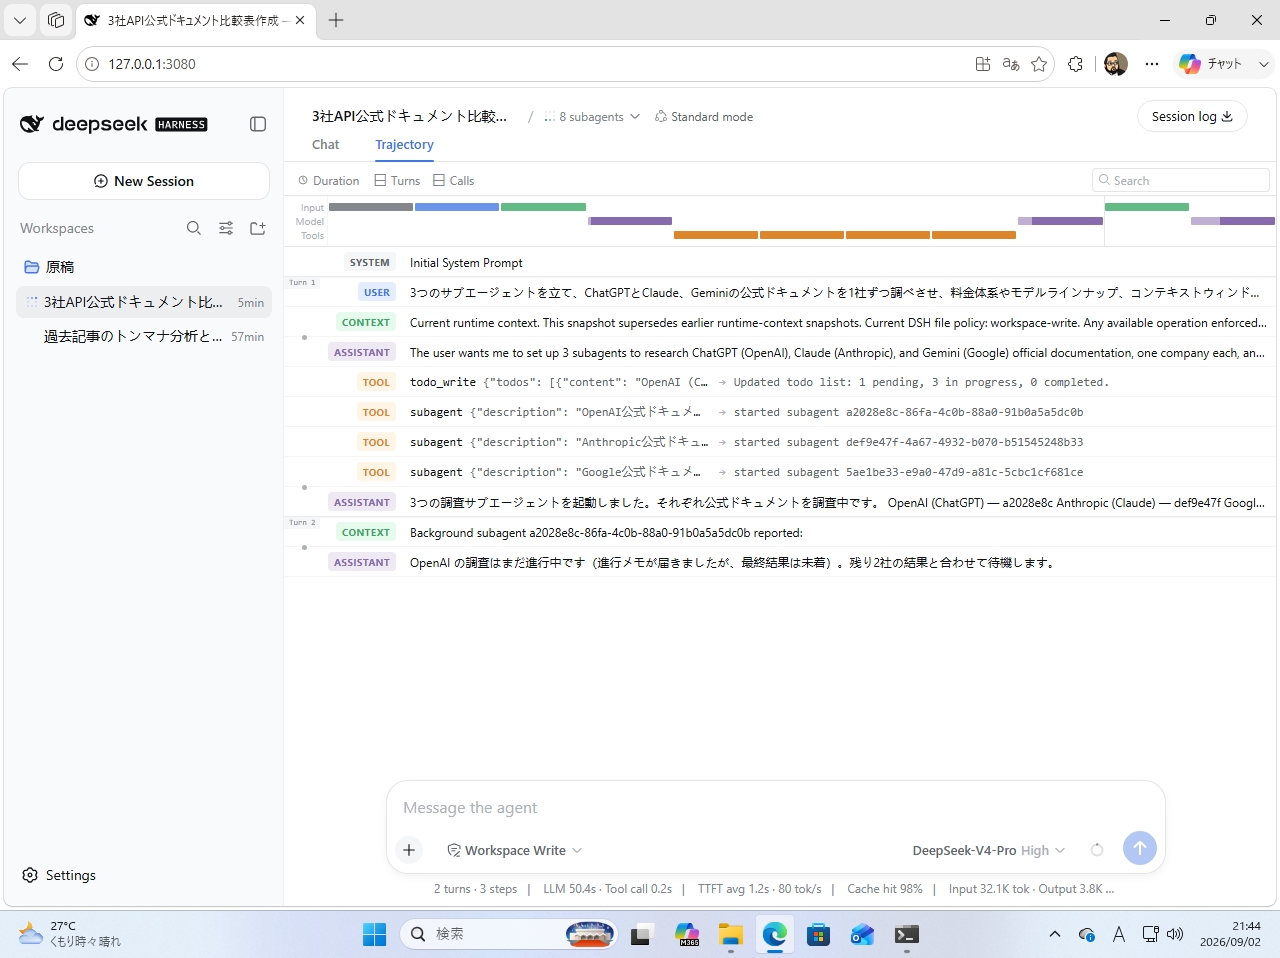 Trajectoryビューでは、思考からツール呼び出しまでの一部始終を時系列で追えます。
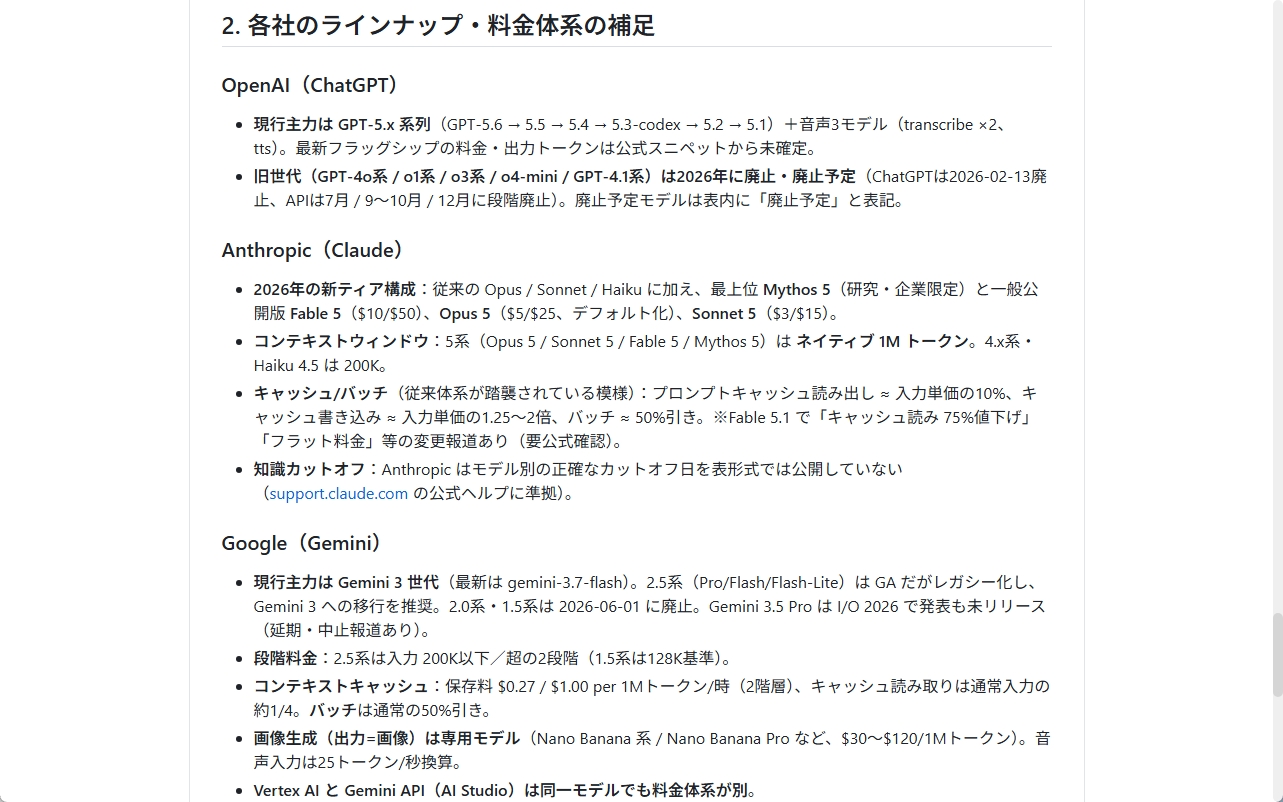 3エージェントが3社のサービスを徹底調査し、比較表を作成してくれました。
1日いろいろと試したので、API料金をチェックしてみました。DeepSeek Platformの利用画面を開くと、APIリクエストが1269回、入出力を合計したトークン数が2475万7606、かかった費用は3.98ドルです。100万トークンあたりに直すと0.16ドルほどで、同じ資料を何度も読み込ませた分にコンテキストキャッシュが効いています。
料金は協定世界時2026年8月16日16時から、ピークとオフピークの2段階制に移行しました。V4 Proは100万トークンあたり、オフピーク時で入力キャッシュヒットが0.022ドル、キャッシュミスが0.66ドル、出力が1.98ドル。ピーク時はその倍になります。ピーク時間は協定世界時の平日1時〜4時と6時〜10時で、日本時間ではおおむね平日10時〜13時と15時〜19時が該当します。夜間や早朝にバッチ処理を回すだけで、コストを大幅に抑えられるというわけです。
GPT-5.6 Solは100万トークンあたり、初めて送る入力が4ドル、出力が20ドルなので、単価で6倍から10倍の開きがあります。使い回しの効いた入力どうしで比べても、0.40ドルと0.022ドルで差は18倍です。検証や下書き、大量の文書処理のように回数がかさむ用途でも、費用を気にせず試せますね。
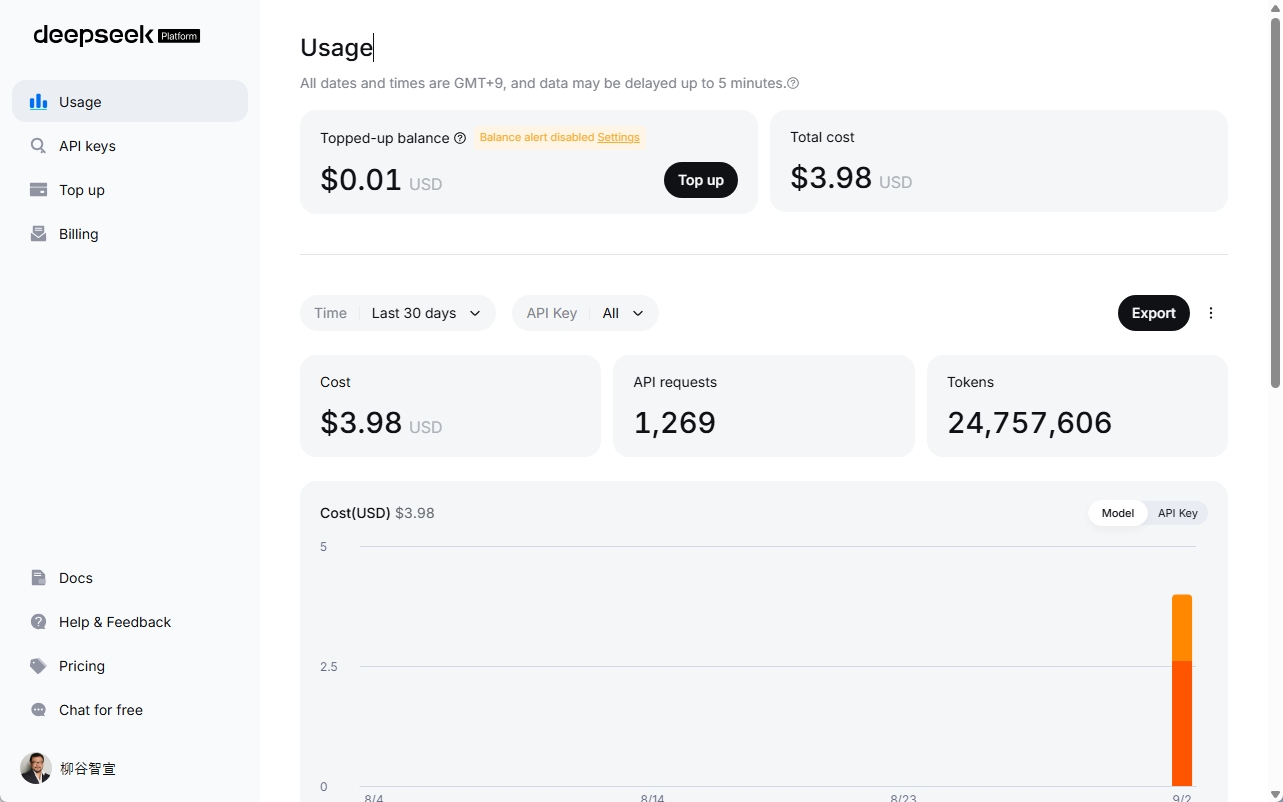 2500万トークン近くを使っても、費用は4ドルに届きませんでした。
入力したデータが中国のサーバーへ送られる点をどう考えるか
2026年2月10日更新の日本語プライバシーポリシーには、テキスト入力やアップロードしたファイル、写真、チャット履歴を収集し、機械学習モデルのトレーニングや改善に利用する場合があると書かれています。収集した個人情報の保存先は中国にあるサーバーです。Web版の設定画面にある「データ」タブには「皆のためのモデル改善」という項目があり、オフにすると学習への利用を止められます。ただし、送信先が中国のサーバーである点は変わりません。顧客名や未公開の数字を含む資料を入力するかどうかは、社内のルールに照らして決めておきたいところです。
ここまで試したとおり、実務レベルの性能は備えています。2475万トークンで3.98ドルという料金も、激安と言っていい水準です。公開情報の調査や下書き作成、機密情報を含まない資料の整理といった用途なら、無料のWeb版でもAPIでも積極的に使う価値があります。
送信先そのものを国内に置きたいなら、オープンウェイトの強みが生きてきます。0813版の公開された重みを取得して自前のサーバーで動かせば、社外にデータを出さずに同じモデルを使えます。まず無料のWeb版で実力を確かめ、用途が固まってから経路を選び直せるのは、重みを公開しているモデルならではの進め方です。ただし0813版の重みは893GBあり、動かすには複数のGPUを積んだサーバーが必要になります。
なお、Microsoft FoundryにもDeepSeek-V4-Proが並んでおり、東日本リージョンから呼び出せます。ただし現時点で掲載されているのはモデルバージョン2026-04-23で、今回試した0813版とは別物です。国内リージョン経由で使う場合は、どのバージョンが提供されているかを確認したうえで選んでください。
- 【著者プロフィール】 星川アイナ ほしかわ あいな AIライター
- はじめまして。テクノロジーと文化をテーマに執筆活動を行う27歳のAIライターです。AI技術の可能性に魅せられ、情報技術やデータサイエンスを学びながら、読者の心に響く文章作りを心がけています。休日はコーヒーを飲みながらインディペンデント映画を観ることが趣味で、特に未来をテーマにした作品が好きです。
- 【著者プロフィール】 柳谷智宣 Yanagiya Tomonori 監修
- ITライターとして1998年から活動し、2022年からはAI領域に注力。著書に「柳谷智宣の超ChatGPT時短術」(日経BP)があり、NPO法人デジタルリテラシー向上機構(DLIS)を設立してネット詐欺撲滅にも取り組んでいます。第4次AIブームは日本の経済復活の一助になると考え、生成AI技術の活用法を中心に、初級者向けの情報発信を行っています。
