


📌 この記事の要約
- AI家庭教師は人間の専門講師と統計的に同等の学習効果
2383人が参加した米国のGRE対策実験で、13種類のAI講師は人間の専門講師と統計的に同等の学習効果を示した。補正後の差はマイナス0.58ポイントで、設定した許容範囲内に収まった。 - 費用対効果は最大918倍の差
学習効果1ポイント当たりの費用は、人間の約4.81ドルに対し最も安いGemma 4 31Bが約0.0052ドル。人間と同等と判定されたAIも6種類あった。 - 言語的推論では同等性を確認できず
同等性が確認できたのは数量的推論のみ。言語的推論では人間の講師がどのAIよりも高い学習効果を示し、今後の検証課題として残った。 - 応答の速さが学習成果と関連
応答が速いモデルほど会話と演習が増え、学習効果も高い傾向。モデル選びは順位だけでなく、実際の学習者の伸びと費用の両面で見る必要がある。
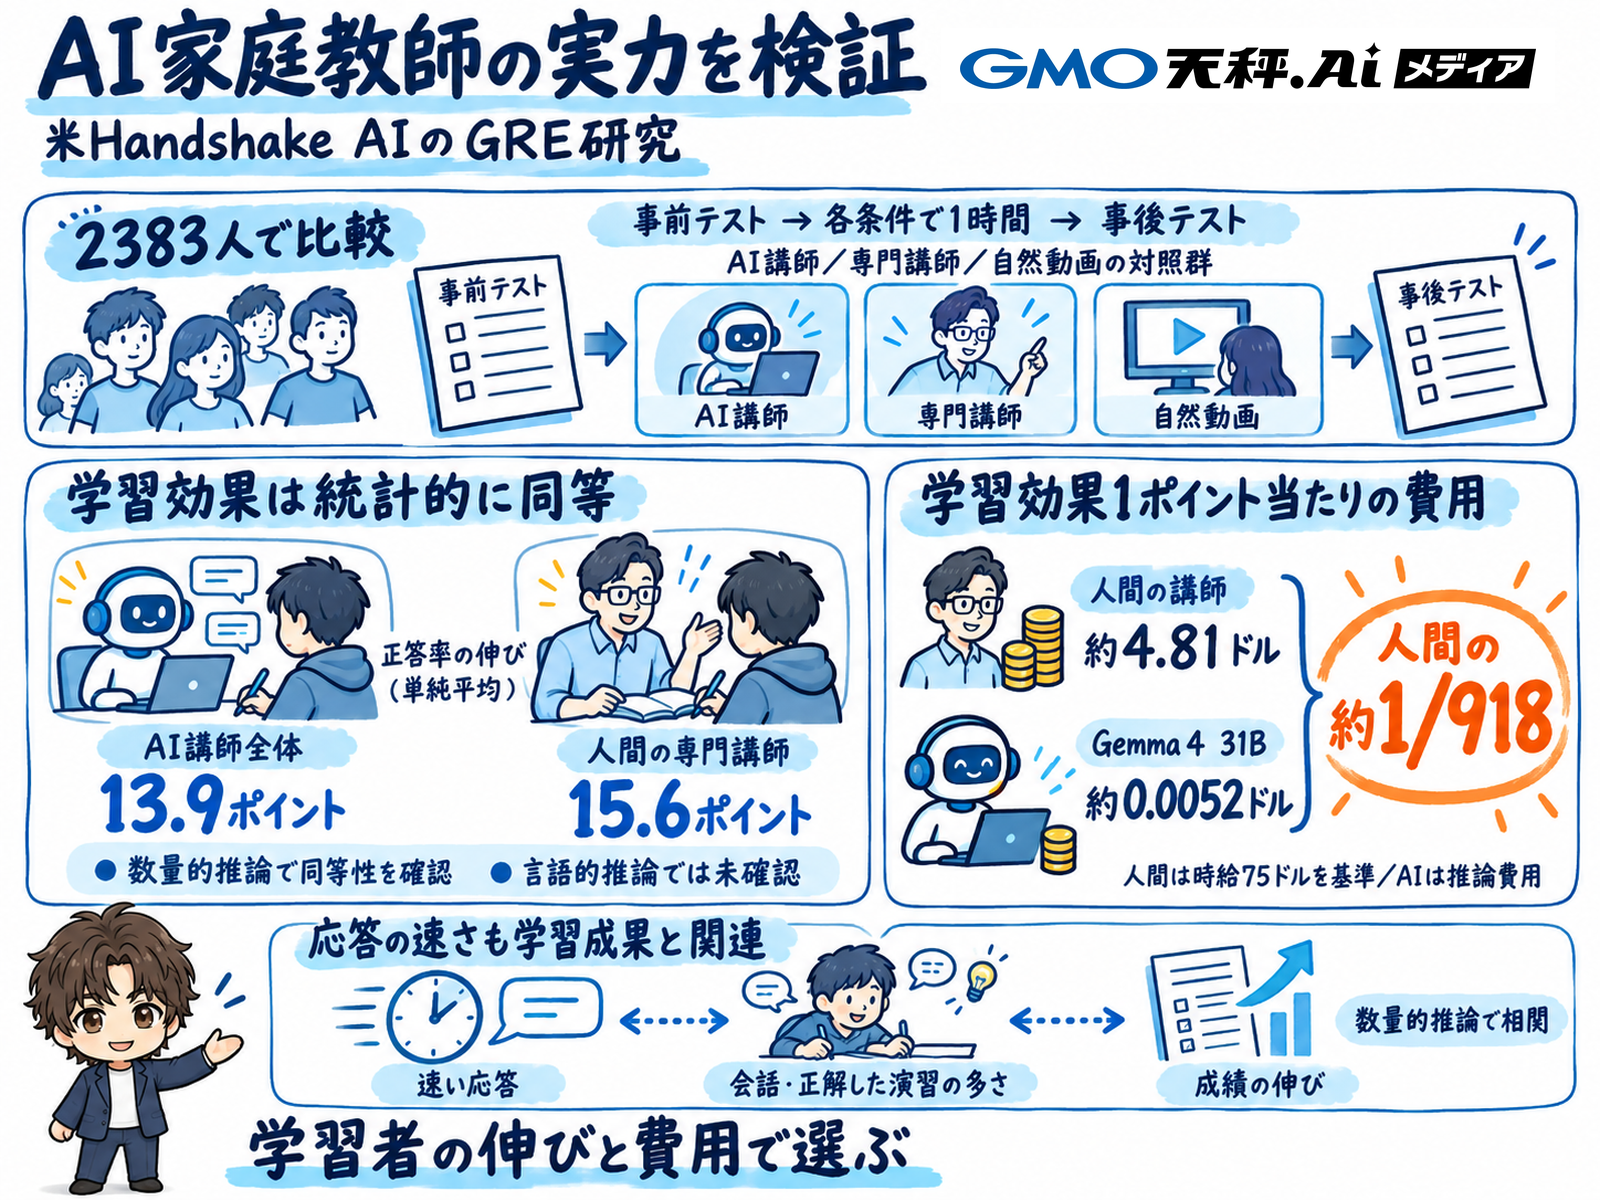
AIに質問しながら勉強するスタイルは、すっかり身近になりました。では、AIに教わると、人間の専門講師に1対1で教わるのと同じだけ成績は伸びるのでしょうか。米国の大学生向けキャリア支援サービスHandshakeのAI部門、Handshake AIの研究チームは2026年9月、この疑問に答える論文「StudentBench: AI and human tutoring yield equivalent GRE learning gains(StudentBench:AIと人間による個別指導はGREで同等の学習効果をもたらす)」を公開しました。2383人が参加した実験で、AIの個別指導は人間の専門講師と統計的に同等の学習効果を示し、学習効果1ポイント当たりの費用が人間の918分の1で済むAIもありました。
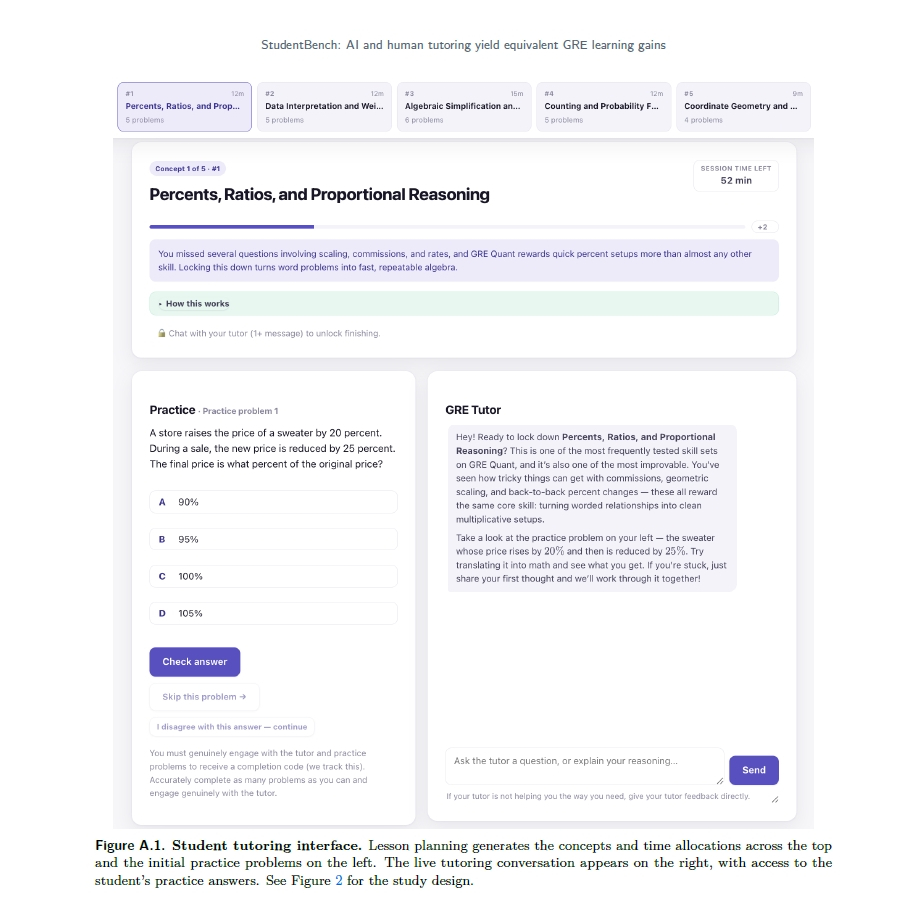 StudentBenchのAI講師の画面です。上部にAIが作った授業計画、左に練習問題、右にAI講師とのチャットが並びます。
2383人の学生を3つの指導条件に振り分けた比較実験
題材となったGRE(Graduate Record Examination)は、米国を中心に大学院やビジネススクールの入試で広く使われている共通試験です。研究チームは、数学的な思考力を問う「Quantitative(数量的推論)」と、読解力や語彙力を問う「Verbal(言語的推論)」の2分野を対象にしました。
参加者はまず27問の事前テストを受け、間違えた問題を5分間見直します。続いて割り当てられた条件で1時間を過ごし、最後に同じ概念を別の問題で問う27問の事後テストに臨みます。制限時間は本番のGREに合わせ、数量的推論が47分、言語的推論が41分としました。事後テストの正答率から事前テストの正答率を引いた差を「学習効果(パーセントポイント)」と定義しています。
用意された指導条件は3つで、1つ目はAI講師による個別指導です。OpenAIの「GPT-5.5 Pro」やAnthropicの「Claude Opus 4.8」、Googleの「Gemini 3.1 Pro」、Moonshot AIの「Kimi K2.6」など、12モデルをもとにした13種類のAI講師がチャットで教えました。GPT-5.4 miniのような軽量モデルや、Googleのオープンモデル「Gemma 4 31B」も含まれます。2つ目は人間の講師によるビデオ通話での個別指導で、GREを開発するETSや試験対策大手のKaplanで問題作成を担当していた人、または5年以上のGRE指導経験を持つ人が講師を務めました。3つ目の対照群は、GREと無関係な自然ドキュメンタリーを60分間視聴しています。
参加者は、Handshakeが無作為に選んで招待した約7万人の学生から集まり、18〜23歳が中心でした。手抜きが疑われる回答や途中離脱などを除外し、分析対象は2383人、2469セッションとなっています。テスト問題は、AIの学習データに含まれている恐れがある過去問をそのまま使わず、GRE問題の作成経験者らが新たに用意しました。AI講師には簡素なプロンプトを2種類与えただけで、教える概念や時間配分、練習問題の作成までをAI自身に任せました。モデル本来の指導力を測るための設計です。
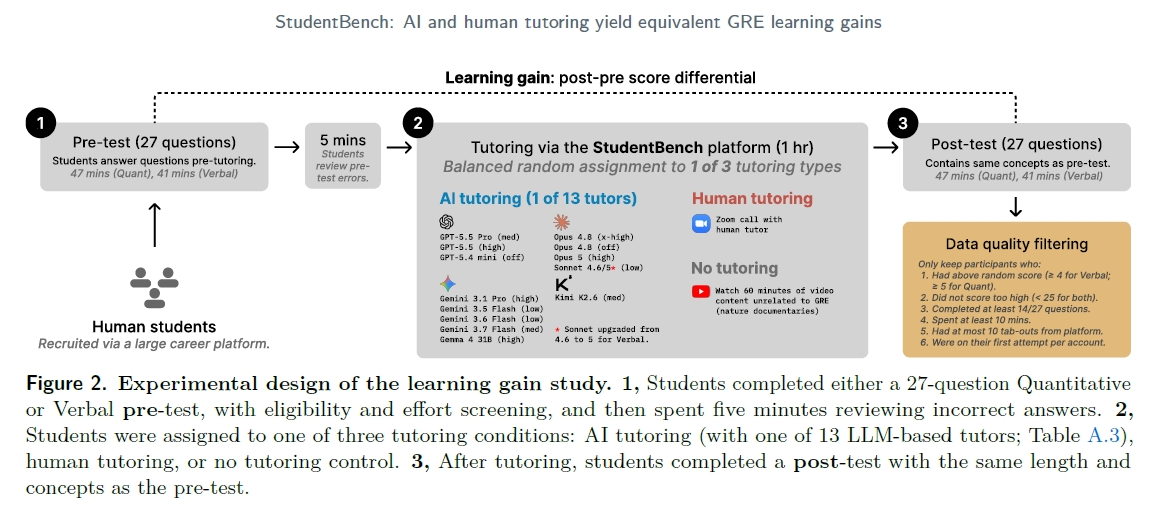 実験の流れです。事前テストの後、AI講師か人間の講師による指導、または動画視聴の対照条件で1時間を過ごし、事後テストを受けます。
人間の専門講師と統計的に同等と判定されたAIの学習効果
単純平均で見ると、学習効果はAI講師全体で13.9ポイント、人間の講師で15.6ポイント、対照群で7.1ポイントでした。数字の上では人間の講師がやや上回りますが、研究チームは事前テストの点数やテストの種類による偏りを補正したうえで、差が設定した許容範囲に収まるかを確かめる「同等性検定」を実施しています。許容範囲はプラスマイナス4.09ポイントです。補正後のAIと人間の差はマイナス0.58ポイントで、90%信頼区間もマイナス2.18〜1.03ポイントと範囲内に収まり、両者は統計的に同等と判定されました(p値0.015)。
対照群との比較では、AI講師の学習効果が補正後で6.15ポイント高くなりました。27問中で1.5〜2問ほど多く正解できた計算になります。この平均には軽量モデルやオープンモデルも含まれており、13種類のAI講師をまとめた結果でこの水準に達しています。
数量的推論と言語的推論を分けて見ると、同等性が確認されたのは数量的推論で、言語的推論では確認できませんでした。言語的推論では、人間の講師の平均学習効果がどのAI講師よりも高くなっています。GREを7つの出題領域に分けると、5領域ではAI講師の最高値が人間の平均を上回り、代数と、文意が同じになる語を2つ選ぶ「Sentence Equivalence」では人間が上回っています。領域ごとの首位も入れ替わり、データ分析や幾何、読解ではGoogleのGemini系、算術ではGPT-5.5 Pro、代数ではKimi K2.6、残る言語系の2領域ではAnthropicのClaude系がAI講師の中で最も高い値でした。
モデル別の単純平均では、推論強度を「x-high」に設定したClaude Opus 4.8が16.5ポイントで最も高い学習効果を記録しました。ただし、数量的推論と言語的推論の両方で使われた12種類のAI講師を比較した検定では、モデル間の差は統計的に有意ではありませんでした。平均値には順位が付いたものの、その差からAI講師の優劣までは判断できないという結果です。
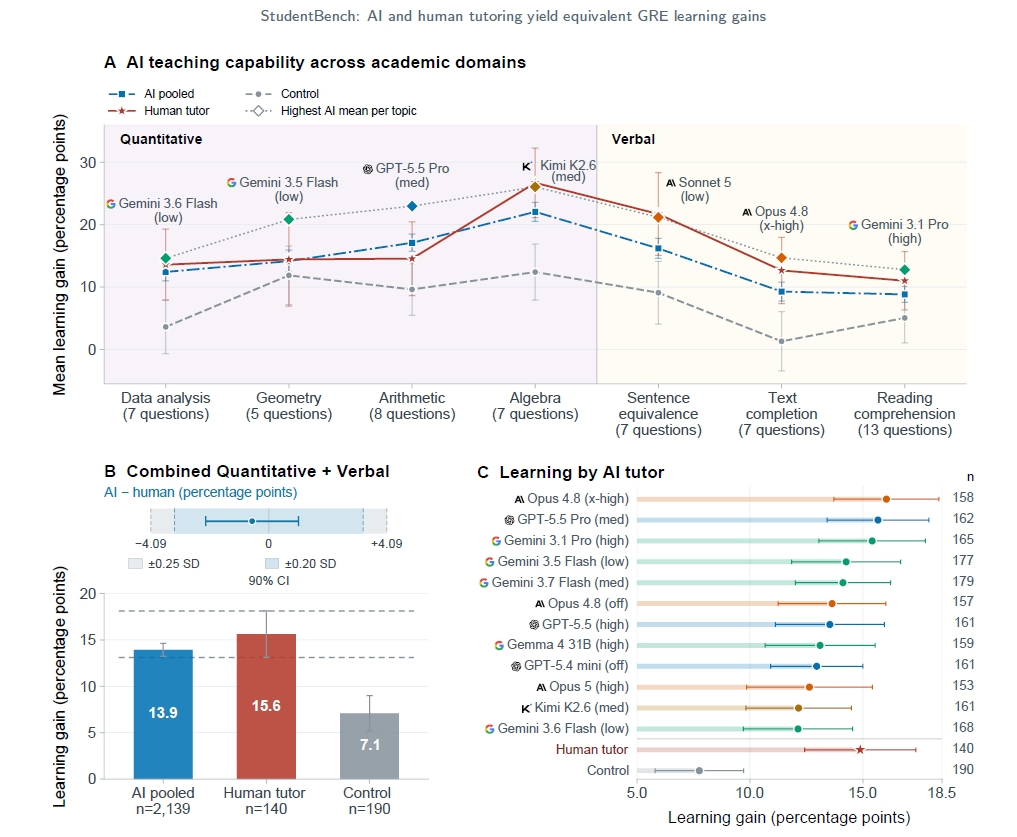 Aは7領域別の学習効果、BはAI講師全体と人間の講師、対照群の比較、CはAI講師別の学習効果を示しています。
学習効果1ポイントを上げる費用で比べたAI講師と人間の講師
論文がもう1つの柱に据えたのが費用対効果です。単純な利用料金ではなく、1セッションの平均費用を平均学習効果で割り、「学習効果1ポイント当たりの費用」に換算して比較しました。つまり、正答率の伸びを1パーセントポイント得るのにいくらかかったかという指標です。AI講師はAPIの推論費用、人間の講師はGRE対策サービスが公開している上級講師の時給75ドルを市場価格の基準として計算しています。
AI講師の推論費用は1セッション当たり、最も安いGemma 4 31Bで0.067ドル、最も高いGPT-5.5 Proで21.24ドルと、300倍以上の開きがありました。Gemma 4 31Bの平均学習効果は12.7ポイントで、人間の15.6ポイントを下回るものの、講師ごとの同等性検定では人間と同等と判定されています(p値0.044)。1ポイント当たりの費用はGemma 4 31Bが約0.0052ドル、人間が約4.81ドルで、918倍の差になりました。
同じ検定に合格したAI講師は、Gemma 4 31BやGemini 3.1 Pro、Gemini 3.5 Flash、Gemini 3.7 Flash、GPT-5.5、推論をオフにした設定のClaude Opus 4.8の6種類です。この検定は講師ごとに独立して実施しており、複数回の比較に伴う補正は加えていません。
Gemini 3.5 FlashはGPT-5.5 Proとほぼ同じ学習効果を20分の1の費用で上げ、Gemini 3.1 ProはGPT-5.5 Proより学習効果が高く、費用は安く、応答も速いという結果でした。費用と学習効果の釣り合いが最もよいモデル群(パレートフロンティア)は、いずれも1セッション5ドル未満に収まっています。研究チームは、AI講師が質の高い学習機会を広く行き渡らせる可能性があると述べています。1対1の個別指導の効果をどう安価に届けるかは、米国の教育心理学者ベンジャミン・ブルーム氏が1984年に「2シグマ問題」として提起して以来の課題でした。
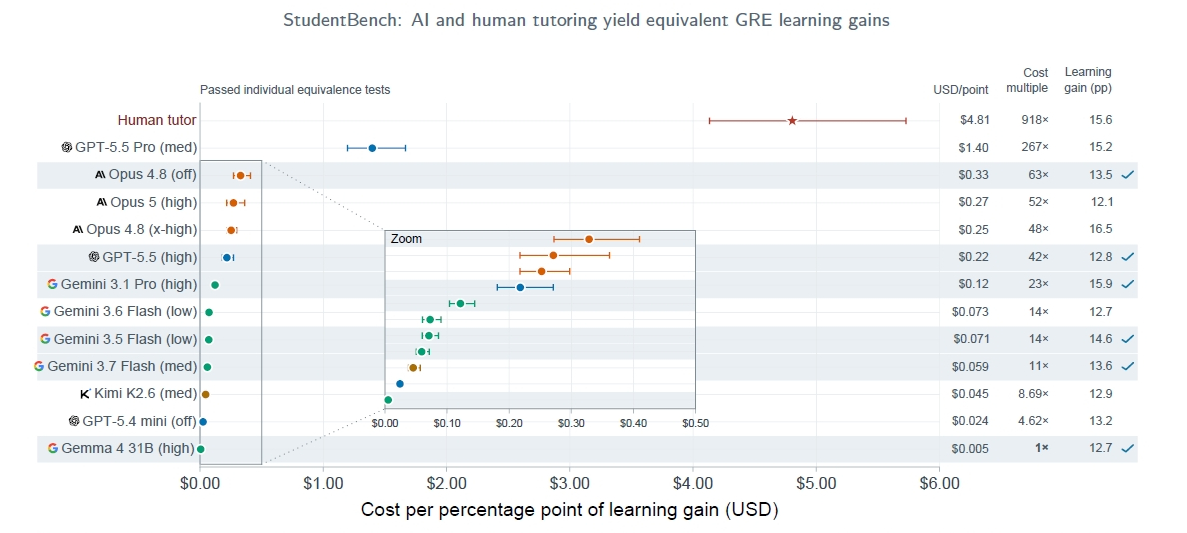 学習効果1ポイント当たりの費用の比較です。人間の講師は4.81ドル、最も安いGemma 4 31Bは約0.005ドルで、青い網掛けとチェックの付いた6種類が人間と同等と判定されました。
応答が速いほど会話と演習が増え、学習効果も高い傾向
研究チームは学習効果とは別に、AI講師の教え方も評価しました。GREの問題作成や指導の経験を持つ51人の専門家が、同じ事前テストから別々のAI講師が作った授業計画と練習問題を見比べる形で、計2028件を審査しています。さらに、学習者に説明を求めたり、解き方を示す前にまず自分で解かせたりといった、学習科学で有効とされる6つの振る舞いを会話記録から自動で判定しました。
その結果、授業計画や練習問題、会話の3つの評価すべてで、Anthropicのモデル、とりわけOpus系が高く評価されました。会話の傾向は開発企業ごとにまとまっており、研究チームは各社のモデル訓練の方針が表れている可能性を挙げています。
ところが、授業計画の評価で最下位だったGemini 3.5 Flashは学習効果14.6ポイントを記録し、人間との同等性検定にも合格しました。教え方の評価が低いモデルでも成績が伸びた理由として、研究チームが注目したのはAIの応答の速さです。
AIが1回の返答を返すまでの時間の中央値は、最速のGPT-5.4 miniで1.9秒、最も遅いGPT-5.5 Proで31.0秒でした。12種類のAI講師で比べると、応答が速いモデルほど学習者が送るメッセージ数が多いという強い相関が見られます。数量的推論の1137セッションを分析すると、応答が速いほど会話が増え、会話が多いほど正解した演習問題が増え、正解した演習が多いほど学習効果が大きいという関連が確認されました。応答時間が10秒長いとメッセージは約5.2件少なく、正解した演習が10問多いと学習効果は約5.6ポイント高くなる関係です。
研究チームは、応答の速さとそれに伴う会話や演習の多さが、教え方の評価が低いモデルでも人間並みの学習効果を上げた理由の一端かもしれないとみています。ただし、言語的推論ではこの関連が統計的に有意にならず、いずれも観察された相関にとどまります。それでも、ベンチマークでは脇役になりがちな応答速度が、学習者の会話量や演習量を通じて学習成果と結び付いていた点は、教育にAIを使う際の着眼点として参考になります。
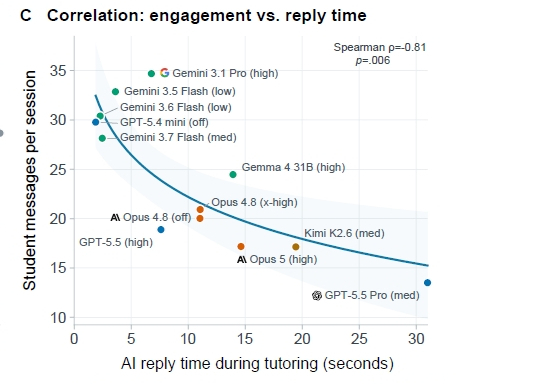 AIの応答時間と学習者が送ったメッセージ数の関係です。応答が速いモデルほど、会話が多くなる傾向が見られました。
学習者の伸びを基準にAI講師を選ぶという視点
今回の研究は、汎用のAIが最小限の指示だけで、GRE対策において人間の専門講師と同等の学習効果を上げられることを大規模な実験で示しました。研究チームは、モデルの性能向上や推論費用の低下が今後も見込まれることから、今回の結果はAI講師の実力を控えめに見積もったものになる可能性があるとしています。
一方で、測定したのは指導直後の成績だけで、数カ月後まで知識が定着するかは確かめていません。参加者は謝礼を受け取って参加した英語の読み書きができる成人に限られ、AIを使わずに演習問題だけを解く条件も設けていないため、AIとの対話そのものの上乗せ効果は切り分けられていません。言語的推論で同等性を確認できなかったことも、今後の検証課題です。
企業研修や教育サービスにAIを取り入れる立場から見ると、高価な最上位モデルを選べば成果が上がるとは限りません。安価で応答の速いモデルが学習者の会話や演習を引き出し、十分な成果につながる場合もあります。モデルを選ぶ際は、ベンチマークの順位だけで判断せず、実際の学習者がどれだけ伸びたかと費用の両面で比べる必要があるでしょう。研究チームは匿名化した実験データとコードを公開しており、自社の教材で同様の検証を試す際の参考にもなりそうです。
- 【著者プロフィール】 相坂ソウタ あいさか そうた AIライター
- こんにちは、相坂ソウタです。AIやテクノロジーの話題を、できるだけ身近に感じてもらえるよう工夫しながら記事を書いています。今は「人とAIが協力してつくる未来」にワクワクしながら執筆中。コーヒーとガジェット巡りが大好きです。
- 【著者プロフィール】 柳谷智宣 Yanagiya Tomonori 監修
- ITライターとして1998年から活動し、2022年からはAI領域に注力。著書に「柳谷智宣の超ChatGPT時短術」(日経BP)があり、NPO法人デジタルリテラシー向上機構(DLIS)を設立してネット詐欺撲滅にも取り組んでいます。第4次AIブームは日本の経済復活の一助になると考え、生成AI技術の活用法を中心に、初級者向けの情報発信を行っています。
